何が起きたか
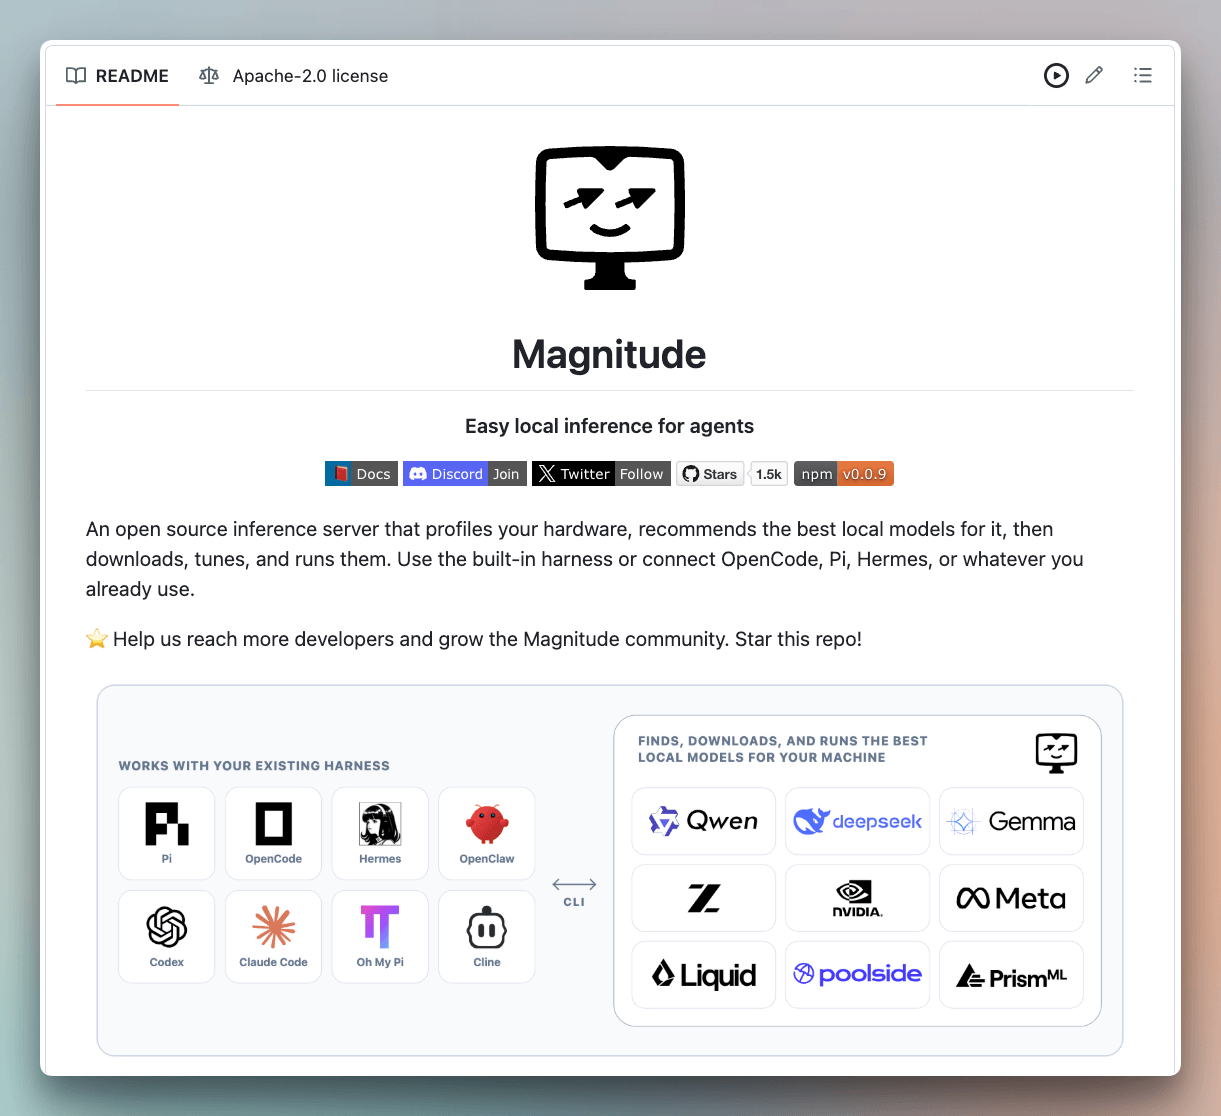
オープンソースの推論サーバー「Magnitude」がハードウェアをプロファイリングし、最適なモデル構成を推奨する。16GBのApple M5でのテストでは、Gemma 4 E2Bを4ビットQATで提案し、毎秒43~51トークンと予測した。
なぜ重要か
エージェント業務はチャットより遅く、許容度も低い。長い会話履歴が蓄積し、高い精度が求められるためだ。Magnitudeは既存ツールがユーザーに委ねている「どのモデルを動かすか」という問題を解決し、時間の節約とミスの回避につながる。国内でローカルAI活用を模索する技術者が、自前ハードの選定や運用負担を軽減できる可能性がある。
注目点
生成速度を左右するメモリ帯域幅を測定し、PiやCodexなどのハーネス向けのセットアップも担う。バランス型・最重視型・最速型の構成も選べる。
こういう要約が、毎朝あなたのメールに届きます。
この記事は、ローカルモデル向けツールがチャット用に設計されており、エージェント業務には向いていないと主張する。エージェント利用では会話履歴が増え、メモリ帯域幅が速度を制限し、精度が極めて重要になる。Magnitudeはハードウェアのプロファイリングでこの課題に応える。
メモリ帯域幅を測定して生成速度を予測し、実環境の挙動を反映するためテスト推論も実行する。その上で、モデル・圧縮・コンテキストサイズ・予想速度帯を含む完全な構成を、バランス型・最重視型・最速型の順で提示する。
Apple M5でのテストでは、Gemma 4 E2Bを4ビットQATでバランス型として選び、4.6GBで50Kコンテキストを保持し、毎秒43~51トークンと予測した。このツールは並行処理や投機的デコードも自動で扱う。実際にWi-Fiを切ったテストでは、クライアントファイルに個人情報がないことを正確に特定し、完全にローカルで動作したことを確認した。
たとえば、いま届くならこの3本です
AIが要約して、あなたの選んだトピックだけを1日1通。LINE・Email・Slackで届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。Q&Aはこのページに公開され、他の読者も読めます。
DIGITIMESの報道によると、サンノゼはエネルギーが豊富で関税の影響を抑えたインフラを整備し、物理AI(ロボットなど実世界で動作するAI)の拠点を目指している
エヌビディアのジェンスン・フアンCEOは、OpenAIが最新モデル「GPT-6 Astra」を発表したことを受け、汎用人工知能(AGI)が到来したと述べた
サウジアラビア政府系AI企業HUMAINは、CEOタレク・アミン氏の下でオープンAIモデルの中立的ハブとしての地位を確立し、米国・中国に続くAI超大国を目指している
アリババの研究部門がQwen-Drive 1.0を公開
ロンドン拠点のAIスタートアップ、Ineffable Intelligenceは、元Google DeepMind研究者のDavid Silver氏が設立した企業で、2019年のAlphaStar画期的成果に携わった元D…
開発者がChatGPTに対し、同じリモートワークのシナリオを被験者の性別と役職だけ変えて判定させた