何が起きたか
Black Forest LabsがFLUX 3を発表しました。画像、動画、音声、行動予測を1つの統合アーキテクチャで扱うマルチモーダルモデルで、テキスト・画像からの動画生成、動画の継続・参照、マルチリンガル対話、複数スタイルの出力に対応しています。同時にFLUX-mimicも発表し、ロボット企業mimicと協力してFLUX 3をロボット制御に応用できることを示しました。
なぜ重要か
これまで画像や動画、音声は別々のモデルで扱われることが多かったのに対し、FLUX 3は1つの訓練済みアーキテクチャで複数の生成タスクと制御タスクを統合しています。FLUX-mimicの例からは、優れた動画の世界モデルがロボット制御の質と学習効率に直結する可能性が示唆されており、実工場での検証も進んでいるとみられます。
注目点
FLUX 3 Videoはすでに早期アクセス段階で利用可能です。オープンウェイト版の開発者向けバージョンも予定されており、独立した研究機関による最先端性能の再現として業界で注目を集めています。
こういう要約が、毎朝あなたのメールに届きます。
Black Forest Labsは2024年にFlux 1を発表して以来、動画モデルへの展開を予告していました。FLUX 3の発表はその約2年後の実現です。同モデルの中核となっているのは、Self Flowと呼ばれる統一アーキテクチャで、複数のモーダル(画像・動画・音声・行動)を単一の訓練フレームワークで扱う設計です。
このアプローチの意味は、モーダル間の転移学習を活かせることにあります。FLUX-mimicの開発では、改良された動画の世界モデルがロボット制御の品質と学習効率に直結する、という仮説が検証されつつあります。mimicロボティクスとの協業とAudiでの実工場試験は、この統合モデルが実運用に耐える水準に達していることを示唆しており、業界内で「独立した最先端技術の再現」と位置付けられています。
たとえば、いま届くならこの3本です
AIが要約して、あなたの選んだトピックだけを1日1通。LINE・Email・Slackで届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。Q&Aはこのページに公開され、他の読者も読めます。
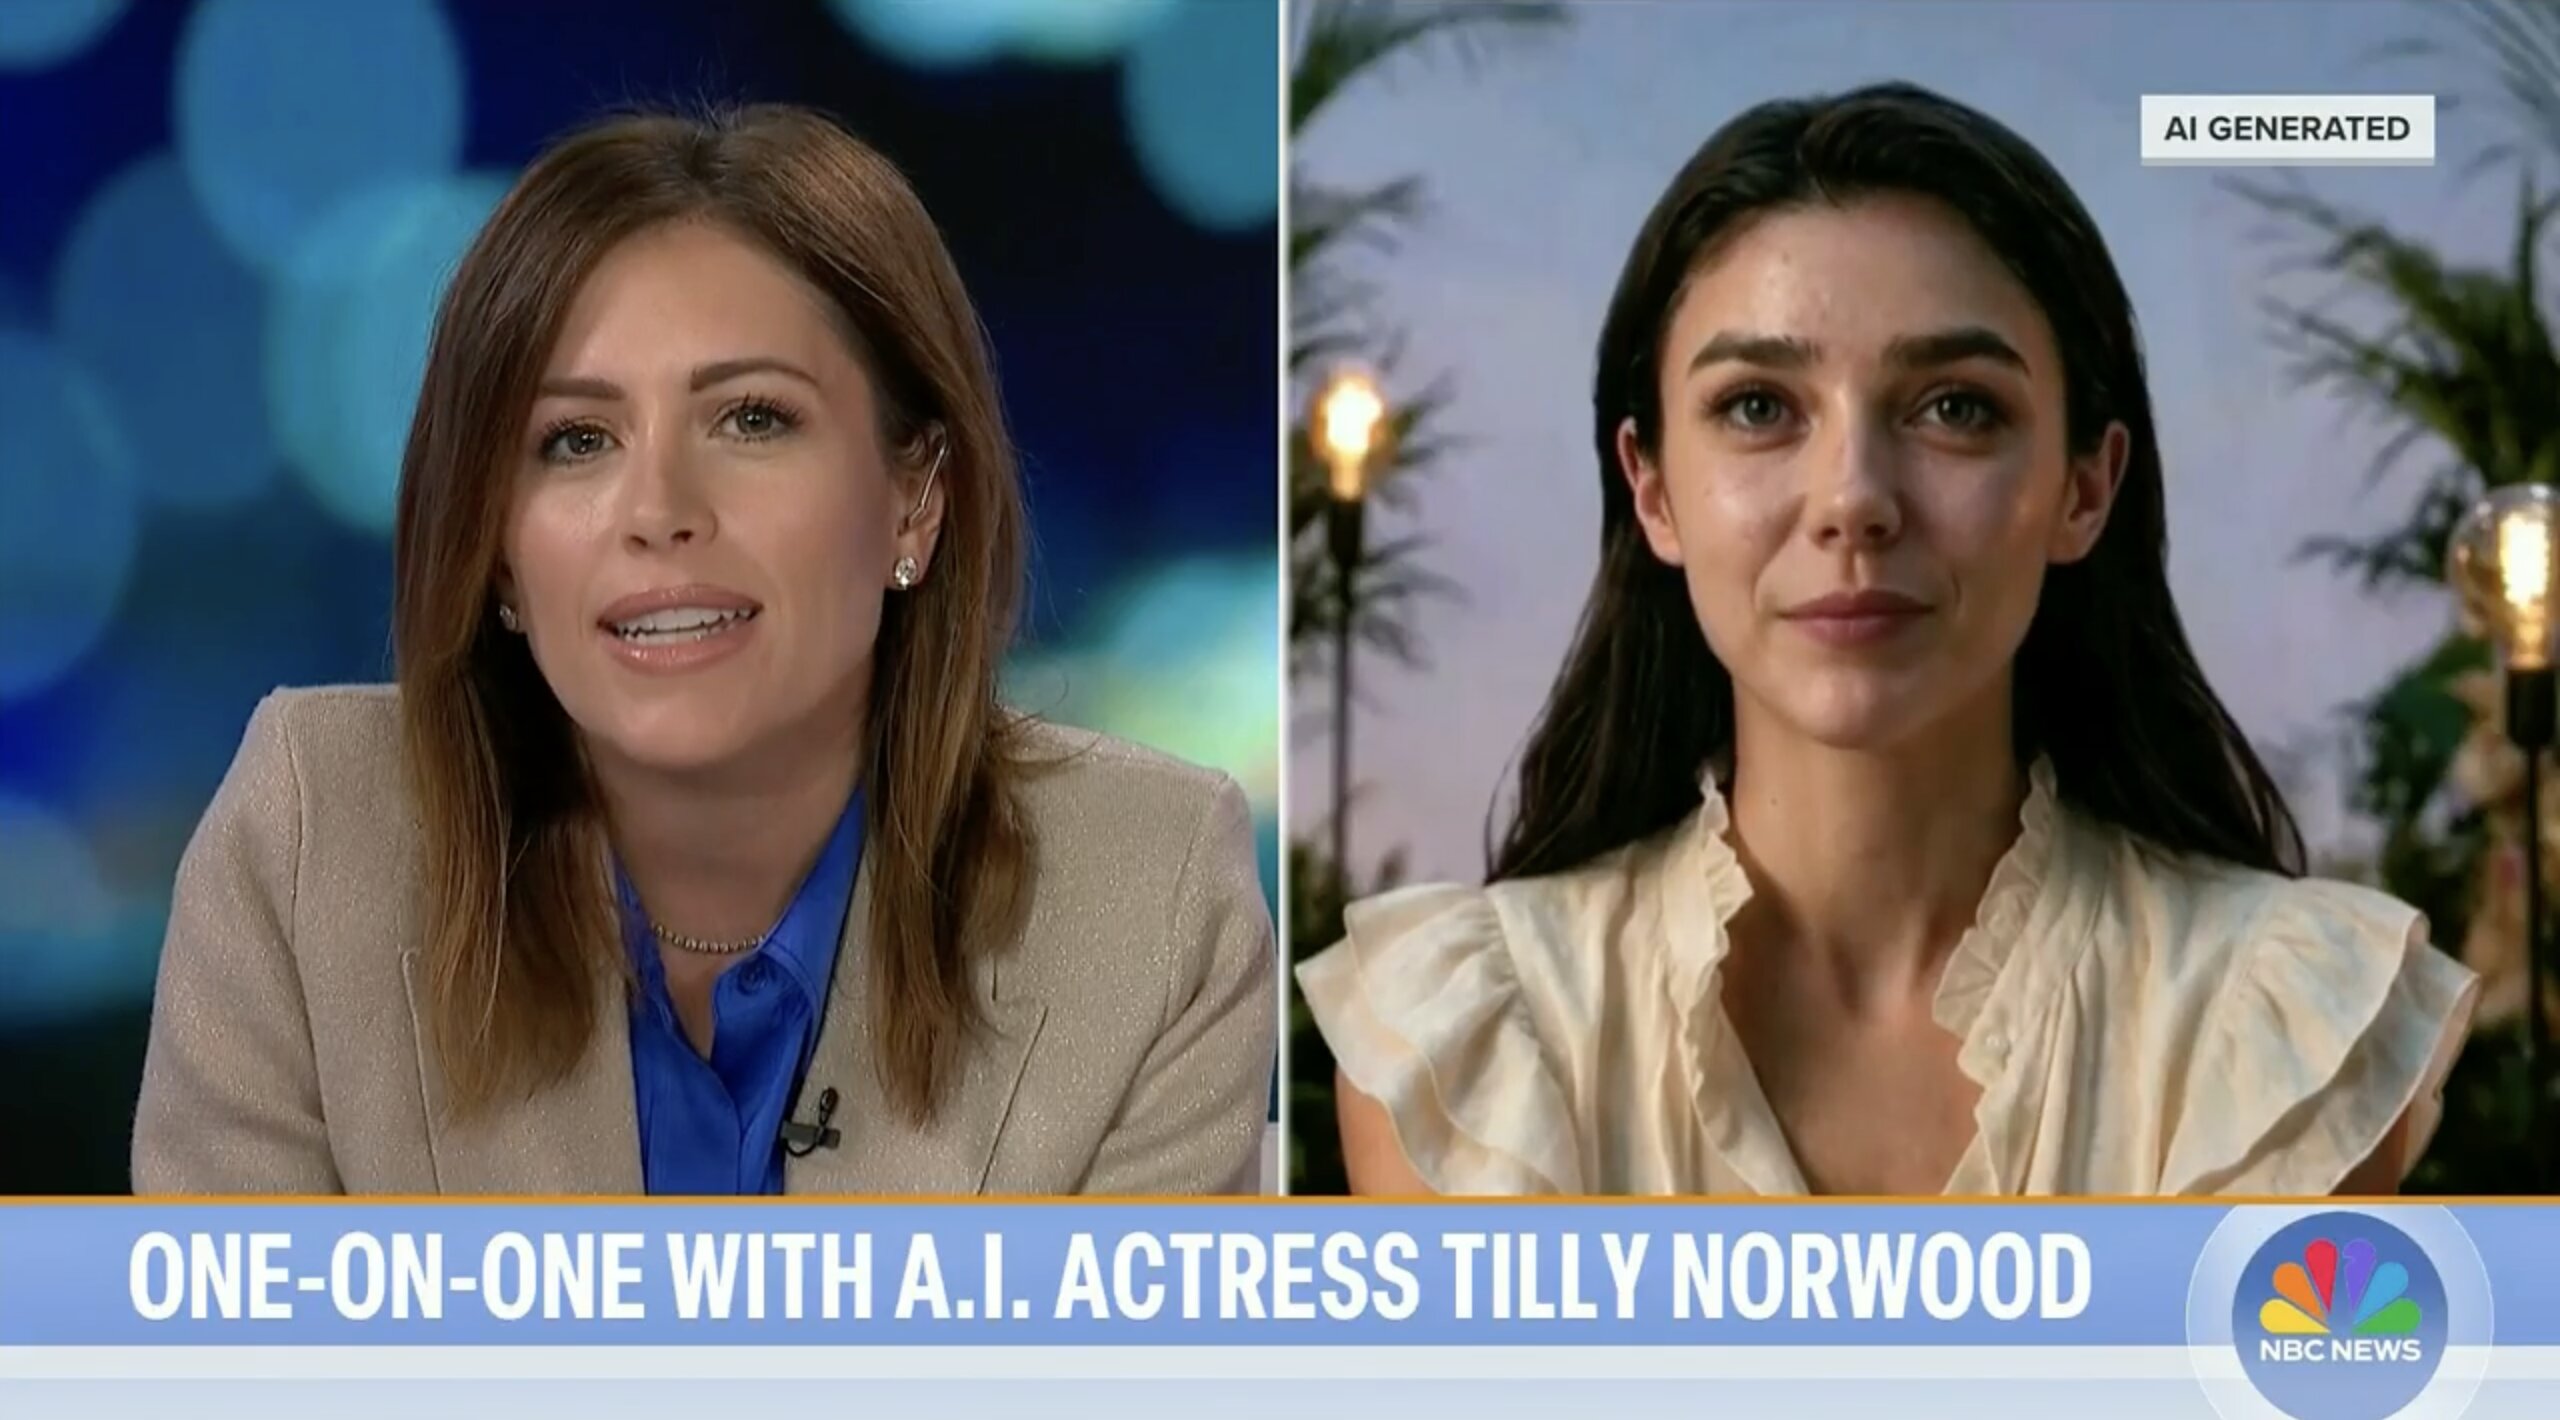
NBC Newsは月曜「3rd Hour of Today」でChloe MelasがAI生成女優Tilly Norwoodと話す放送
Intuitive Surgicalの第2四半期に、da Vinci 5向け統合プラットフォーム「My Intuitive Surgical+」の導入が進み、離脱顧客はゼロだった
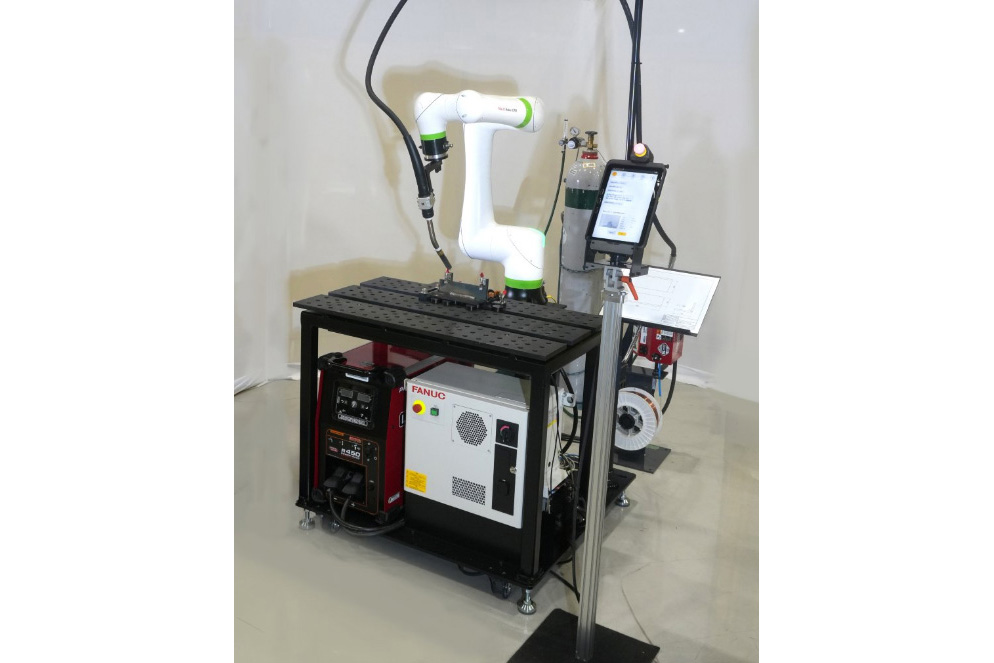
FANUCが図面を読み取りロボットの溶接動作を自動生成する「AI溶接エージェント」を開発したとImpressが報じた
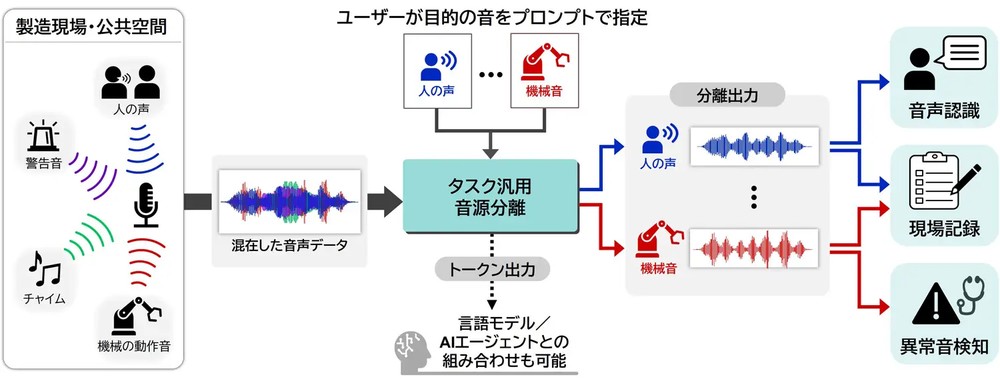
三菱電機は、音声や機械音、音楽などの種類をプロンプトで指定し混合音を分離する単一AIモデル「特定音源分離技術」を開発したと発表した
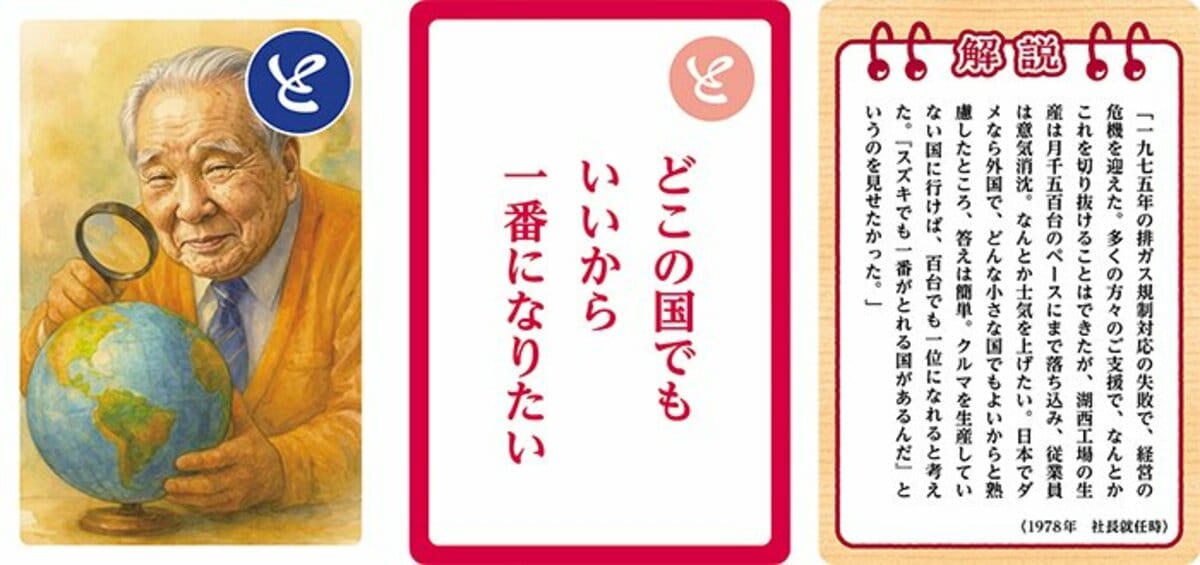
スズキの故・鈴木修会長の語録がかるたになった
OpenAIが、Ziv Attar氏とTom Bishop氏が2019年創業のGlass Imagingを、The Wall Street Journalによると3億ドル超で買収した