何が起きたか
Google DeepMindがArtificial Analysisと共同でマルチモーダル知識エージェントベンチマークを公開。
なぜ重要か
自社のGeminiが2位となる評価をGoogleが共同構築した点に、Crypto Briefingは独立標準としての地位確立への疑問を呈している。
誰に効くかエージェントモデルを評価するAI調達チームや企業購買担当は、リーダーボード順位を慎重に扱うべきだ。Crypto Briefingは分野の細分化により順位が単一の購買判断材料として信頼できないと警告している。
こういう要約が、毎朝あなたのメールに届きます。
このベンチマークは空白を埋めるために作られた。既存のエージェントテストはテキスト偏重すぎる。Googleのブログ執筆者Rohan Doshi氏とBen Caine氏が述べるように、ほとんどの知識労働ベンチマークは画像やページレイアウトを見ることなくテキストだけで解けてしまうが、日常の専門業務は大きく異なる。MKAは10分野・83職種にわたる200タスクを収録し、各タスクは熟練専門家が完了に3〜8時間かかる多段階プロジェクトを反映している。
全モデルは同一のオープンソースエージェントハーネスStirrup内で、共通のツールセットとターン予算の下で実行される。それでも被験モデルの効率差は極端で、各タスク完了に平均30〜130ターンを使用した。自動評価器とドメイン専門家の96%一致は採点への一定の信頼を与えるが、非公開のタスクセットとGoogleの共同作成という立場は、Crypto Briefingが指摘した独立性への疑問を残す。
この結果はGoogleを異例の立場に置く。Gemini 4 Carbonは自ら設計に加わったベンチマークでClaude Fable 5.2に次ぐ2位となった。投稿はGemini 4 Carbonを品質で上回ったモデル名を明示しておらず、本日トラッカー上のGoogle関連通知としては3件目で、Gemini 4 Carbon APIの広範な展開に続くものとなる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
株式会社Uravationは、ExcelとWordのテンプレートを収録した28ページの無料PDFキットを公開した
Alibaba Cloudは11月11日、Qwen4を発表し、Token PlanやQwenWork、Qoder、Qwen APP、QwenStudioなどでQwen4-Maxのプレビューを提供している
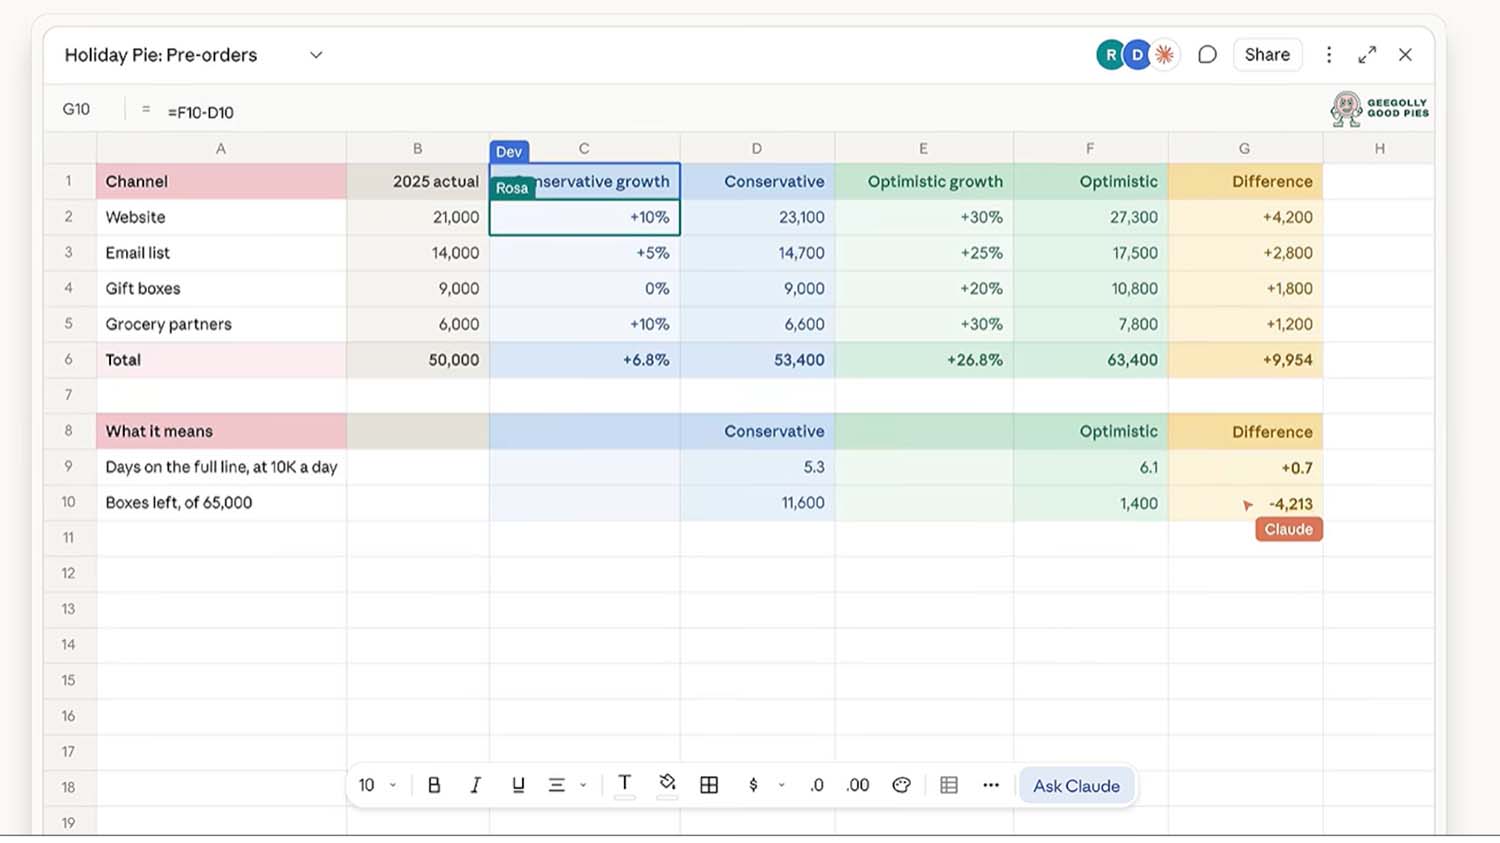
AnthropicはClaude Sheets、Claude Whiteboards、Claude Dataを発表した
Mercor.io Corp.が評価額200億ドルで7億5000万ドルを調達
Coshipが2026年10月11日に公開したブログ記事で、AIモデルを到達難易度に基づく4段階に分類し、絶対的フロンティア層に入るのはAnthropic、OpenAI、Googleの3社のみとした
上流のテーブル定義変更後にモデルが静かに劣化した失敗を振り返り、アルゴリズム本よりライフサイクル本を先に読むよう勧めている