何が起きたか
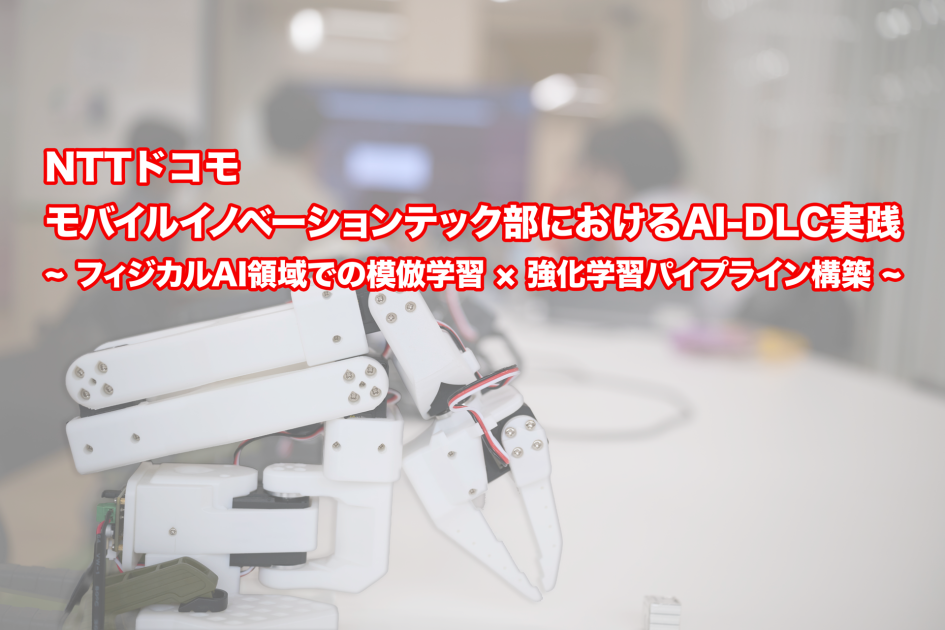
NTTドコモのMIT部がAWSのAI-DLC Train The Trainerに参加し、模倣学習(IL)を強化学習(RL)で洗練させるロボットアームのパイプラインをRPD手法で3日で構築した。
なぜ重要か
Inceptionフェーズだけで11件の不整合を洗い出し、30件以上の構造化文書を生成した。設計が不確実で知識が散在するMLプロジェクトの手戻りをAI-DLCが削減できる可能性を示す。
注目点
並行チーム開発でこの枠組みが機能するかは未検証——記事の後半ではTeam PinkとTeam Blueがパイプラインを並走させた模様を報告する。
誰に効くかこれは論文を動くパイプラインに変える必要があるML・ロボティクス研究チーム、特に強化学習とシミュレータ作業に不慣れなチームに響く。また、場当たり的なコーディングと構造化されたAI支援ワークフローを天秤にかけるエンジニアリングリーダーにも関係する。
こういう要約が、毎朝あなたのメールに届きます。
背景にあるのは応用機械学習でよくある悩みだ。研究論文がそのまま動くパイプラインになることはほとんどない。前提や暗黙の条件のわずかな違いは実装後に初めて表面化し、失敗した実験は高くつく。実世界で動作するAI(フィジカルAI)に取り組むNTTドコモのチームはまさにこれに直面していた——模倣学習モデルは10デモで成功率10%、データ増幅で45%まで上がったが、その後頭打ちになった。
チームはパイプラインをコーディング作業ではなく、AWSのAI-DLC枠組みで構造化すべき製品として扱うことを選んだ。これは計画の中心にAIを置きつつ、意思決定は人間が担う。Inceptionフェーズでは論文やドメイン資料をKiroツールに投入し、その周りでモブ形式で作業した。AIレビューはコードを書く前に、checkpoint形式の不一致、12次元対28次元の入力次元の衝突、アクションスケーリングの不整合といった問題を指摘した——まさにML作業で「コードは動くが出力が間違っている」として後から現れがちな類のエラーだ。
ここまでで示されたのは第1回、つまりInceptionフェーズであり、最終的な学習結果ではない。本当の試練はConstructionフェーズだ。そこでは2チームが並行して走り、一方は当初のスコープを放棄してAI-DLCの枠内で方向転換したと報じられている。構造化文書のアプローチが、調整の改善だけでなくMLの成果そのものを実際に高めるのか——第2回が答える構えのようだ。
たとえば、いま届くならこの3本です
AIが要約して、あなたの選んだトピックだけを1日1通。LINE・Email・Slackで届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。Q&Aはこのページに公開され、他の読者も読めます。
Twist BioscienceがEli LillyのAI駆動型TuneLab創薬プラットフォームに抗体特性評価データサービスを提供することで合意し、株価は7.1%上昇した
2026会計年度にAehrは5000万ドルの売上高(15.2%減)、710万ドルの純損失、マイナス540万ドルのフリーキャッシュフローを計上、KLAは136億ドルの売上高(11.7%増)、48億ドルの純利益、38億ドルの…
Yahoo FinanceがNvidiaとMicronを比較し、2027年により良いAI株としてMicronを選んだ