何が起きたか
TrueForgeとJevを使ったフォローアップエージェントが、40件のリクエストで判断コスト150分の1ながらOpusと同等の精度を達成。Opusのレビューが5件の誤マッチを検出した。
なぜ重要か
エージェントの意思決定を、確信度スコア付きの構造化された選択肢を返す専用モデルに任せられ、候補リストからの絞り込みコストを削減できる。
こういう要約が、毎朝あなたのメールに届きます。
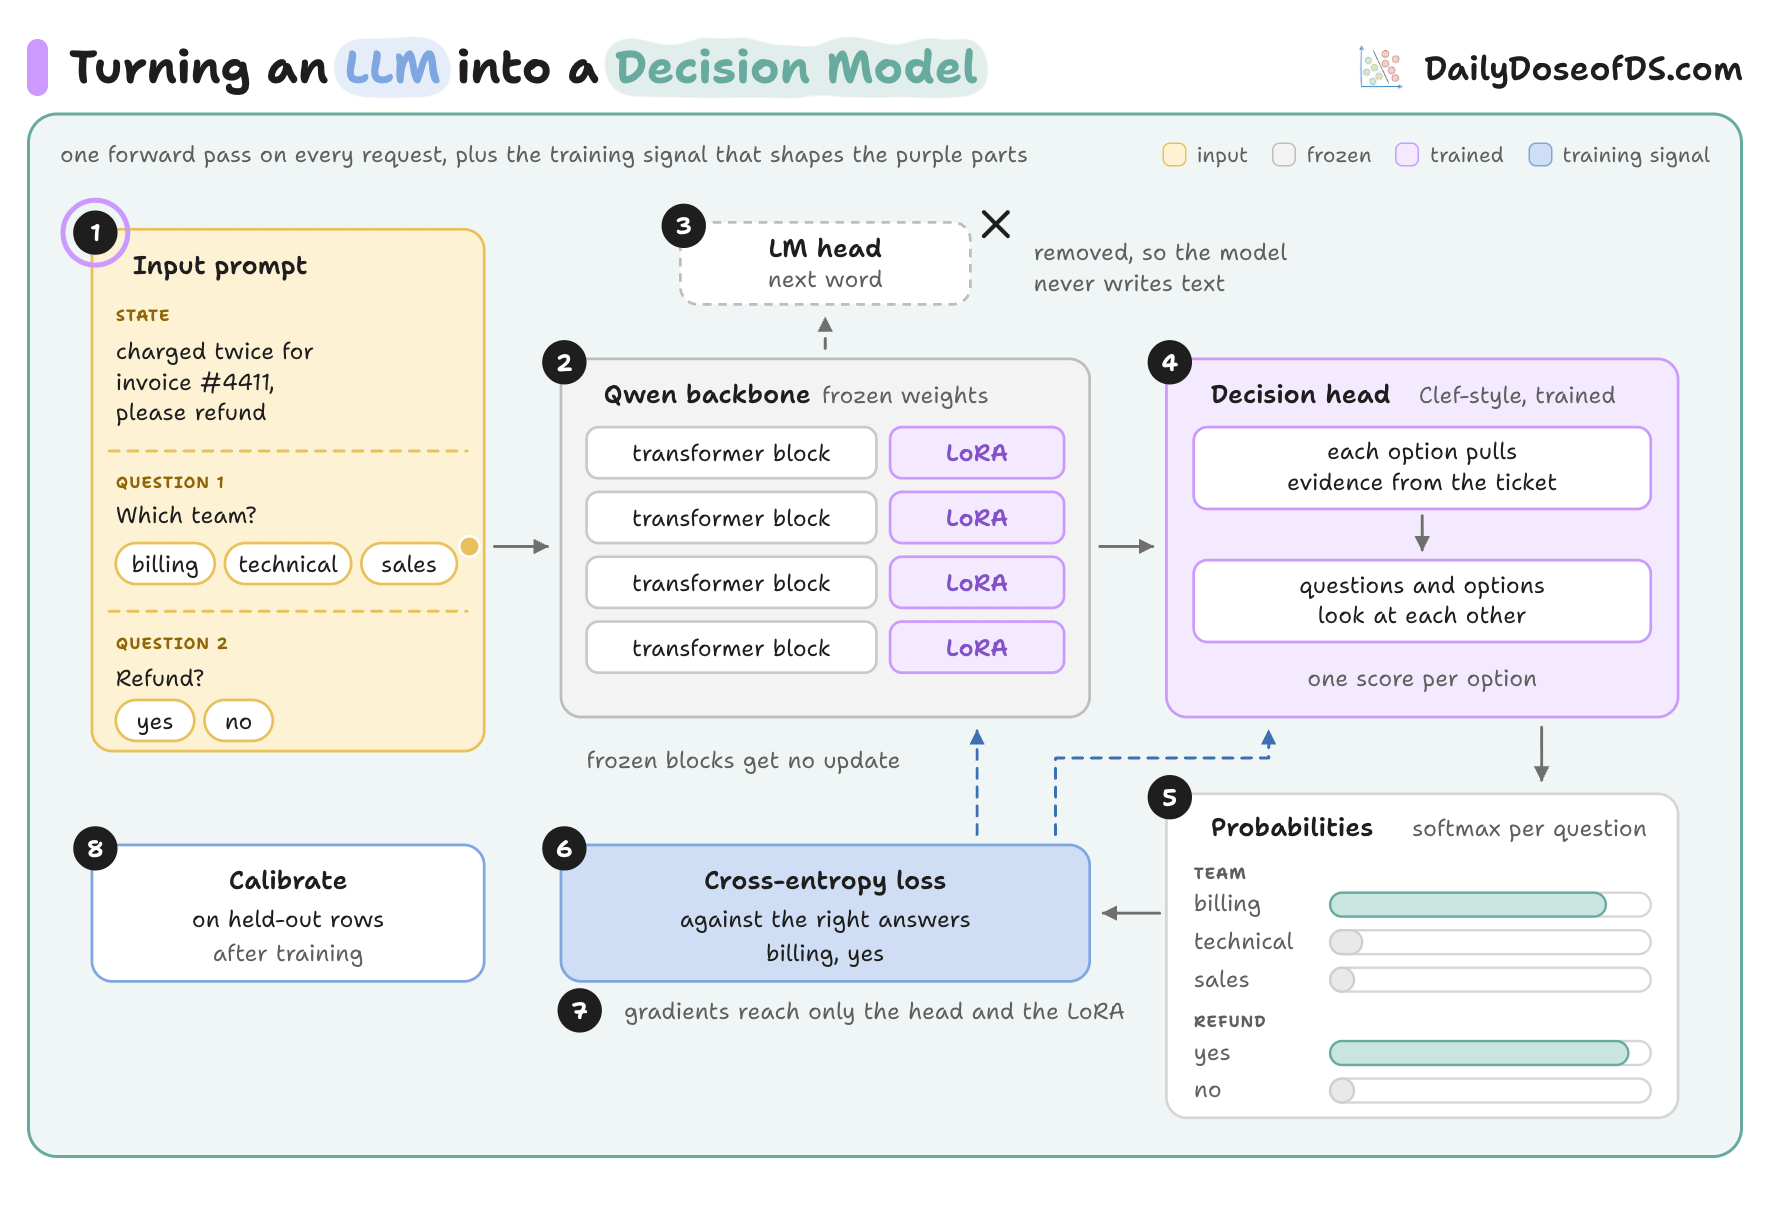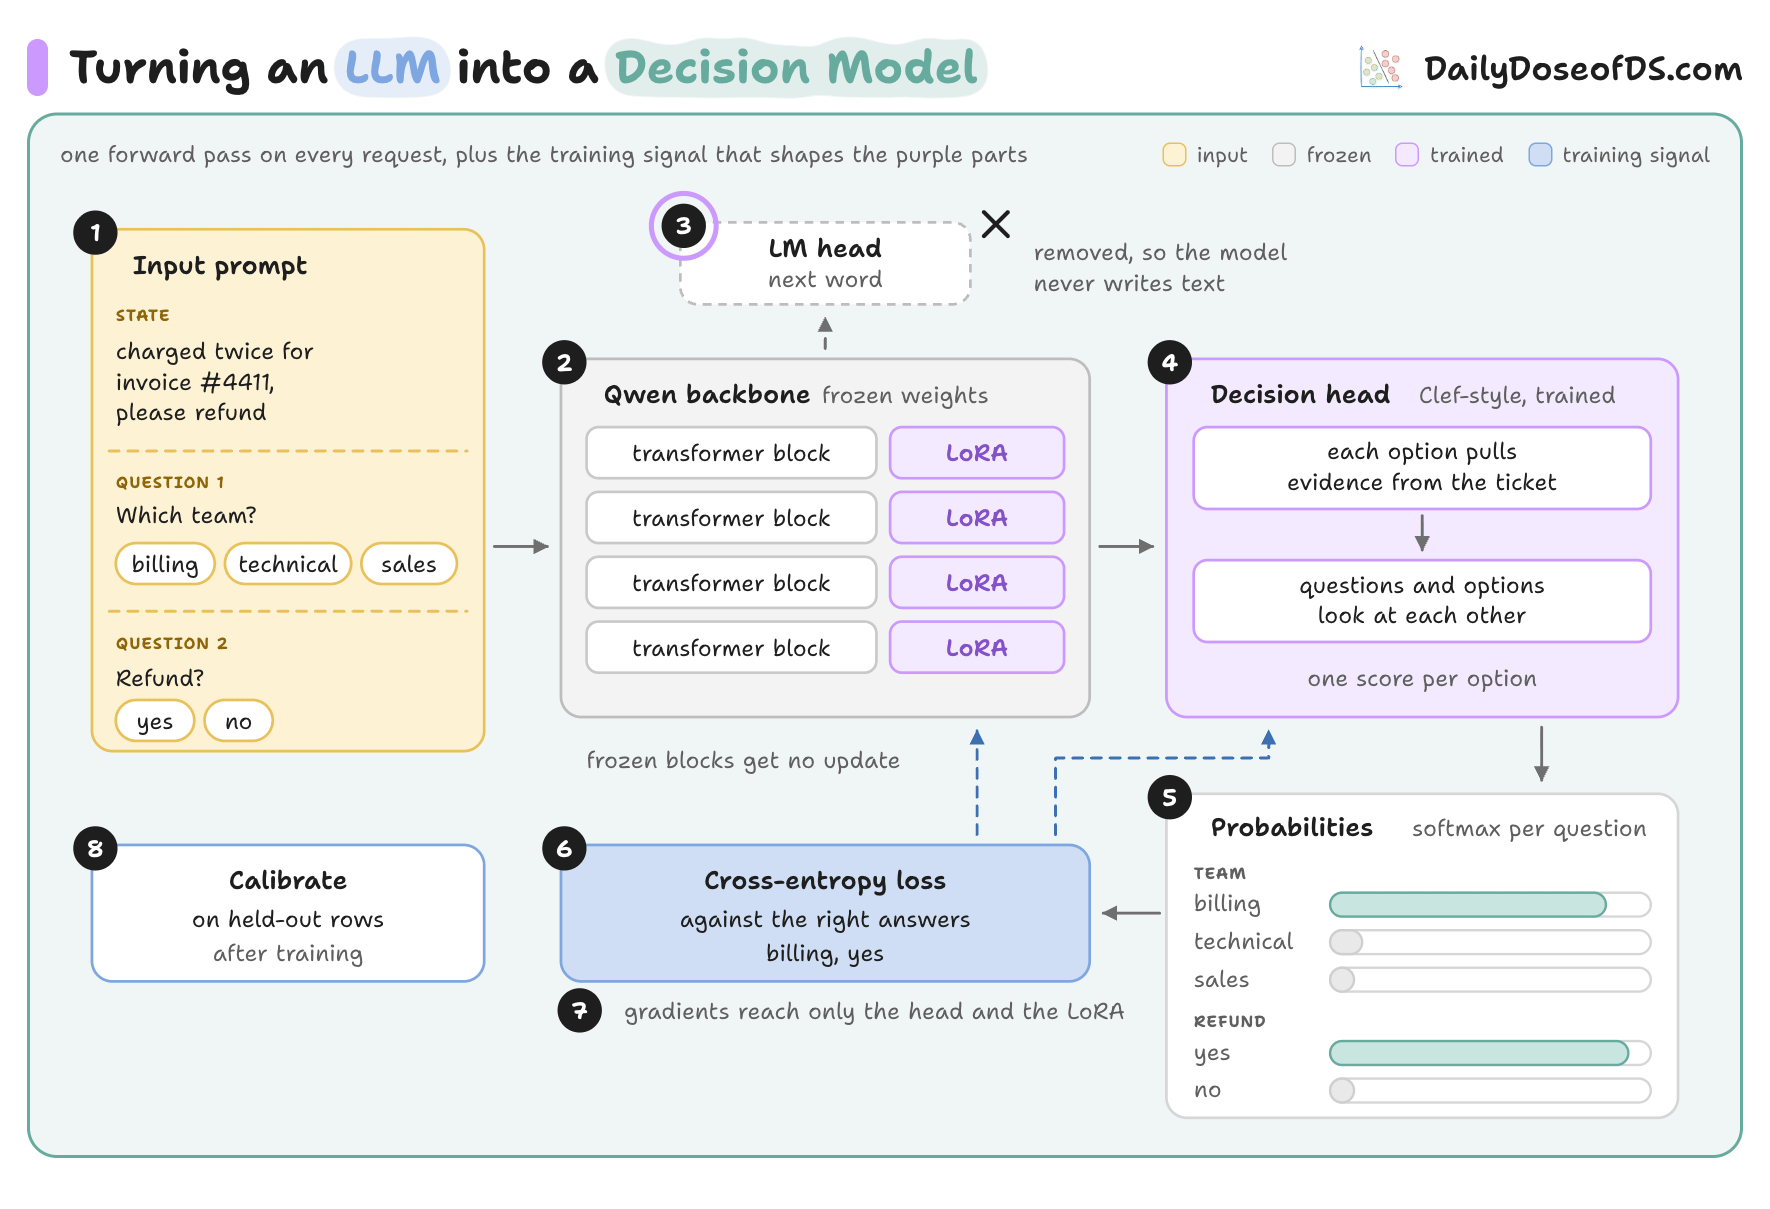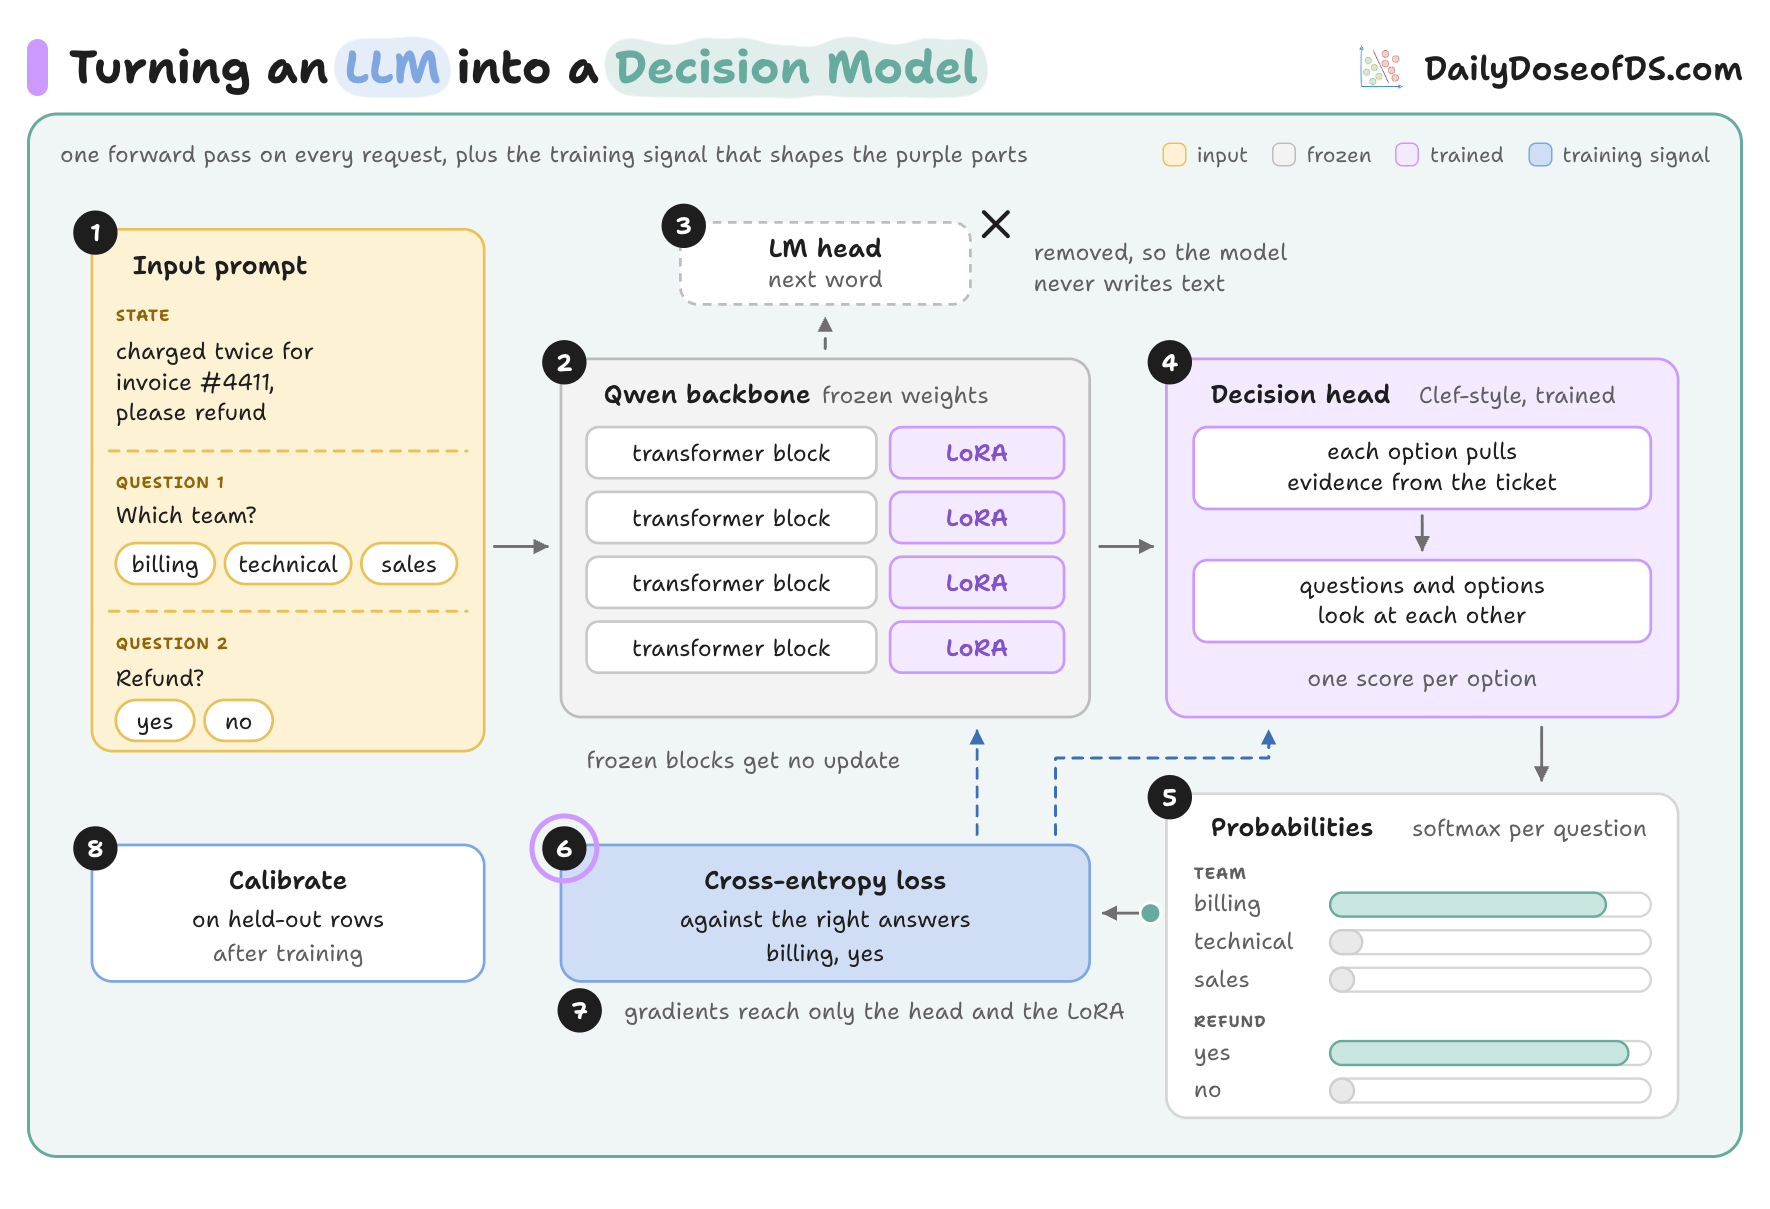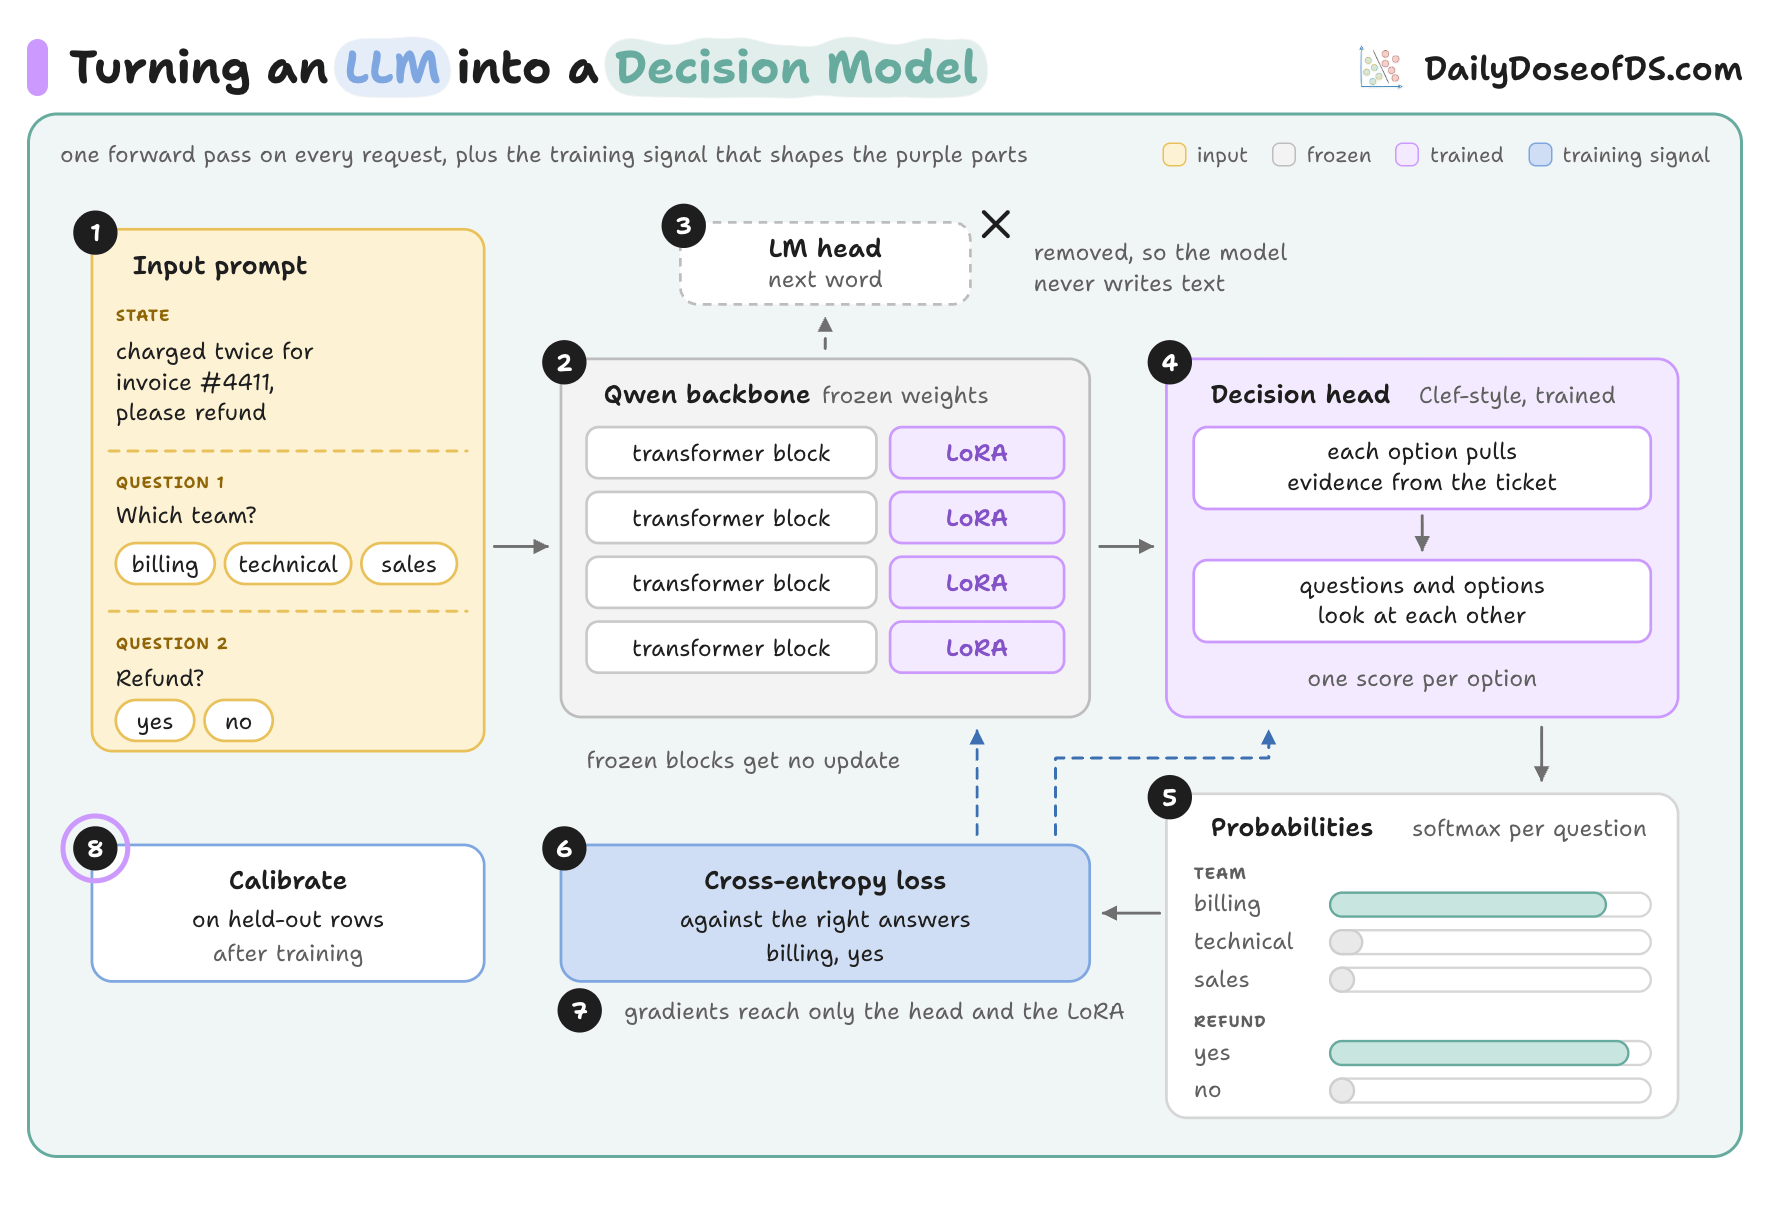
このエージェントは、リクエストをGitHubイシューにマッチングする週次の顧客フォローアップツールとして作られた。短い候補リストから1つを選ぶ判断が中心のタスクだ。構成は、エージェントハーネスとしてTrueForge、マッチング判断にJev、コード実行のサンドボックスにDaytonaを組み合わせる。40件のリクエストでのテストでは、すべてのマッチをOpusに任せた場合と同じ精度を、判断コスト150分の1で達成した。Jevが低確信度のマッチを返すと、それらはOpusのレビューに回され、そのまま通っていたはずの5件の誤マッチを検出した。
投稿では、JEV方式の判断モデルをローカルで訓練する方法も詳しく説明している。Qwen3.5 0.8Bを使い、60ステップで精度は37%から65%に向上し、訓練は4GBのVRAMで10分だった。TrueForge自体は、ツール定義を必要なときだけ読み込み、大きな出力をファイルに退避することでコンテキストを小さく保つ。DevRevのEnterprise Benchでは、Claude Managed Agentsとほぼ同数のタスクをおよそ3分の1のトークンで解き、認証情報はサンドボックスの外に保ちながら、すべての書き込みを承認待ちにする。TrueForgeは完全なオープンソースで、コマンド1つで動く。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
MicrosoftのAI研究部門が2兆パラメータのベースモデル「MAI-Base-2」の詳細を公開した
xAIは14日、Grok Voice 3.0を発表し、Grok Voice APIで提供を開始した
FAエンジニアが仕様書の下書き、試験手順、報告書の作成をClaude Desktopで行い、雑なメモから構造化された下書き、未決事項への質問、試験手順を得ていると語った

OpenAIは木曜日、6月に起きた4件の新たなインシデントを報告した
口座やクレジット、カード、保険を横断するテキスト・音声対応アシスタントのia.iが、第1段階で約30万人の顧客に到達
Amazonはウェアラブル個人AI「Bee Frontier」をOnyx、Lavender、Sageの3色で74.99ドルにて導入し、「Bee Eclipse」も99.99ドルから近日発売すると発表した