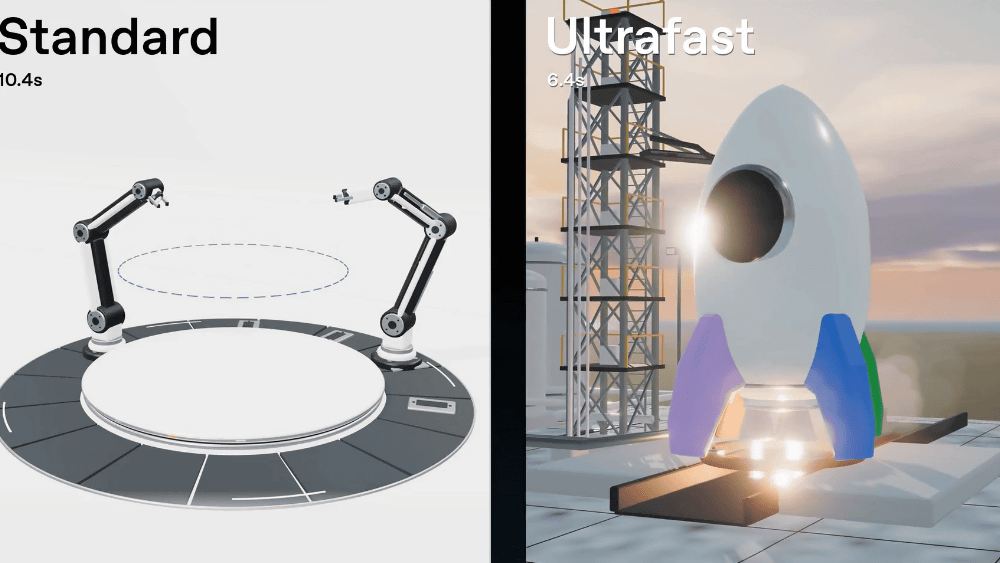
何が起きたか
SAILはVLMで軌道を生成し、シミュレータで実行、映像から進捗を採点し、修正した軌道をアームに送る。成功率は73%で、一発生成の25%を上回った。
なぜ重要か
進捗が止まった箇所を採点すれば、動作全体を推測し直すのではなく失敗部分だけを修正できる。修正後の成功例は学習データにもなる。
注目点
実機試験はオープンループのため、動作中にずれた物体を修正できない。1タスク・各手法6試行のみで、実機環境をシミュレータで再現できるかが鍵となる。
誰に効くかVLM駆動のピック・アンド・プレースを構築するロボティクス技術者には、実機の作業台に合うシミュレータと、動作途中で進捗を採点する手段が必要になる。本文自身が認めるオープンループの限界により、動く物体を扱うチームには別途の修正レイヤーが依然として要る。
こういう要約が、毎朝あなたのメールに届きます。
SAILが狙うのは、正しく見える計画と、実際に物体を動かせる動作との間のギャップだ。VLMはグリッパーの位置・姿勢・開閉の系列を出力でき、逆運動学コントローラは各ウェイポイントに到達できる。それでも把持に失敗するのは、点に到達することと、そこで把持できることが同じではないからだ。SAILはこのギャップを、候補軌道をシミュレータで実行し、得られた映像からフレームを抽出し、評価VLMに各サブタスクの進捗を0~100%で推定させることで埋める。この進捗スコアはウェイポイントに紐づけられるため、生成VLMは合否ラベルだけでなく、どこで進捗が止まったかが注記された軌道を受け取る。これにより高スコアの区間を保ち、低スコアの区間を修正できる。
探索側は、各ノードが軌道全体、各枝がその修正版であるモンテカルロ木探索として枠組み化されている。著者らが報告した同一15候補での比較では、探索と修正を組み合わせて6タスク平均65%の成功率に達し、フィードバックなしの幅優先生成は51%、反復修正の深さ優先は37%だった。ただしこの予算でのノートPC閉じタスクでは幅優先法の方が高スコアであり、この手法が一律に最良とは限らない。
実運用では負担が再構築に移る。本文によれば、GroundingDINOで物体を検出し、SAM2でセグメンテーションし、深度から3D点群を構築し、カメラキャリブレーションとArUcoマーカーでシミュレータに配置する。実機実行はオープンループで、1タスク・各手法6試行のみの検証であるため、このループが報われるかは、対象の作業台をどれだけ忠実にシミュレーションで再現できるか、そしてタスクをどれだけ反復するかにかかっていそうだ。
業界と使っているAIツールを選ぶと、毎朝7時に仕事に関係するニュースが届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
KnowledgeSenseは9月30日、国産AIエージェントCodeSenseを数週間以内にリリースすると発表し、現在β版ユーザーを募集している
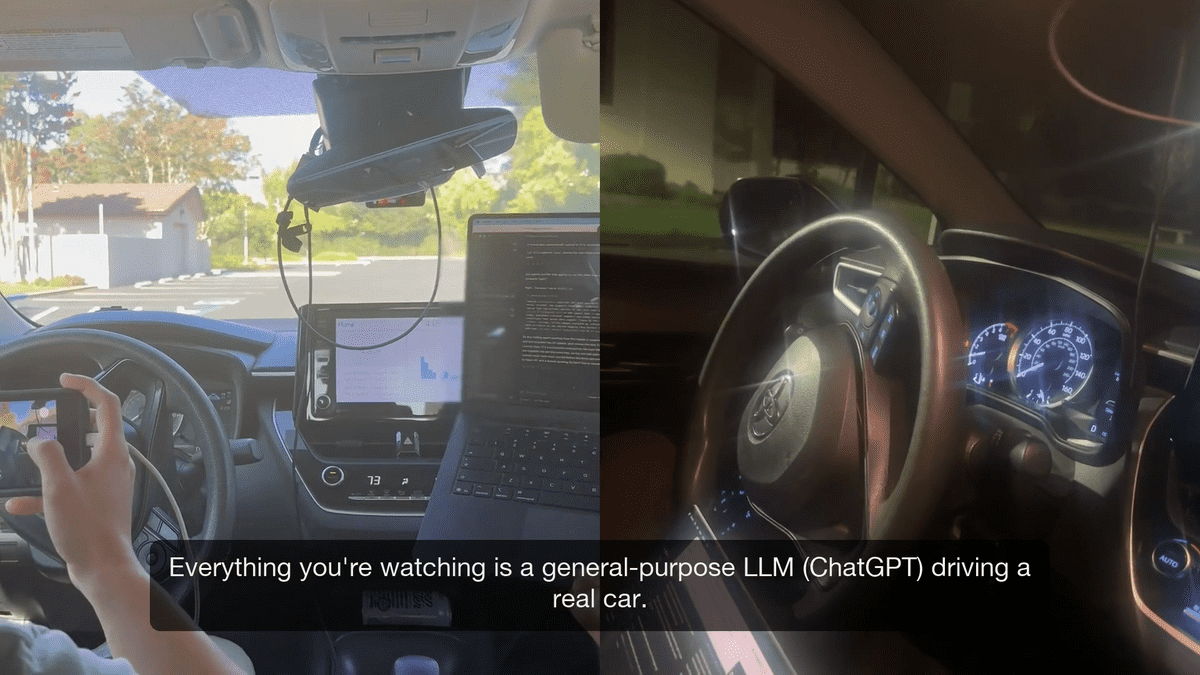
Axiom Mathの3人が2022年式トヨタ・カローラとcomma four、openpilotを使うDrivingBenchで4モデルを走らせ、約135mのコースを完走したのはGPT-6 Astraだけで、5分22秒…
Anthropicは2026年9月29日公表のレビューで、Z.aiのGLM-5.3がExploitBenchの410回中50回でエクスプロイトを構築したと報告
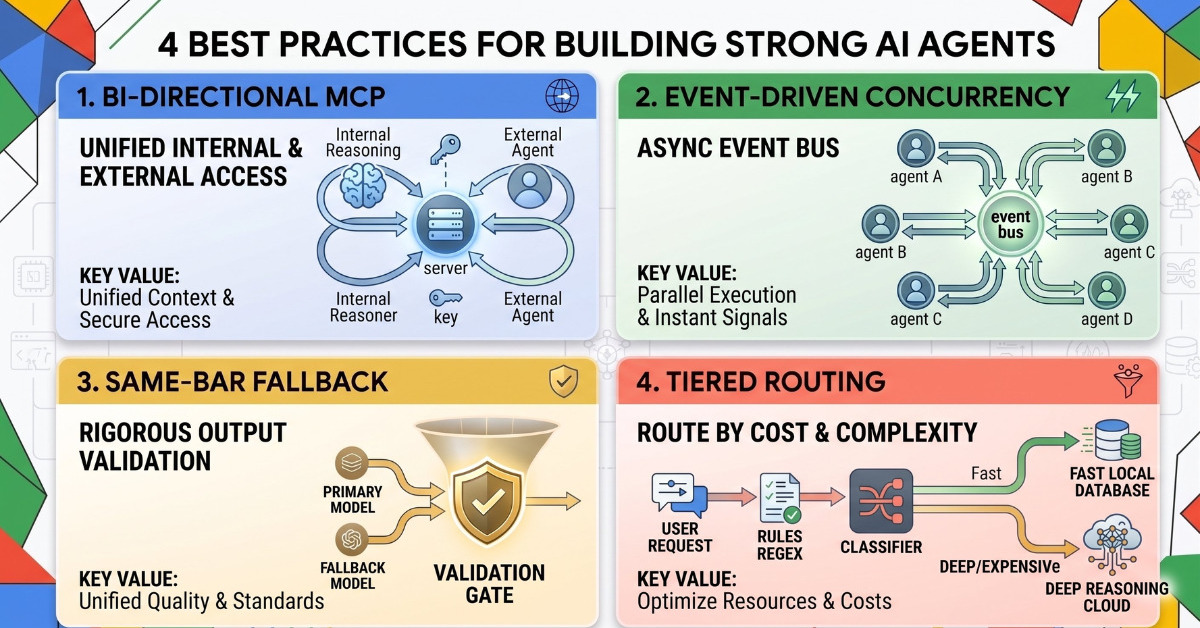
Googleは「Google for Startups AI Agents Challenge」の上位応募作から4つの設計パターンを公開
OpenAIが「Codex CLI」を刷新し、全画面インターフェースや「/agents」「/fork」コマンドを追加した
OpenAIはUltrafastを本日よりCodex、ChatGPT Work、APIのGPT-6 Astraで提供開始