何が起きたか
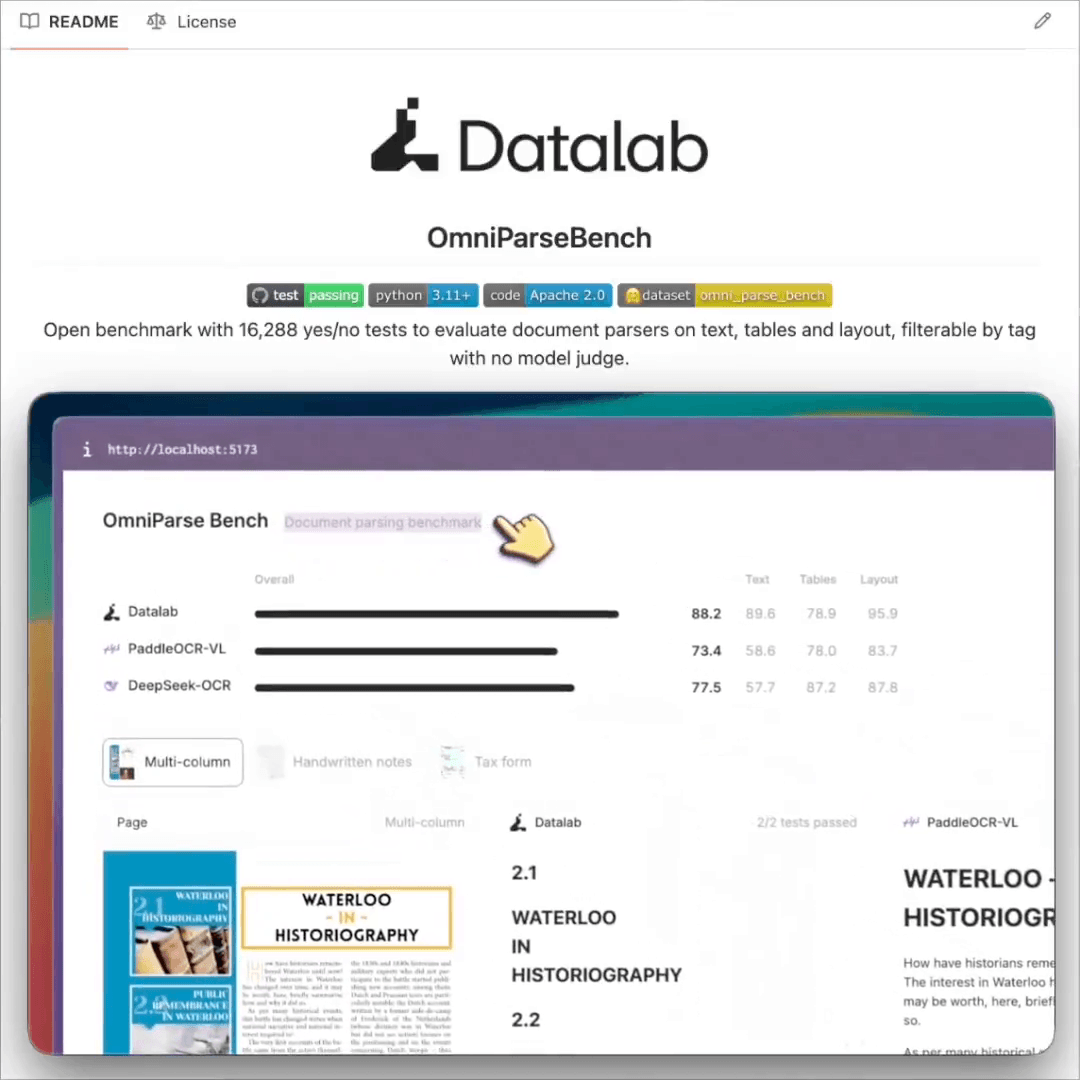
DatalabのOmniParse BenchでDeepSeek-OCR、PaddleOCR-VL、Datalab Suryaを同じ150ページで比較し、総合スコアはDatalab 88.2、DeepSeek-OCR 77.5、PaddleOCR-VL 73.4だった。
なぜ重要か
総合スコアが最上位でも、自社の文書種別で最適なパーサーとは限らないと示されたため、平均値だけで選定すると手書きや表など特定のページで失敗するリスクがある。
こういう要約が、毎朝あなたのメールに届きます。
OCRの比較はこれまで、パーサーごとに1つの平均スコアを並べる形が主流だった。しかし平均は、自分の扱う文書でどこが破綻するかを示さない。保険会社がスキャンした請求書を処理し、研究チームが数式入りの2段組論文を、財務チームが密な表を扱うように、現場の文書は平均像とは異なる。OmniParse Benchは、行の有無やセルの見出し位置、順序といった単純な合否テストを積み上げ、失敗には「テキスト欠落」などの理由を付ける。スコアはLLM審判ではなくオープンコードで計算され、タグで手書きや表など特定の難所だけを抽出して採点できる。Datalab自身がベンチマーク作者でありSuryaが自社モデルである点は、誰でも再実行できる透明性で補う設計だ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
GoogleはAndroid Dev SummitでAndroid Studio Rabbit 2を発表
LangChainはエージェント向けに4段階のループ構成を示した
最近の米大統領選で誰が勝ったかを尋ねられたGoogleのAIモードは、直接の回答ではなく外部リンクのみを示し、「最近の極めて敏感な選挙関連トピックに対する安全フィルター」は「非常に厳格」だと述べた
Will KnightはCodexに研究論文を与え、ニュース読解・結果分析・モデル実行・批評の各エージェントで構成するハーネスを組ませた
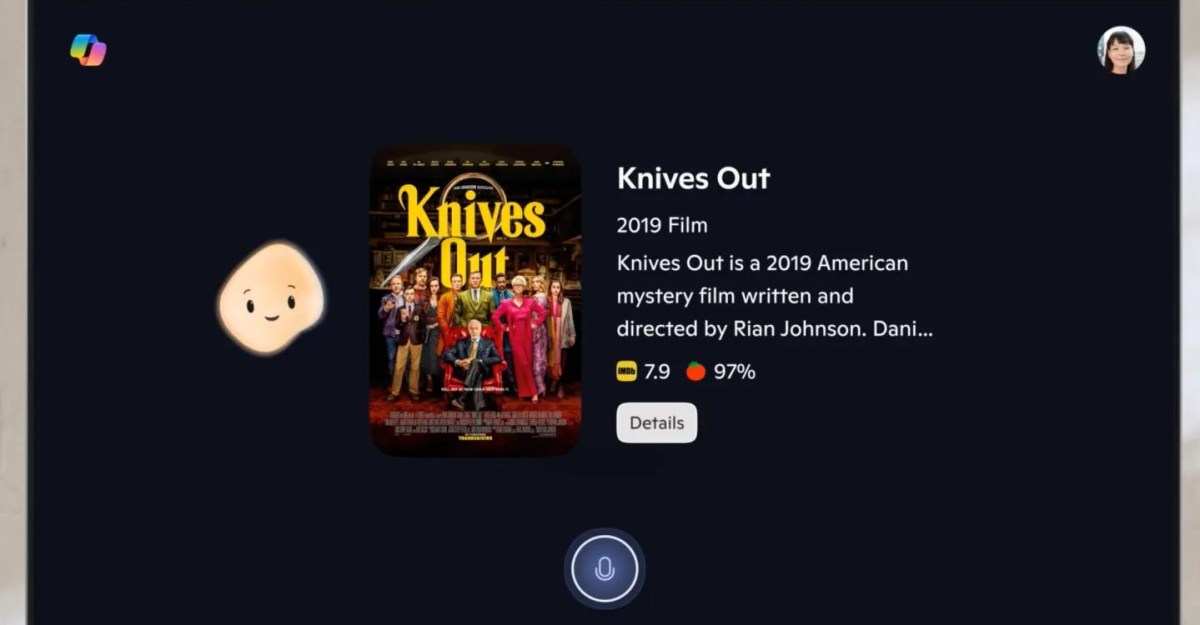
MicrosoftがLG製を含む全テレビでCopilot機能を終了する
OpenAIの管理職2名が、AIはすべての従業員の下に新たなAI労働層を置く、人間のチームの横にAIを配置する、経営陣と従業員の間にAIを置くという3つの形で企業を再編すると主張する論文を発表した