何が起きたか
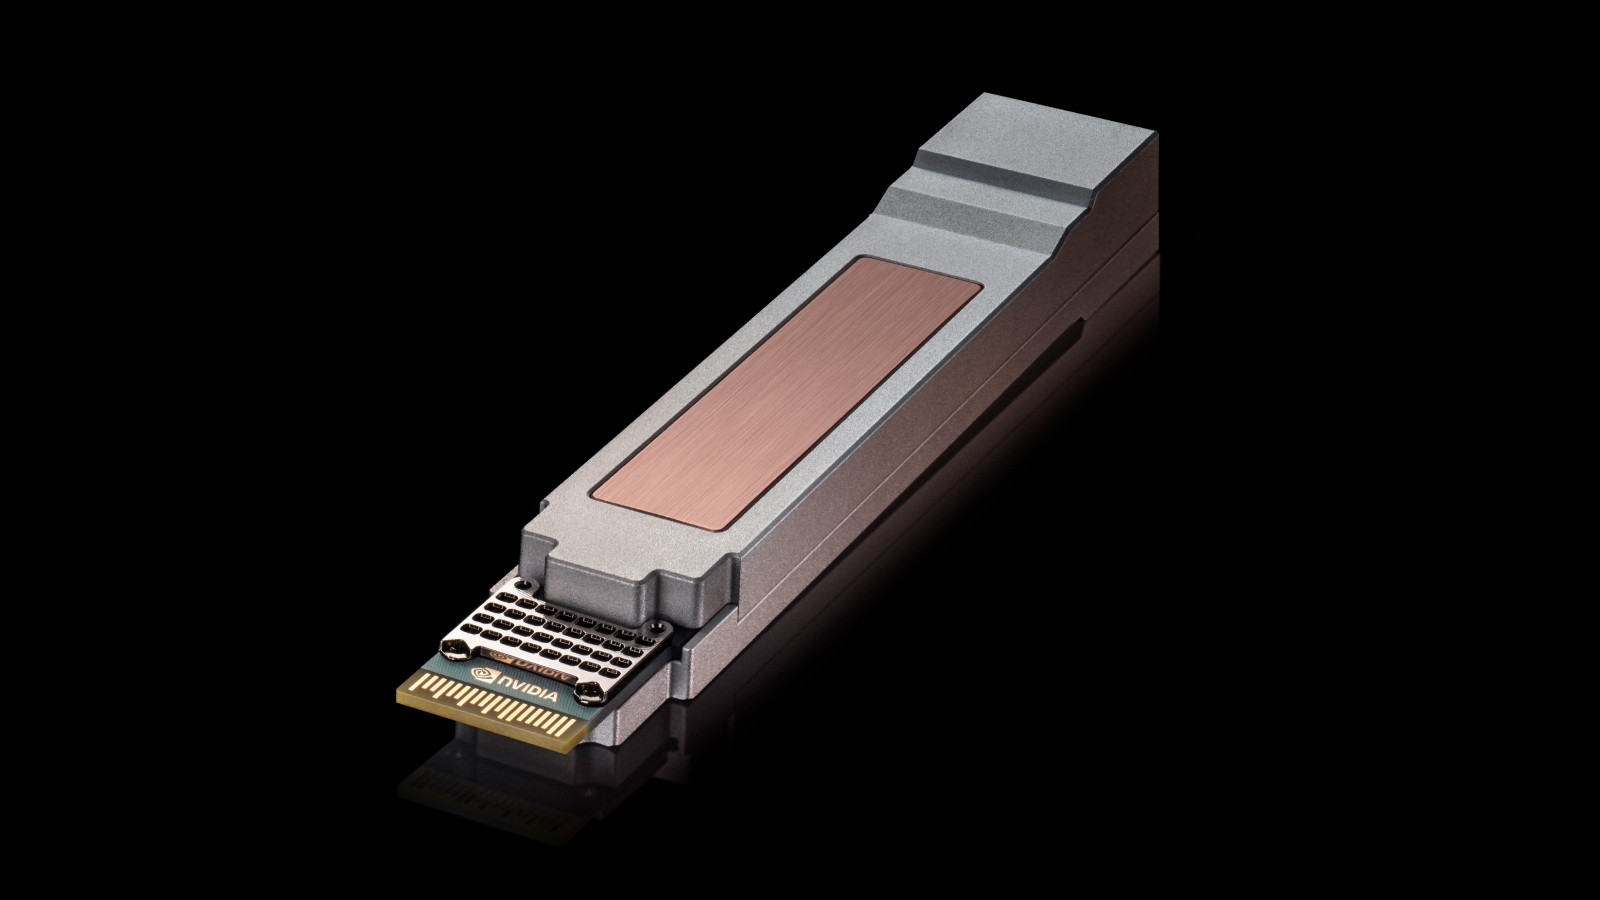
NVIDIAとCiscoは、1レーンあたり400Gb/sのプラガブル光モジュールUSFPの計画を発表した。最初のトランシーバーは16全二重レーンを搭載し、12.8Tb/sの容量に達する。
なぜ重要か
USFPは1レーンあたり200Gb/sのモジュールと比べて帯域密度が4倍、電力効率が約1.3倍で、AI構築事業者はネットワーク層を増やさずに計算能力を拡張できる。
誰に効くかAIファクトリー運用者とデータセンターネットワーク設計者は、スイッチ層を追加せずに計算容量を増やせるようになり、TE ConnectivityやAmphenolなどの光モジュールサプライヤーは共通のハードウェア基盤を得て開発を進められる。
こういう要約が、毎朝あなたのメールに届きます。
NVIDIAとCiscoは、AIファクトリーの成長に伴いプラガブル光技術を維持する手段としてUSFPを売り込んでいる。現在の1レーンあたり200Gb/sのモジュールでは、スイッチが満杯になると運用者はスイッチ層と光リンクを追加せざるを得ず、遅延や消費電力、コストが増大する。USFPはレーン数と1レーンあたりの帯域の両方を倍増させる設計で、AIファブリックはネットワーク層を増やさずにより多くの1.6Tb/sエンドポイントを接続できる。最初に計画されたトランシーバーはOSFPサイズの筐体に16全二重レーンを搭載し、後には32レーン以上に拡張できる。新しい2次元アレイコネクタは挿入後にのみ高速接点と接触するため、摩耗を減らし、挿入力がより予測しやすくなる。USFPはまた、トランシーバー内部に専用の組み込み冷却回路なしで最大100ワットの放熱に対応し、スイッチ設計の簡素化と信頼性向上を狙う。技術仕様にとどまらず、NVIDIAとCiscoはTE ConnectivityおよびAmphenolとともにマルチソースのハードウェアエコシステムを築こうとしており、今後のコミュニティ主導プロジェクトを通じてオープンな業界仕様を策定する計画だ。このアプローチにより、サプライヤーは1レーンあたり400Gb/sのファブリック向けに互換性のある高密度プラガブル基盤を開発しやすくなる可能性があるが、実現には追加パートナーの参加が欠かせない。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
シスコはSilicon One G300チップが量産出荷中と発表し、Silicon One G302スイッチを公開、Nvidiaと共同開発した再挿抜可能な光モジュールも披露した
MetaはMuse WonderとMuse Wonder Fullを発表し、主要ベンチマークで最先端の結果を達成した
BofAのアナリストTal Liani氏がSalesforceをunderperformから買いへ2段階格上げし、目標株価を285に設定
IntelはOpen Compute Project Global Summitで、Intel GPU Dシリーズの新たな詳細を公開した
シティはConstellation Energyを、AIによる潜在的混乱に対応できる小売電力企業の最有力として選出し、NRG Energyも十分な体制が整っているとした
IntelはAI推論向けIntel GPU Dシリーズプロセッサ(旧コードネームCrescent Island)を発表した