何が起きたか
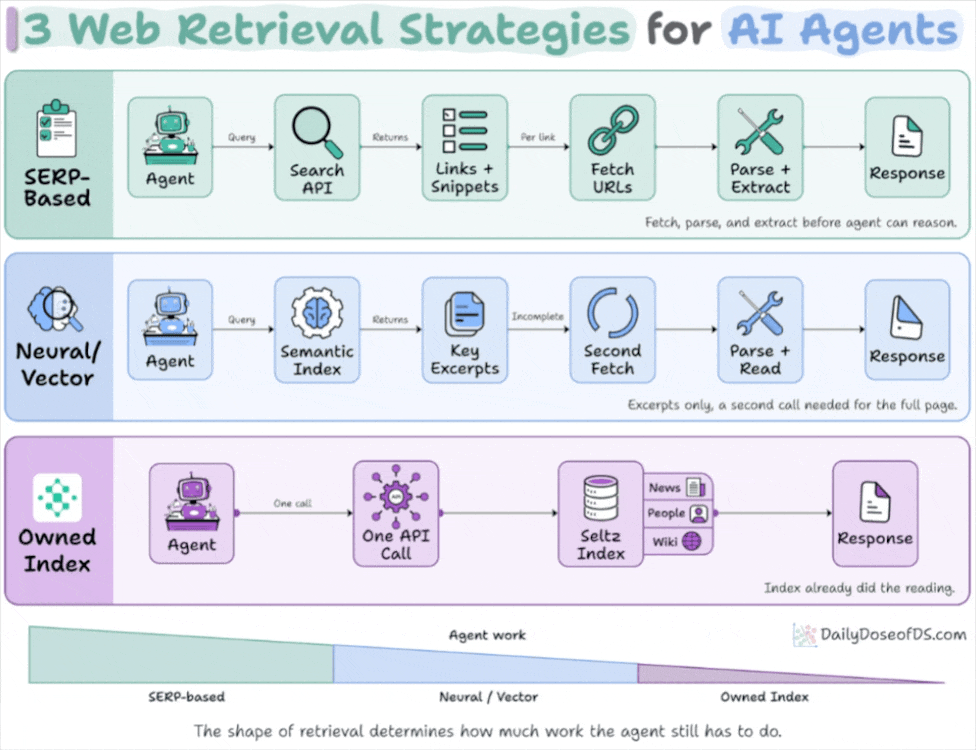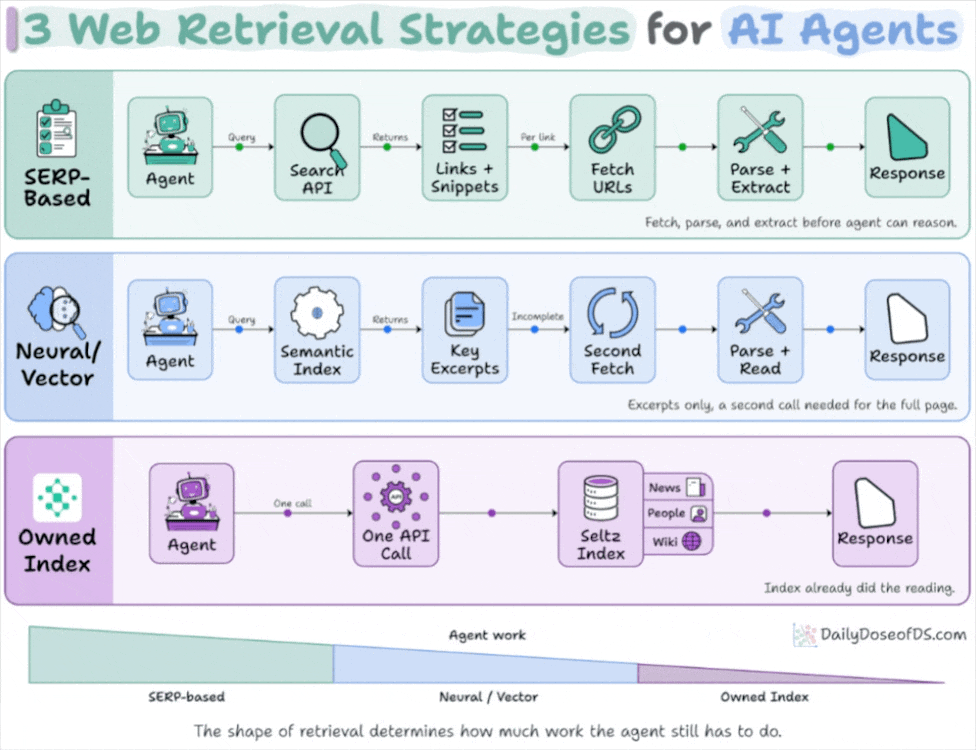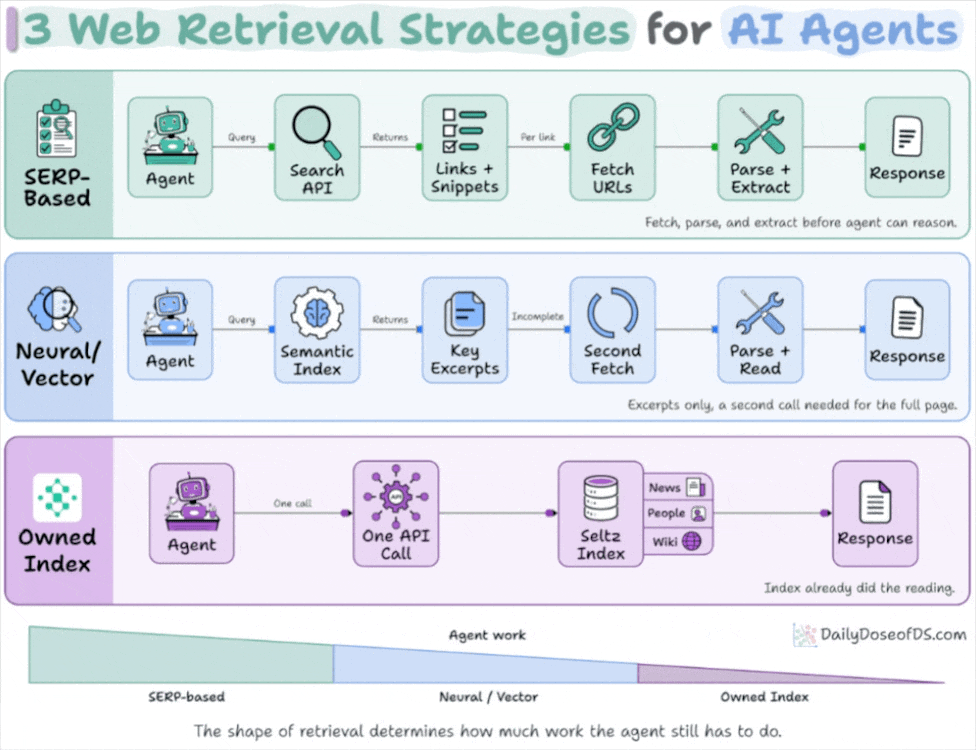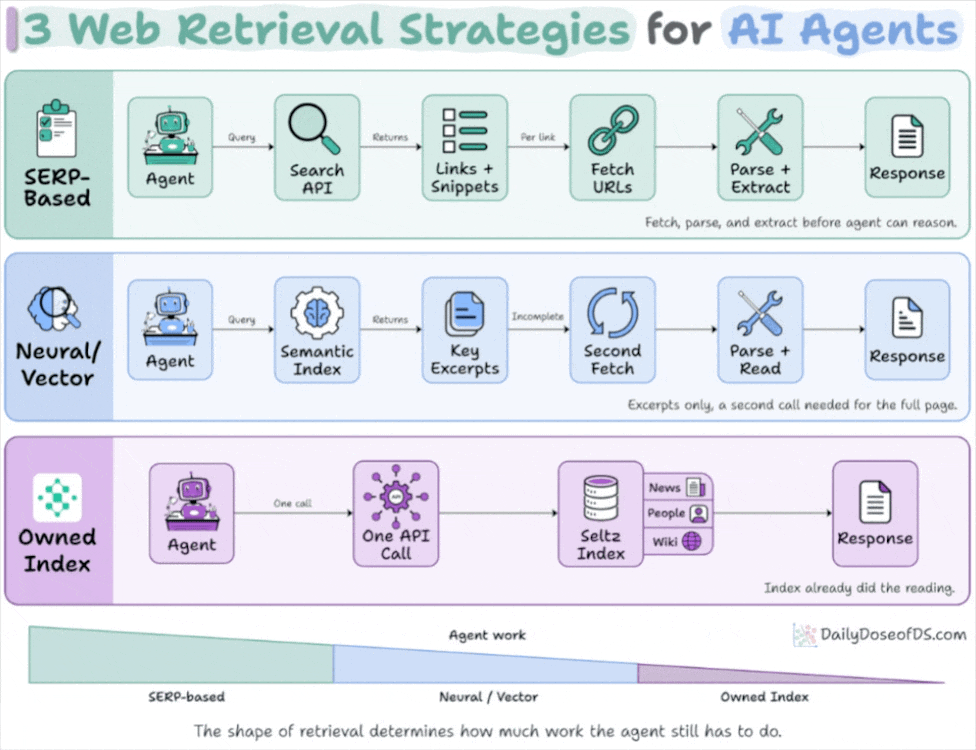
AIエージェントのウェブ検索方法を分析すると、従来の検索APIは断片とリンクのみを返すため、エージェントは毎回のクエリで生HTMLを取得して清掃する必要があることが分かった。同じ質問を3つの検索方法(通常の検索結果、ニューラル検索、事前インデックス付きウェブサービス)で実行したところ、断片をループするコストは前処理済み全文書にアクセスするコストの約4倍かかることが判明した。複数の検索が必要な調査タスクでは、エージェントは既に見たコンテンツに対して繰り返し「検索税」を支払うことになる。
なぜ重要か
コーディングエージェントとLLM駆動システムが本番環境に移行する際、検証はオフラインテストから本番テレメトリーへとシフトする。つまり、エージェントは訓練されていない実世界のクエリに対応する必要がある。ウェブ検索はエージェントが市場、ニュース、組織の変化を最新に保つ方法だが、現在の検索APIはオーバーヘッドにトークンを浪費している。エージェントループ(調査パイプライン、GTM説明資料、市場監視)を構築するチームにとって、検索ツールの選択はモデルやプロンプトではなく、コストと速度に直結する。
注目点
Seltzはエージェント向けに特化したウェブインデックスで、完全に構造化されたドキュメント(人物プロフィール、全文記事、Wikipedia項目)を単一の呼び出しで返す。断片からコンテンツを再構成するようにエージェントに強要しない。発見完了後のディープダイブ検索に最適であり、発見クエリ(オープンウェブ検索)とディープダイブクエリ(インデックス済み全文書)をチェーンすることで、ループの各反復が実際に必要な検索方法を使用できる。
こういう要約が、毎朝あなたのメールに届きます。
この記事は、AIエージェントがウェブと相互作用する方法における構造的なミスマッチを示唆している。コーディングエージェントはソフトウェア生成のコストを劇的に削減したが、検証能力(本番環境前に障害を検出する能力)はそれに追いついていない。AI生成コードは、人間がコードを書くときに思考モデルを形成していないため未知の未知数に失敗し、検証を実際のトラフィックで行わざるを得ない。同じ課題はプロンプト変更と検索増強生成(RAG)にも適用される。オフラインテストは本番環境の障害を予測することはできない。この本番環境優先の検証へのシフトは、オペレーターが必要とするあらゆる属性で事後的にスライスできる生の高カーディナリティテレメトリーを必要とする。
このフレーム内では、ウェブ検索は現在のデータを扱うエージェントにとって重大なボトルネックとして浮かび上がる。市場の変化、新規採用、公開されたニュース、価格更新である。この記事は隠れたコストを定量化する。スニペットではなく全文書を返すすべての検索呼び出しにより、エージェントはHTMLを取得、解析、清掃するよう強要され、ループの反復ごとにこのコストを支払う。トークン監査(スニペットを3ホップで28,700トークン対インデックス付き文書の単一クエリで6,900トークン)は、コンテキストウィンドウサイズに対する複合税を可視化する。この記事は、修正はより賢いモデルやプロンプトではなく、検索インターフェイス自体の変更(完成した構造化ドキュメントを返してエージェントに推論させ、前処理をさせない)であると主張している。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
第2四半期に富豪やファンドが「Magnificent Seven」のAI関連株6銘柄を売却

Barron'sによると、Nvidiaは金曜早朝に上昇した

ElevenLabsが220億ドルの評価額で3億ドルの従業員向けテンダーを完了し、Mati Staniszewski氏は音声が主要なインターフェースになると予測した

OpenAIは10月15日、Rosalind Academic Planを発表した

Qiita記事がLLMアプリ向け自動レッドチーミング手法GCG・PAIR・TAPを実LLMなしの模擬実装で比較した

Liquid AIは2026年10月15日、オープンウェイトの改良版意思決定モデルd1-ultraを公開した


