何が起きたか
Thermo Fisher ScientificはAWS上に患者募集データ基盤を構築し、2000万件超の患者プロファイル記録(約1.6 TB)を統合。
なぜ重要か
募集チームはコホート探索を数日ではなく数分で実行できるようになり、技術チームへの引き継ぎを自然言語によるセルフサービス検索に置き換えた。
誰に効くか臨床試験の募集チームや施設コーディネーターは、適格な患者集団を特定する迅速なセルフサービス手段を手に入れ、IT・データエンジニアリング担当者はアドホックなクエリ依頼の減少が見込める。
こういう要約が、毎朝あなたのメールに届きます。
Thermo Fisherの患者募集データは、患者プロファイル、調査、同意記録、マーケティング接点、施設データなど複数の分断されたシステムにまたがって増大し、募集チームが全体像を把握しにくい状況を生んでいた。既存のプロセスでは、ビジネス上の問いをデータベースクエリに変換するために専門技術チームが必要となることが多く、条件が変わるたびにこのサイクルを繰り返していた。チームはこうしたシステムの上にAIを重ねるのではなく、まずAWS上にモダンで厳選されたデータ基盤を構築し、分析やAIワークロード向けにデータを標準化・準備した。この基盤が、募集分析向けのCentral Insights Hubと、自然言語によるコホート探索向けのPatient Match AIという補完的な2つの機能を支えた。
アーキテクチャ上の重要な選択は、運用アプリケーションのワークロードと分析処理を分離したことだ。これにより、大規模な患者プロファイルを対象に複雑なコホートクエリを実行しても、トランザクションデータベースに負荷をかけずに済む。Thermo Fisherはテスト段階からAWS Countdown Premiumを活用し、専任エンジニアがパイプライン設計をレビューし、Amazon DocumentDBのチューニングを支援したことで、推定処理時間を3倍以上短縮した。2000万件の全データセットに対する本番規模のテストでクエリ性能の問題を早期に発見できたため、稼働前に修正が可能となり、よりスムーズな本番ローンチにつながった可能性が高い。
この結果は、募集チームの働き方におけるより広範な変化を示している。情報が複数の技術的な引き継ぎを経て届くのを待つのではなく、信頼できるデータと直接やり取りし、ダッシュボードで現状を確認し、自然言語ツールで可能性を探れるようになった。Thermo Fisherは、共通基盤により、基盤となるデータインフラを繰り返し再構築することなく募集機能を進化させ続けられる機会が生まれるとしている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Microsoftは11月17日から20日までサンフランシスコでIgniteを開催し、CEOのSatya Nadella氏が基調講演を行う
11月12日、Googleは日常的なコーディングと多段階のエージェントタスク向けにGemini 4 Hydrogenを発表し、GeminiアプリとGoogle検索での展開を開始した
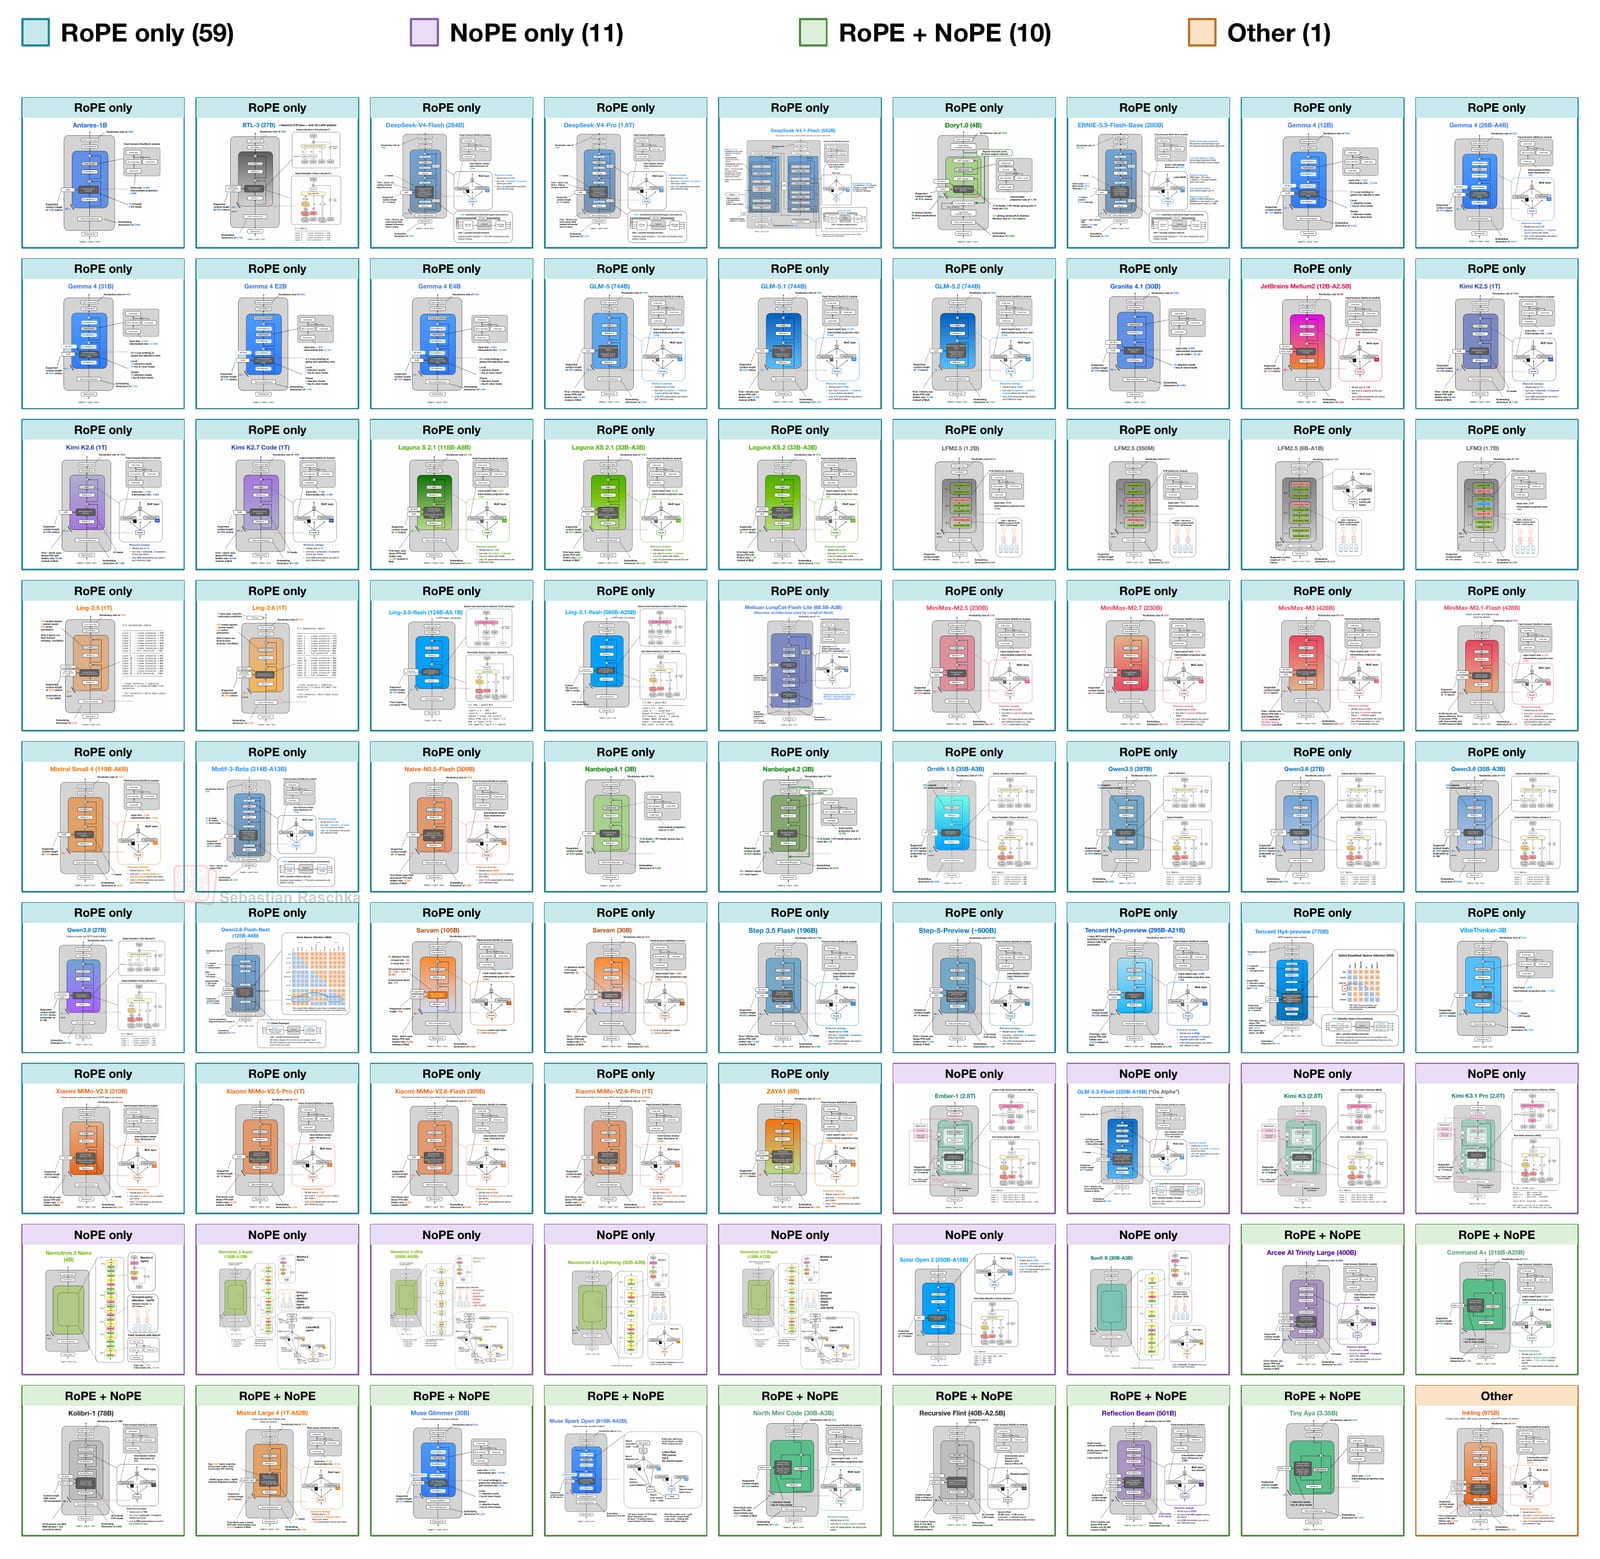
Sebastian Raschka氏がLLMの位置埋め込みを解説
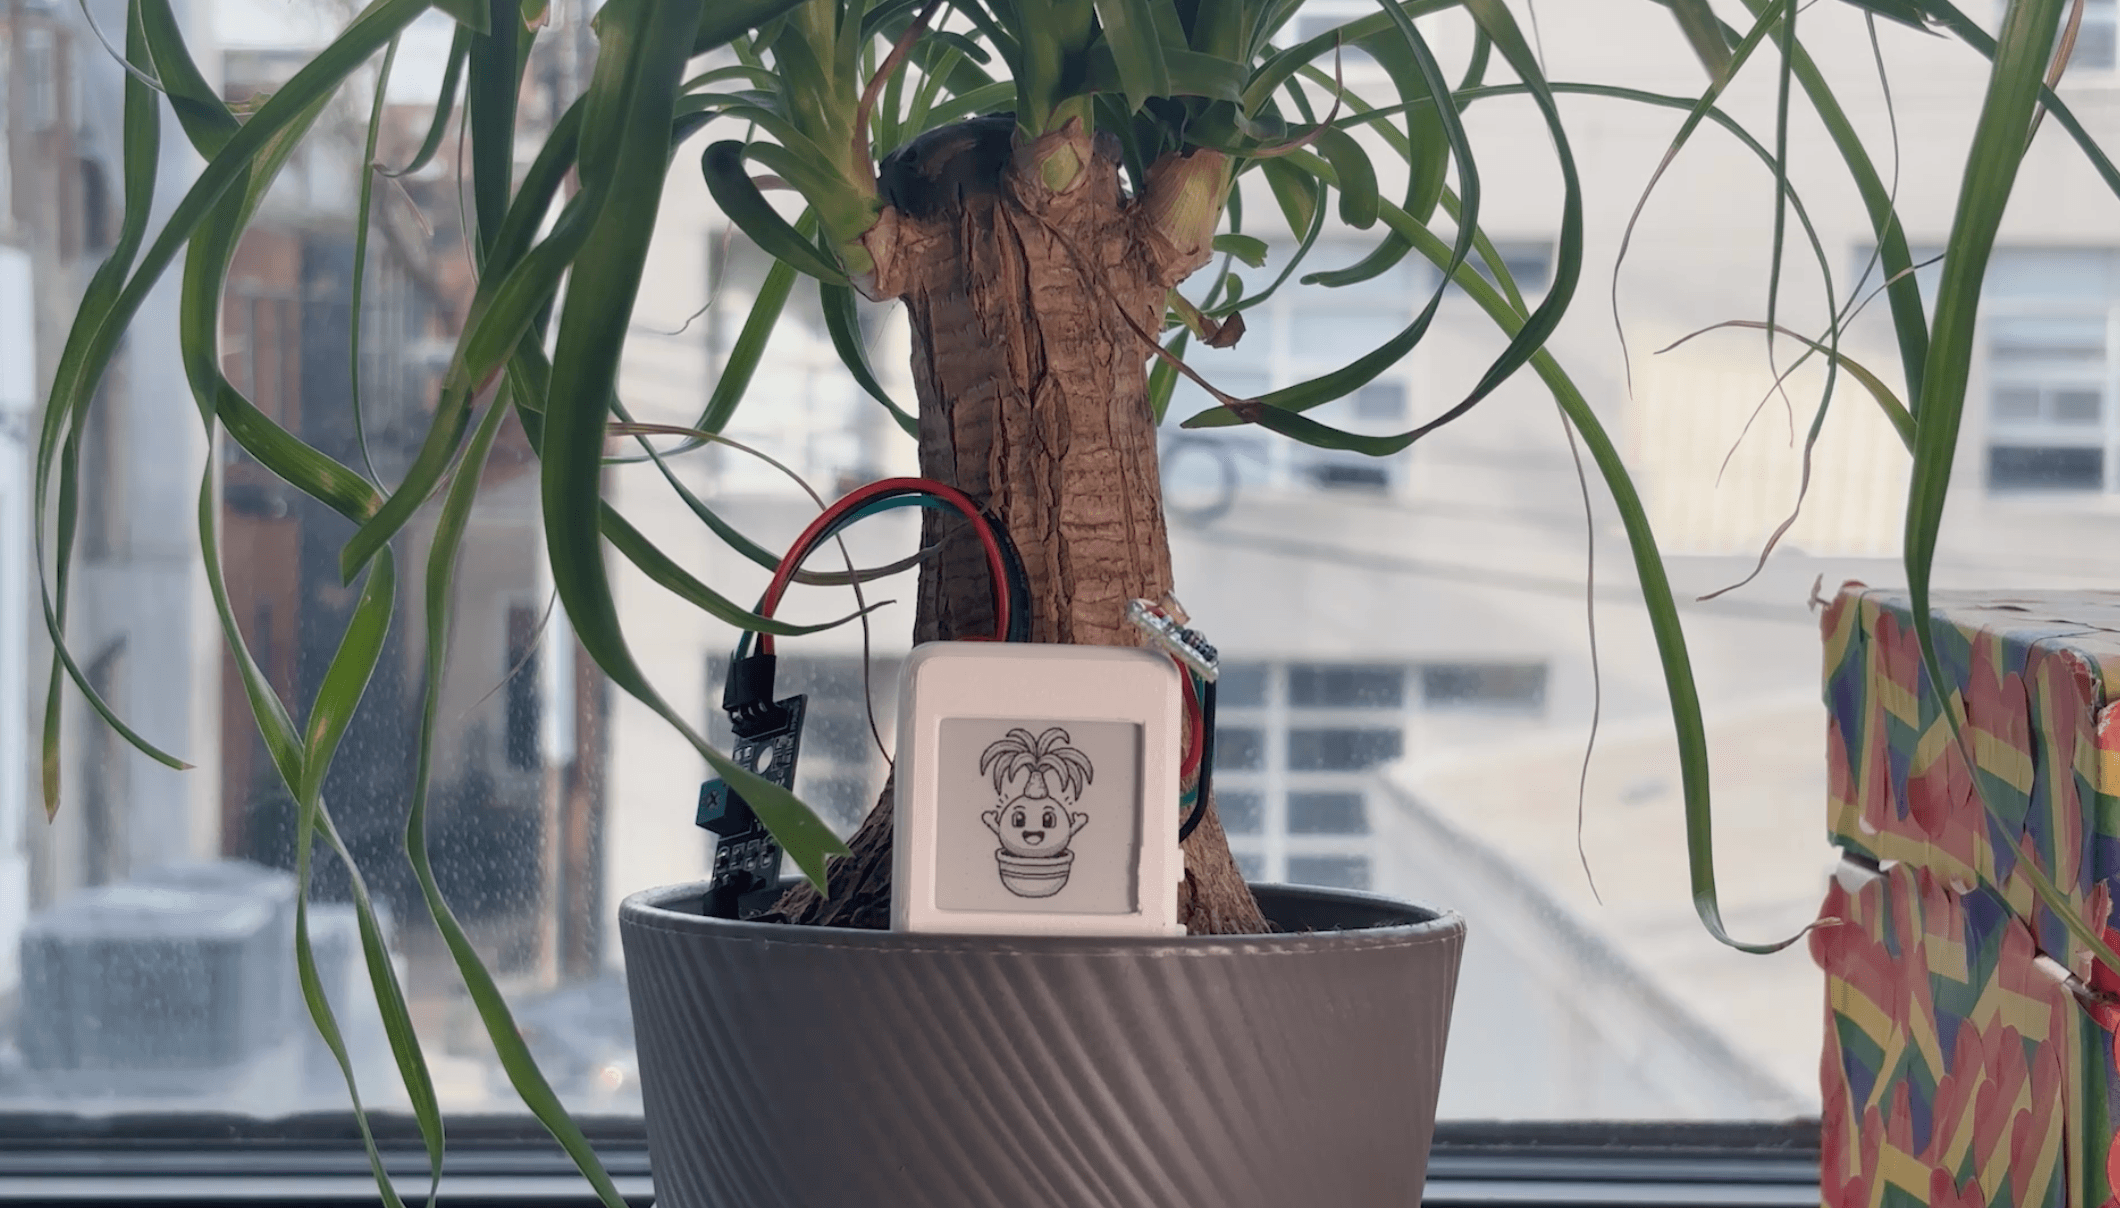
Daehwa Kim氏がACMシンポジウムでOATsを発表
Nvidiaが火曜に決算、FRBが水曜に10月議事録を公表、Anthropicは水曜にIPO価格を決定し、木曜にナスダックで「ANT」として取引開始予定
藤井氏がMuseの「Space」上でアプリを構築