何が起きたか
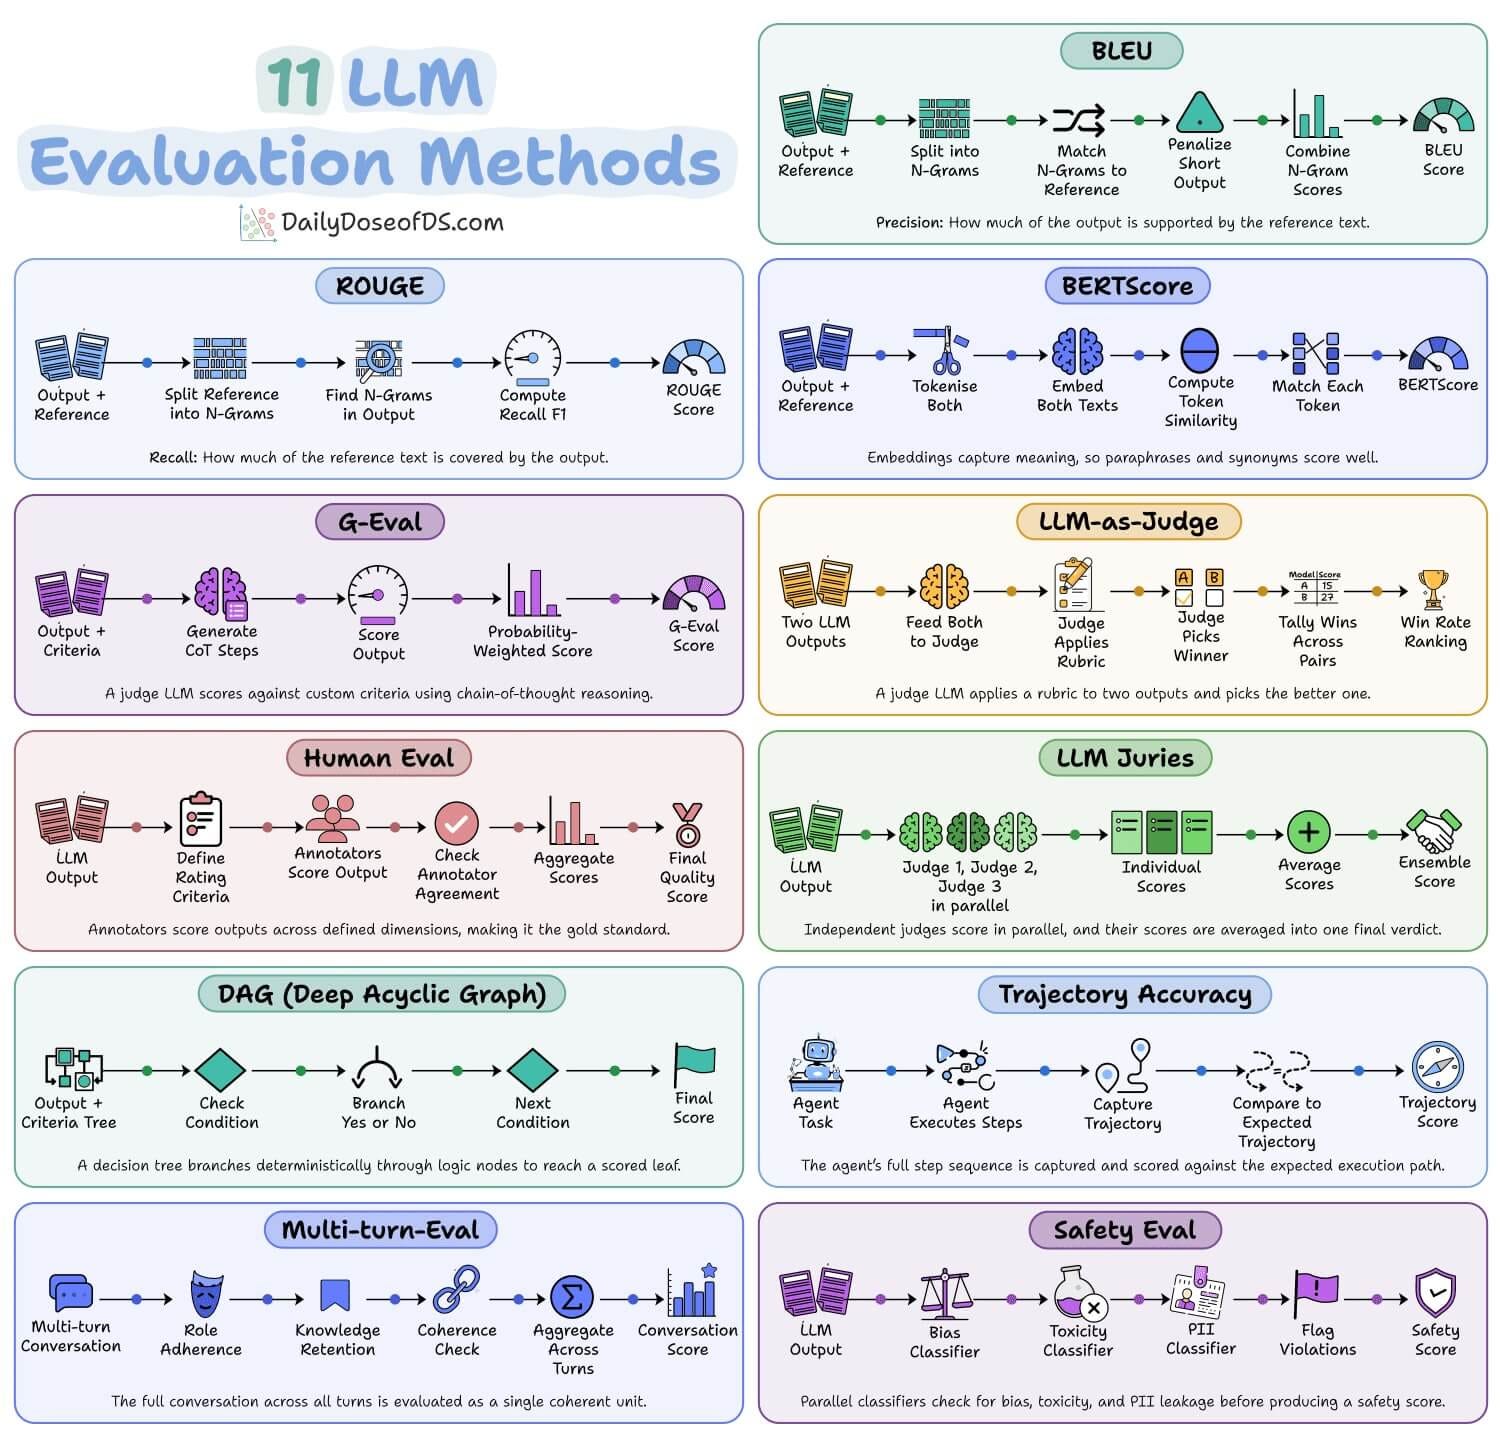
大規模言語モデルの評価手法11種類をまとめた技術ガイドが公開された。翻訳用のBLEU(n-gram重複度)、要約用のROUGE(再現率重視)から、AI判定官を用いるG-Eval、複数判定官によるLLM陪審団、有害性分類器とPII検出器をゲートとして機能させるセーフティ評価まで、新旧の手法を網羅している。
なぜ重要か
BLEUのような単一指標は、正しい答えでも参照テキストと異なる表現で言い換えられると0に近いスコアを与えてしまう。こうした言い換え問題により、実務者は複数の手法を組み合わせることを余儀なくされる。各指標は正確性についての異なる仮定を内包しており、適切な組み合わせの選択によって、モデルが本当に本番環境の準備ができているかどうかが決まる。
注目点
BLEU、ROUGE、BERTScore、G-Eval、LLM陪審団、軌跡精度、モデレーション等の多くの手法は、オープンソースのLLM評価・可観測性プラットフォームであるComet Opikに組み込まれており、本番環境のトレースデータ上で実行される。
こういう要約が、毎朝あなたのメールに届きます。
LLM評価は未解決の問題である。記事は具体的な失敗例で始まる。モデルが正しい答えを生成しても、参照テキストにぴったり一致せず言い換えていれば、BLUEでほぼ0スコアになる。こうした断片化が存在するのは、異なるアプリケーションが異なる正確性仮定を要求するためである。翻訳には正確な表現が必要(BLUE)、要約は主要内容がカバーされていれば言い換えを許容(ROUGE)、トーンや指示追従のような主観的タスクには参照答えがない。このガイドは指標をファミリーでグループ化してこの領域を図式化する。n-gram重複度(BLUE、ROUGE)、意味的類似性(BERTScore)、モデル判定官アプローチ(G-Eval、LLM-as-Judge、陪審団)、人間アノテーション、タスク固有の手法(決定論的ルール用DAG、エージェント行動用軌跡精度、会話一貫性用マルチターン評価)である。重要なパターンが浮かぶ。本番システムは1つを選ぶのではなく複数の手法を織り交ぜる。BLUEだけは不安全である。言い換えに対応するBERTScoreや人間キャリブレーションと組み合わせることで選択を検証する。同様に、単一LLM判定官は予測可能なバイアスを持つが、異なるモデルファミリーからの複数判定官はノイズを平均化して相関誤差を増幅しない。セーフティ評価は別枠である。1つのPII漏洩インスタンスが高い平均スコアを無効にするため、品質指標ではなくゲートである。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
OneTrustはOneTrust CORIEを基盤とするFall '26リリースを発表し、厳選した基盤モデルライブラリからモデルの関連付けと非推奨指標を継続的に更新するAI台帳を追加した

Microsoft Ignite 2026でマイクロソフトは赤・青・緑チームのエージェントを組み合わせ攻撃模擬・検知調査・脆弱性修正を行うMicrosoft Perceptionの一般提供を発表した

Microsoft Ignite 2026でWindows Server 2028のパブリックプレビューが公開され、Microsoft Foundry、Windows ML、vLLM、Llama.cppによるAI推論ホス…

AUMOVIOはDatabricks Unity GatewayをLLMへの唯一の経路に採用

CADMAGEDDONはBenchCADの64³ボクセルIoUで、1000部品のサブセットにおいて0.991を記録し、Claude Sonnet 5.5の0.963、Claude Opus 5.5の0.962、GPT-6…

MIT Technology ReviewのAI誇大広告指数はAIの広がりを示し、GoogleのAI Overviewsが広告収入で数十億ドルを失わせたことやAI支援のサイバー攻撃を挙げた


