何が起きたか
AWSのエンジニアがAmazon SageMaker AI上で融合Mixture-of-Expertsカーネルの最適化を実装し、オープンソース化した。
なぜ重要か
AI応答の高速化と配信コストの低減につながる。
誰に効くかH200 GPUで大規模言語MoEモデルを運用するクラウドおよびプラットフォームのエンジニアは、スループットの向上と初回応答時間の短縮の恩恵を受け、AIアプリケーションの配信コストが下がる可能性がある。
こういう要約が、毎朝あなたのメールに届きます。
融合MoEは、トークンのルーティング、データのシャッフル、エキスパートネットワークの計算を別々の逐次ステップとして実行するのではなく、単一のバッチ化されたGPU操作に統合する。この構造はレイテンシの改善に役立つが、カーネルのチューニングは難しくなり、NvidiaのHopperアーキテクチャ——H200 GPUを含む世代——の制約に特に敏感になる。
最初のボトルネックはデコード時に現れる。システムはユーザーシーケンスごとに一度に1トークンを処理する。バッチサイズは1行または64行未満に縮小する一方、エキスパートの重み行列は大きいままである。HopperのWGMMA命令は第1オペランドに固定の64行レイアウトを想定しているため、細いトークンベクトルではTensor Coreの容量の多くが未使用のままになる。AWSのSwap-AB転置は大きなエキスパート次元をその先頭スロットに昇格させ、レイアウトを飽和させるとともにHopperがメモリを非同期でプリフェッチできるようにする。
2つ目の効果は、FP8量子化されたMoE処理をデフォルトのFLASHINFER_CUTLASSパスではなくvLLMのTritonバックエンドにルーティングしたことから得られた。Tritonはスケーリング、行列積、エキスパート集約を高速なオンチップメモリを通る1パスに融合し、ライブ配信の小さく断片化したトークンバッチに適している。3つ目の修正は、トークン数の変化によって引き起こされるTriton JITの繰り返し再コンパイルを排除したもので、8基のGPUすべてが歩調を合わせる必要があるマルチGPUクラスタでは重要である。これらの変更により、H200 GPUで最大10%のスループット向上と最大9%の初回トークン時間短縮が実現した。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
CINCは2026年10月26日、社内GEO/LLMOツールに、ChatGPTとClaudeが回答生成時に参照したページのURLを収集する機能を追加したと発表した
GitHubは10月の1週間で12億件超のコミットを記録したと発表した
AIsmileyは12月15〜16日にAIエージェント博2026を開催する
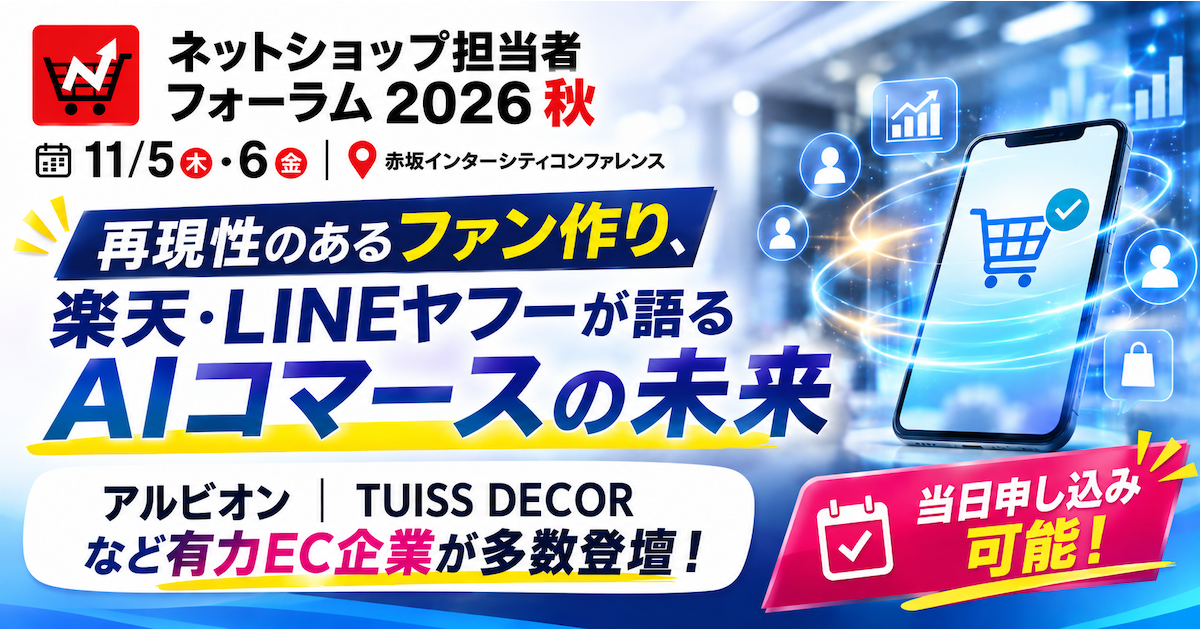
11月6日の「ネットショップ担当者フォーラム 2026 秋」最終日は、LINEヤフーと楽天グループがAIエージェント時代のEC戦略を語るセッションに加え、キッチンブランドSTOQの事例を実施
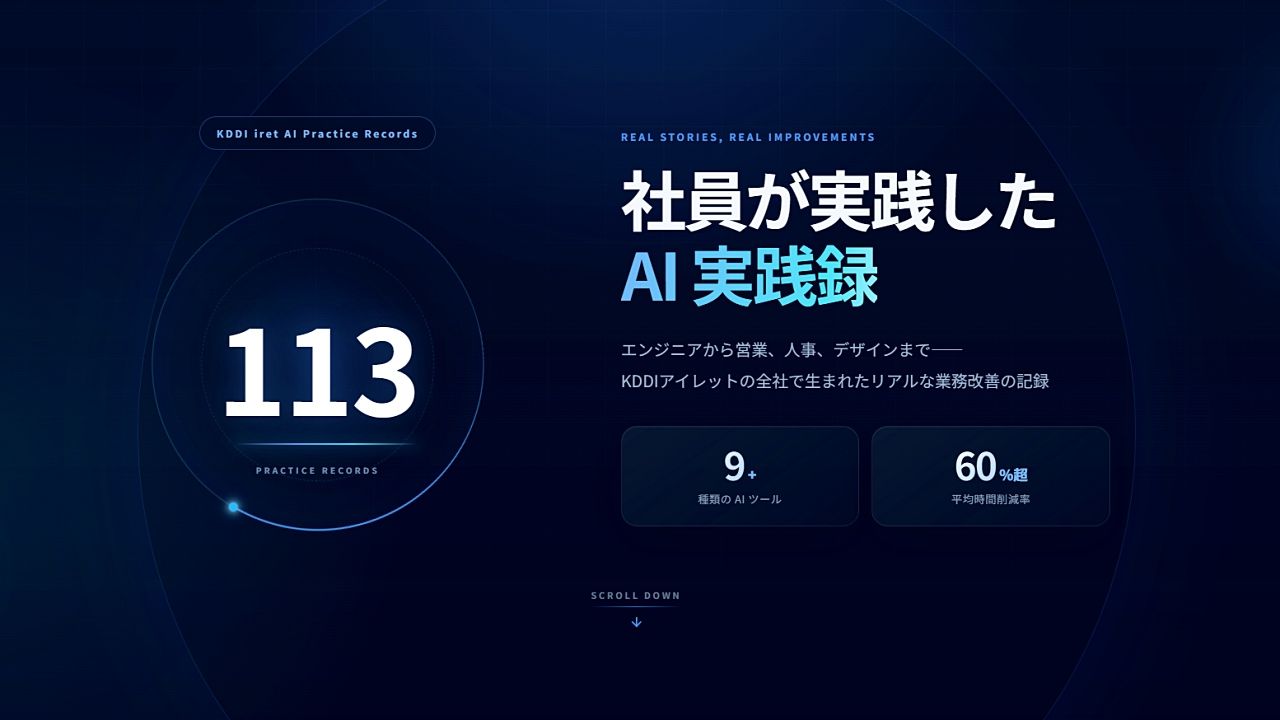
KDDIアイレットが社内のAI活用事例113件を無料公開
2026年10月29日にGoogleの渋谷オフィスで開かれたSimejiのビジネスミートアップで、Simeji事業責任者の古谷優氏が、Simeji PC AI音声入力に議事録機能を2026年11月にリリース予定と発表した