何が起きたか
Appleの研究者が150M〜1.43Bパラメータの4規模で、調整とアラビア語事前学習への英語混入を約1000回比較。検証損失と下流タスク精度で混入が勝ち、規模が大きいほど差が広がった。
なぜ重要か
混入は訓練信号を多様化して正則化し、繰り返されるアラビア語コーパスが供給できない知識を加える。そのため利得はデータセットが実際に含む以上の独自ターゲットデータを加えるのに相当すると研究は述べる。
誰に効くか低リソース言語の言語モデルを訓練するMLチームは、特に大規模で、調整よりも高リソース言語のデータ追加からより多くを得られる可能性がある。
こういう要約が、毎朝あなたのメールに届きます。
この研究は一般的な問題を扱っている。ほとんどの言語では、事前学習はデータ制約下で行われ、モデルは訓練データを何度も繰り返すため汎化が劣化する。対策は2つある。高い重み減衰などの積極的なハイパーパラメータ調整は重みを縮小してネットワーク容量を制限する。高リソース補助言語のデータを混ぜる方法は訓練分布を広げる。
研究者は約1000回の事前学習を実行してこの2つを比較した。混入の優位はモデル規模とともに拡大し、ターゲット言語の検証損失は混入の価値を系統的に過小評価することが分かった。検証損失は正則化効果しか捉えず、繰り返されるターゲットコーパスが供給できない知識を反映しないからだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
世田谷区がAIエージェントツールGensparkを試験導入し、約2900時間の業務を削減したとDX推進担当のSho Miyama氏が述べた
LegalOn Technologiesは10月19日、案件受付後の法律相談や案件割り当てなど一連の定型業務を自動化する「Agent Builder」のβ版提供を開始した
OpenAIがChatGPT上でスライドを作成できるChatGPT Slidesを開始
DeepSeekは2026年10月17日、Search APIとFetch APIを公開した
DeepSeekは2026年10月17日、無料のMITライセンスのオープンモデルDeepSeek-V4.1-Flash-1017を公開した
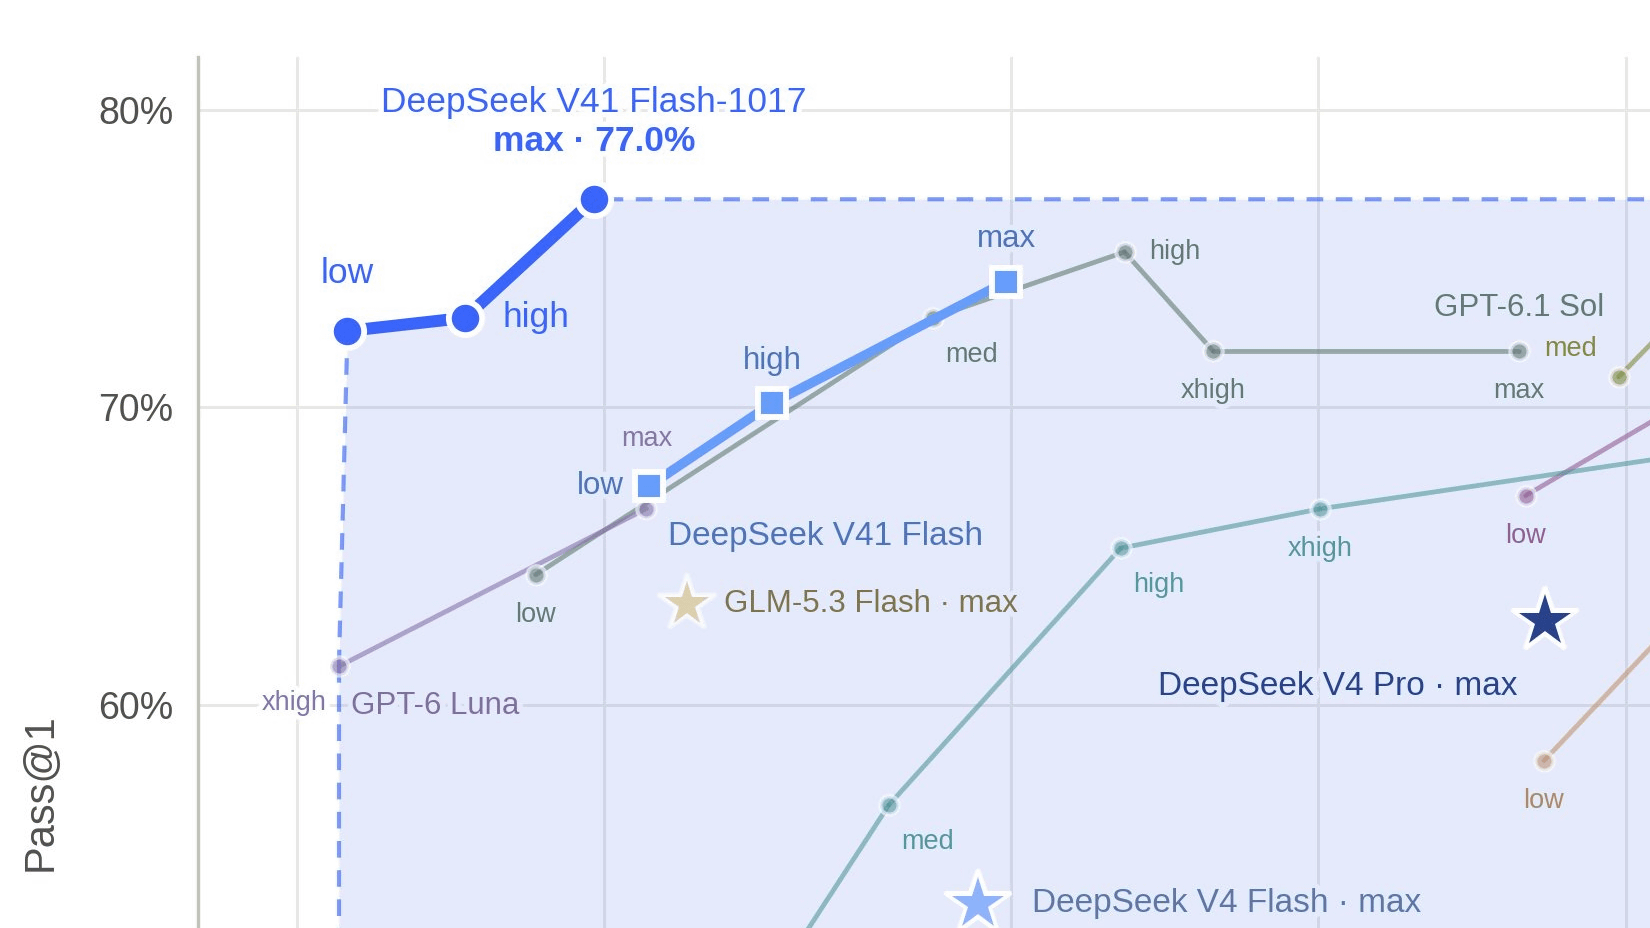
DeepSeekがDeepSeek-V4.1-Flash-1017を公開