何が起きたか
AWSがAmazon Bedrock Managed Knowledge Basesでエージェント検索を提供開始。maxAgentIterationはデフォルト5、2〜3では単発検索相当になる。
なぜ重要か
単一ベクトルでは複数意図を代表できず、証拠が十分かを問う工程がなかった。分解により難しい質問ほど再現率が向上するため、この仕組みが有効とみられる。
注目点
エージェント検索は呼び出しあたりのコストが高く、レイテンシも大きい。用途に応じて標準検索と使い分けることが焦点となる。
誰に効くか大規模なRAGシステムを運用する企業の情報システム部門やAIエンジニアは、複合的な問い合わせに対して検索の再現率を高められる一方、コスト増を踏まえたルーティング設計が必要になる。
こういう要約が、毎朝あなたのメールに届きます。
従来のRAGは、質問全体を1つのベクトルに埋め込み、類似度検索で上位チャンクを取得する方式が主流だった。しかし「2つのサービスを3つの観点で比較する」ような質問は、実質的に6つの意図を含む。1つのベクトルではその平均を取るしかなく、上位5件では6つの意図のうち2つを取りこぼすことがAWSの検証で示されている。取得件数を10件に増やせば6つすべてをカバーできるが、同じ観点が重複して取得され、無関係なチャンクも混ざるという無駄が生じる。
エージェント検索は、この構造的な限界に対処する。質問をサブクエリに分解し、それぞれを検索し、得られた証拠が十分かを判断し、足りなければ再度検索する。langchain-awsパッケージはこれを関数として公開しており、LangChainのチェーンに組み込むにはRunnableLambdaで包む必要がある。トレースイベントで計画内容を確認するには、boto3で直接APIを呼び出す。
この仕組みは、単発検索より呼び出しあたりのコストが高く、レイテンシも大きい。複数のモデル呼び出しが発生するためだ。したがって、すべてのトラフィックをエージェント検索に流すのではなく、質問の形状に応じて安価な標準検索と使い分けることが現実的とみられる。エージェント検索が真価を発揮するのは、分解すべき要素がある複合的な質問であり、単純な質問ではコスト増に見合わない可能性がある。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Ghost AIはAndreessen Horowitzがリードし、Abstract、Audacious Ventures、Nova、SV Angelが参加した1100万ドルの調達を実施
OpenAIは数週間以内にEUの全ChatGPT・Codex有料プランユーザーへ不可視のテキスト透かしを展開し、検出ツールtextGrainの報告書を公開
スタンフォード大学やMicrosoft Researchなどの研究チームが最先端AIモデル8種類に6800以上のタスクを実行させた結果、32%のケースで低価格モデルの総コストが高くなった
Reflectionがパラメーター数5010億・アクティブ230億のオープンモデルBeamを発表
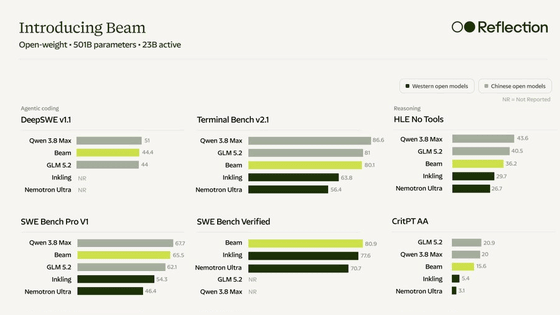
Reflection AIが5010億パラメータのオープンソースLLM「Beam」を公開
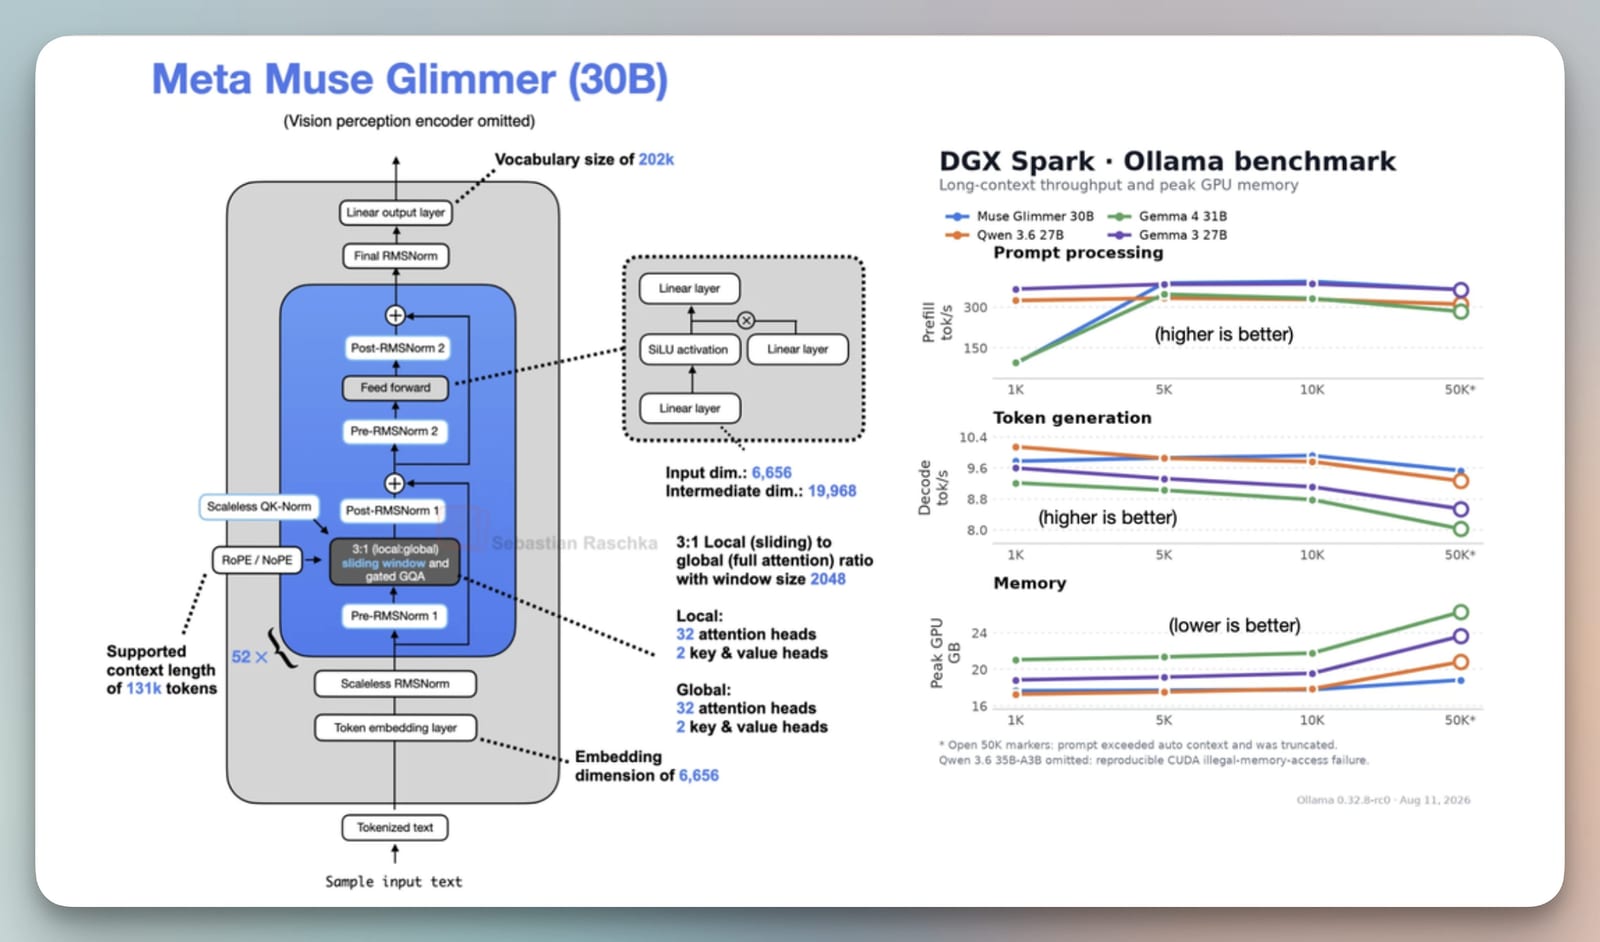
Meta Superintelligence Labs初のオープンモデルMuse Glimmer(30B)がApache 2.0で公開され、0.44%のLoRA訓練で数式画像からLaTeXへの変換を改善できる