何が起きたか
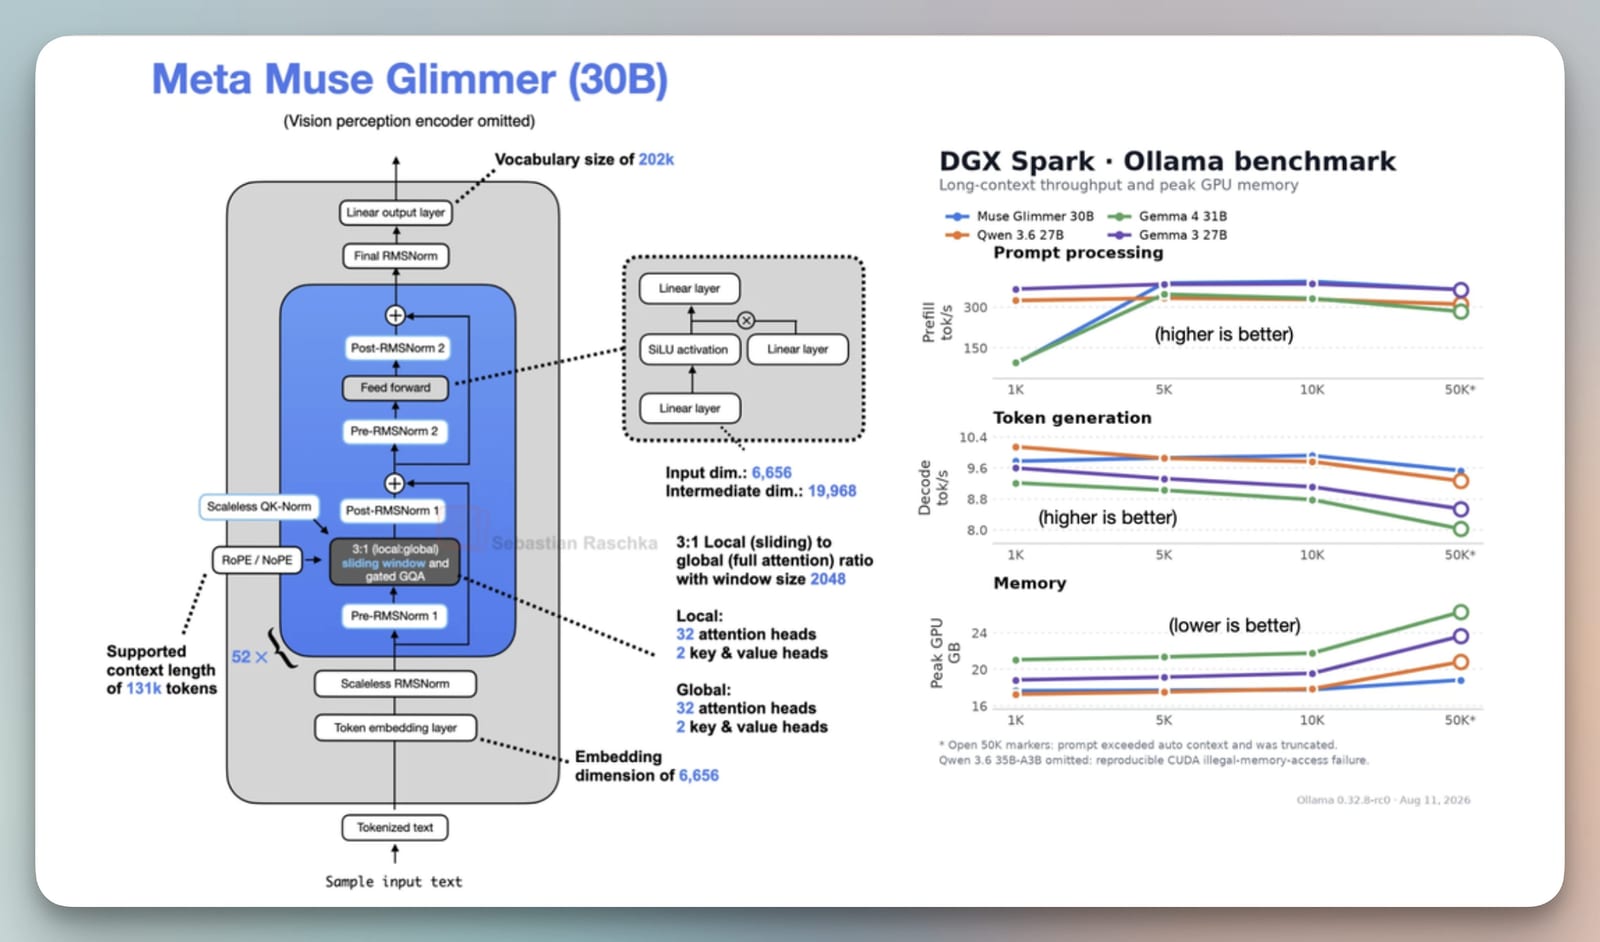
Meta Superintelligence Labs初のオープンモデルMuse Glimmer(30B)がApache 2.0で公開され、0.44%のLoRA訓練で数式画像からLaTeXへの変換を改善できる。
なぜ重要か
Apache 2.0なので商用利用や名称変更が自由で、LoRAで追加訓練できるため自社の出力形式に合わせやすいとみられる。
注目点
30ステップ後も細かい記号認識は完全ではなく、実運用にはエポック単位の追加訓練が焦点となる。
誰に効くか自社サーバーや外部ネットワークから切り離した環境でAIモデルを運用したい情報システム部門や、数式・帳票など定型出力を自前モデルで処理したい開発チームに影響する。
こういう要約が、毎朝あなたのメールに届きます。
Muse GlimmerはMetaのフロンティアモデルMuse Sparkから蒸留され、エージェント向けデータで追加訓練された30Bの視覚モデルである。Llama 4以来となるMetaのオープンリリースであり、LlamaライセンスではなくApache 2.0を採用した点が大きい。これによりユーザー数上限や利用ポリシー、ブランド表示の義務なしに商用利用や名称変更が可能になる。
モデルは約29.6Bパラメータのデコーダと1.8BパラメータのViT-G/14視覚エンコーダを組み合わせ、テキストと画像を入力してテキストを出力する。長いコンテキストでもKVキャッシュを約60分の1に抑える設計により、131Kトークンのコンテキストを自前のハードウェアで扱える。また独自のチャット形式ATEMを採用し、推論の強さを調整するダイヤルを持つ。
数式画像からLaTeXへの変換タスクでは、LoRAで0.44%のパラメータを訓練することで出力形式の不一致を解消できる。ただし30ステップでは細かい記号認識が完全ではなく、実用化にはエポック単位の追加訓練が必要とみられる。自社の出力形式に合わせたモデルを求める開発チームにとって、訓練コストと精度のバランスが焦点となる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Reflection AIが5010億パラメータのオープンソースLLM「Beam」を公開
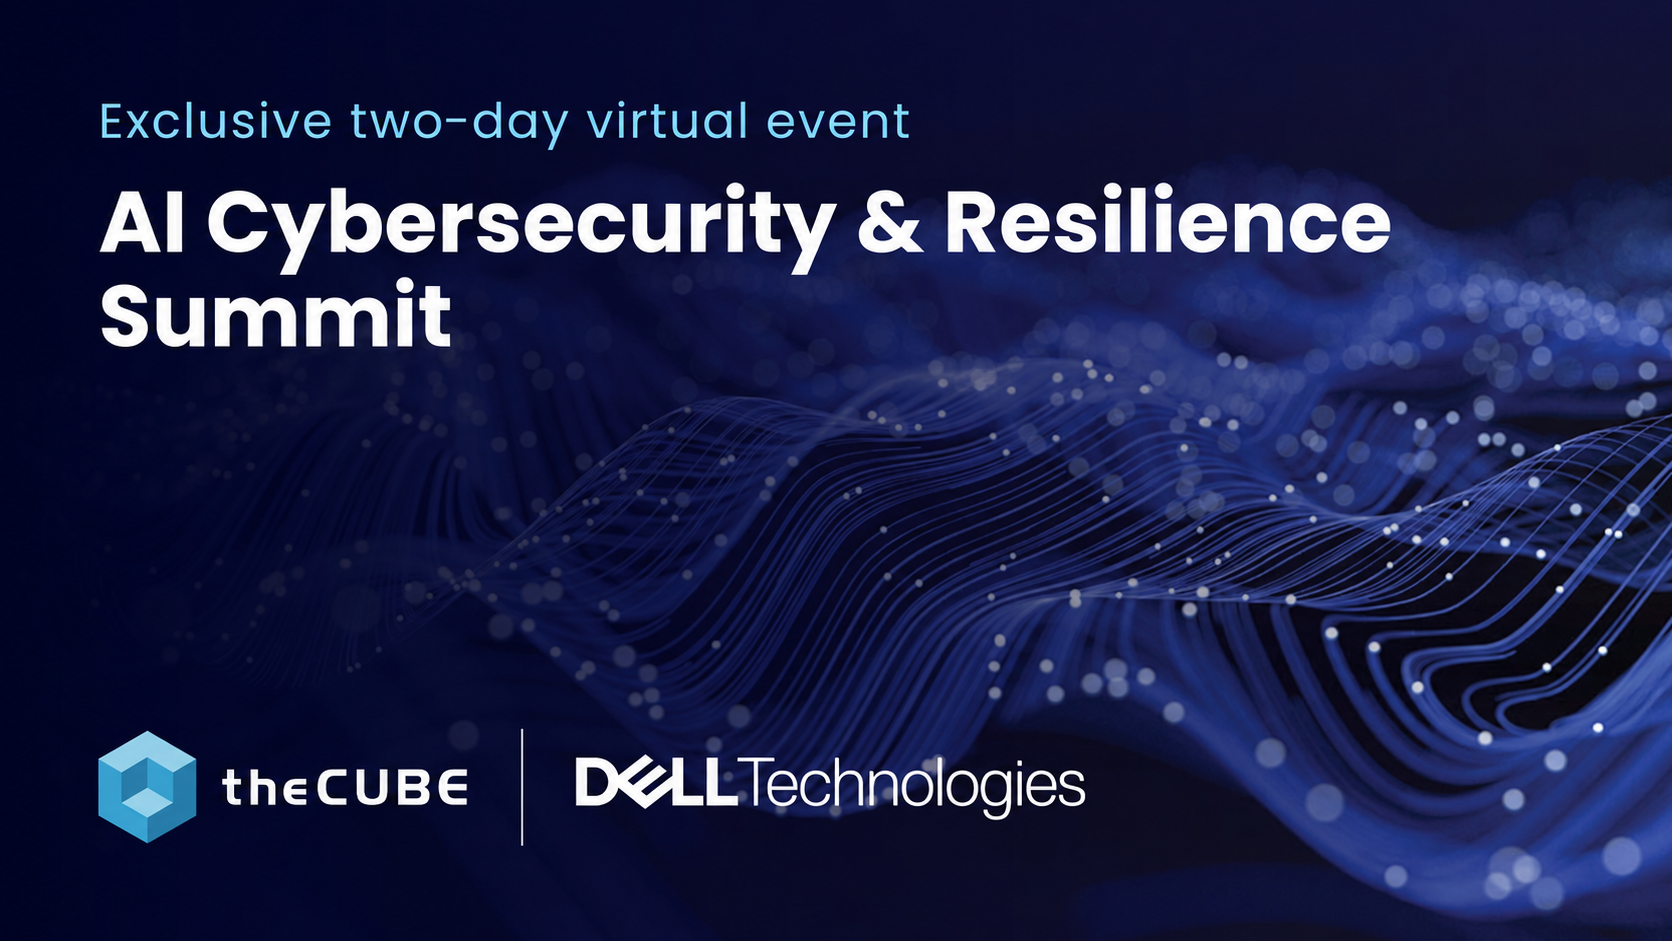
AIサイバーセキュリティ・レジリエンス・サミットでは、10月27日にDell Technologies主導のフラッグシッププログラムが行われ、28日にはInfoScaleとInfinidat Ltd.の視点が続く
シュナイダー・エレクトリックがソフトウェア企業PTCの買収に合意
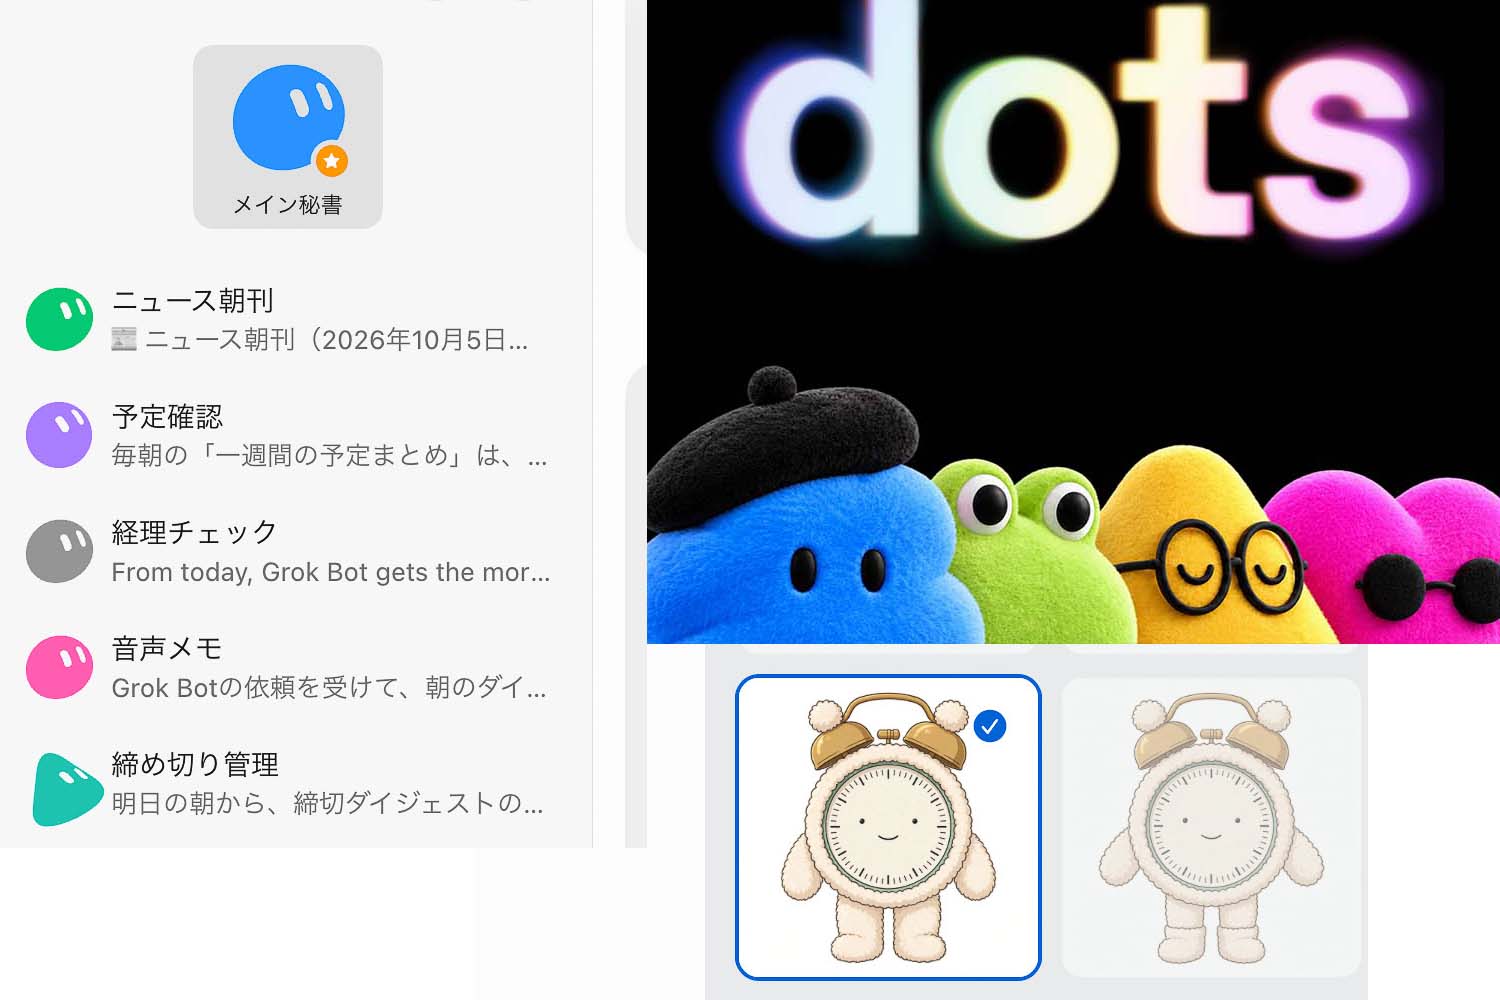
OpenAIが9月30日に常時動作型AIエージェント「Dots」を発表した
schema-guardは実テーブルとカラムのスナップショットをリポジトリに保存し、エージェントのSQLを実行前に照合する
Zenn投稿者が「Anchored Bond(相互人質プロトコル)」を公開


