
何が起きたか
QiitaのレビューがLooped Transformerの系譜を2018年のUniversal Transformers、Giannou et al.の2023年のprogrammable-computer論文、ByteDance SeedのOuroまでたどる。Ouroは1.4Bと2.6Bパラメータのモデルを最大7.7Tトークンで学習した。
なぜ重要か
同レビューは同一ブロックの反復を単なる重み共有ではなく、深さをアルゴリズムの反復ステップとして扱い、パラメータ数と実効的な深さを切り離す手段と位置づける。
注目点
モデルが問題ごとに必要なループ回数を学習できるか。8ループで学習したモデルが100ループで改善するとは限らず、単純な停止ゲートが常に最適とは限らないとレビューは指摘する。
誰に効くかこの要約は、効率的なLLMアーキテクチャを追うエンジニアと技術的意思決定者、そしてパラメータ削減が実際にレイテンシや推論の向上につながるかを評価する研究者に届く。
こういう要約が、毎朝あなたのメールに届きます。
このレビューの著者は、Looped Transformerを「Transformerを同じ層に数回通すだけ」と分類してそこで止まっていたと自認している。論文を追えば、その説明では終わらないと著者は論じる。2018年のUniversal Transformersはすでに自己注意を深さ方向に再帰的に適用し、トークンごとに計算を停止するAdaptive Computation Timeを加えていた。現在のアイデアの初期版である。変わったのは枠組みだ。Giannou et al.はループをモデルを縮める手段ではなくアルゴリズムを実行する装置として扱い、Yang et al.は通常の学習で反復アルゴリズムの挙動が再現されるかを検証した。レビューは、その後の研究で追加された入力注入の工夫にも触れる。各ループで元の入力を再び加算し、初期の情報が隠れ状態に埋もれないようにするものだ。
その後の論文は規模と適応性を押し進める。800Bトークンで事前学習した3.5Bパラメータのモデルは、推論時に追加のループを回すと数学とコーディングで改善を示し、Ouroはこの手法を1.4Bと2.6Bパラメータ、最大7.7Tトークンへと引き継ぎ、難しい入力ほど多くの深さを消費する適応的計算を追求した。
レビュー自身が抱く未解決の問いは、これが本当に思考なのかという点だ。ループごとに変化する隠れ状態は、あるループが抽出し、別が推論し、また別が検証している証拠にはならない。各ループが何を更新するのか、ループ回数が問題の難易度を反映するのか、モデルが学習時のループ回数を超えて外挿できるのかが明らかになるまでは、結果は停止判断を安定的に学習できるかどうかにかかり得る。アーキテクチャを比較する購入者にとっては、パラメータ削減が実際の推論コストに耐えるかどうかにかかっている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
RRSIは自己改善エージェントの編集数を上限設定し段階的に削減、批評器がベンチマーク固有の小細工を排除
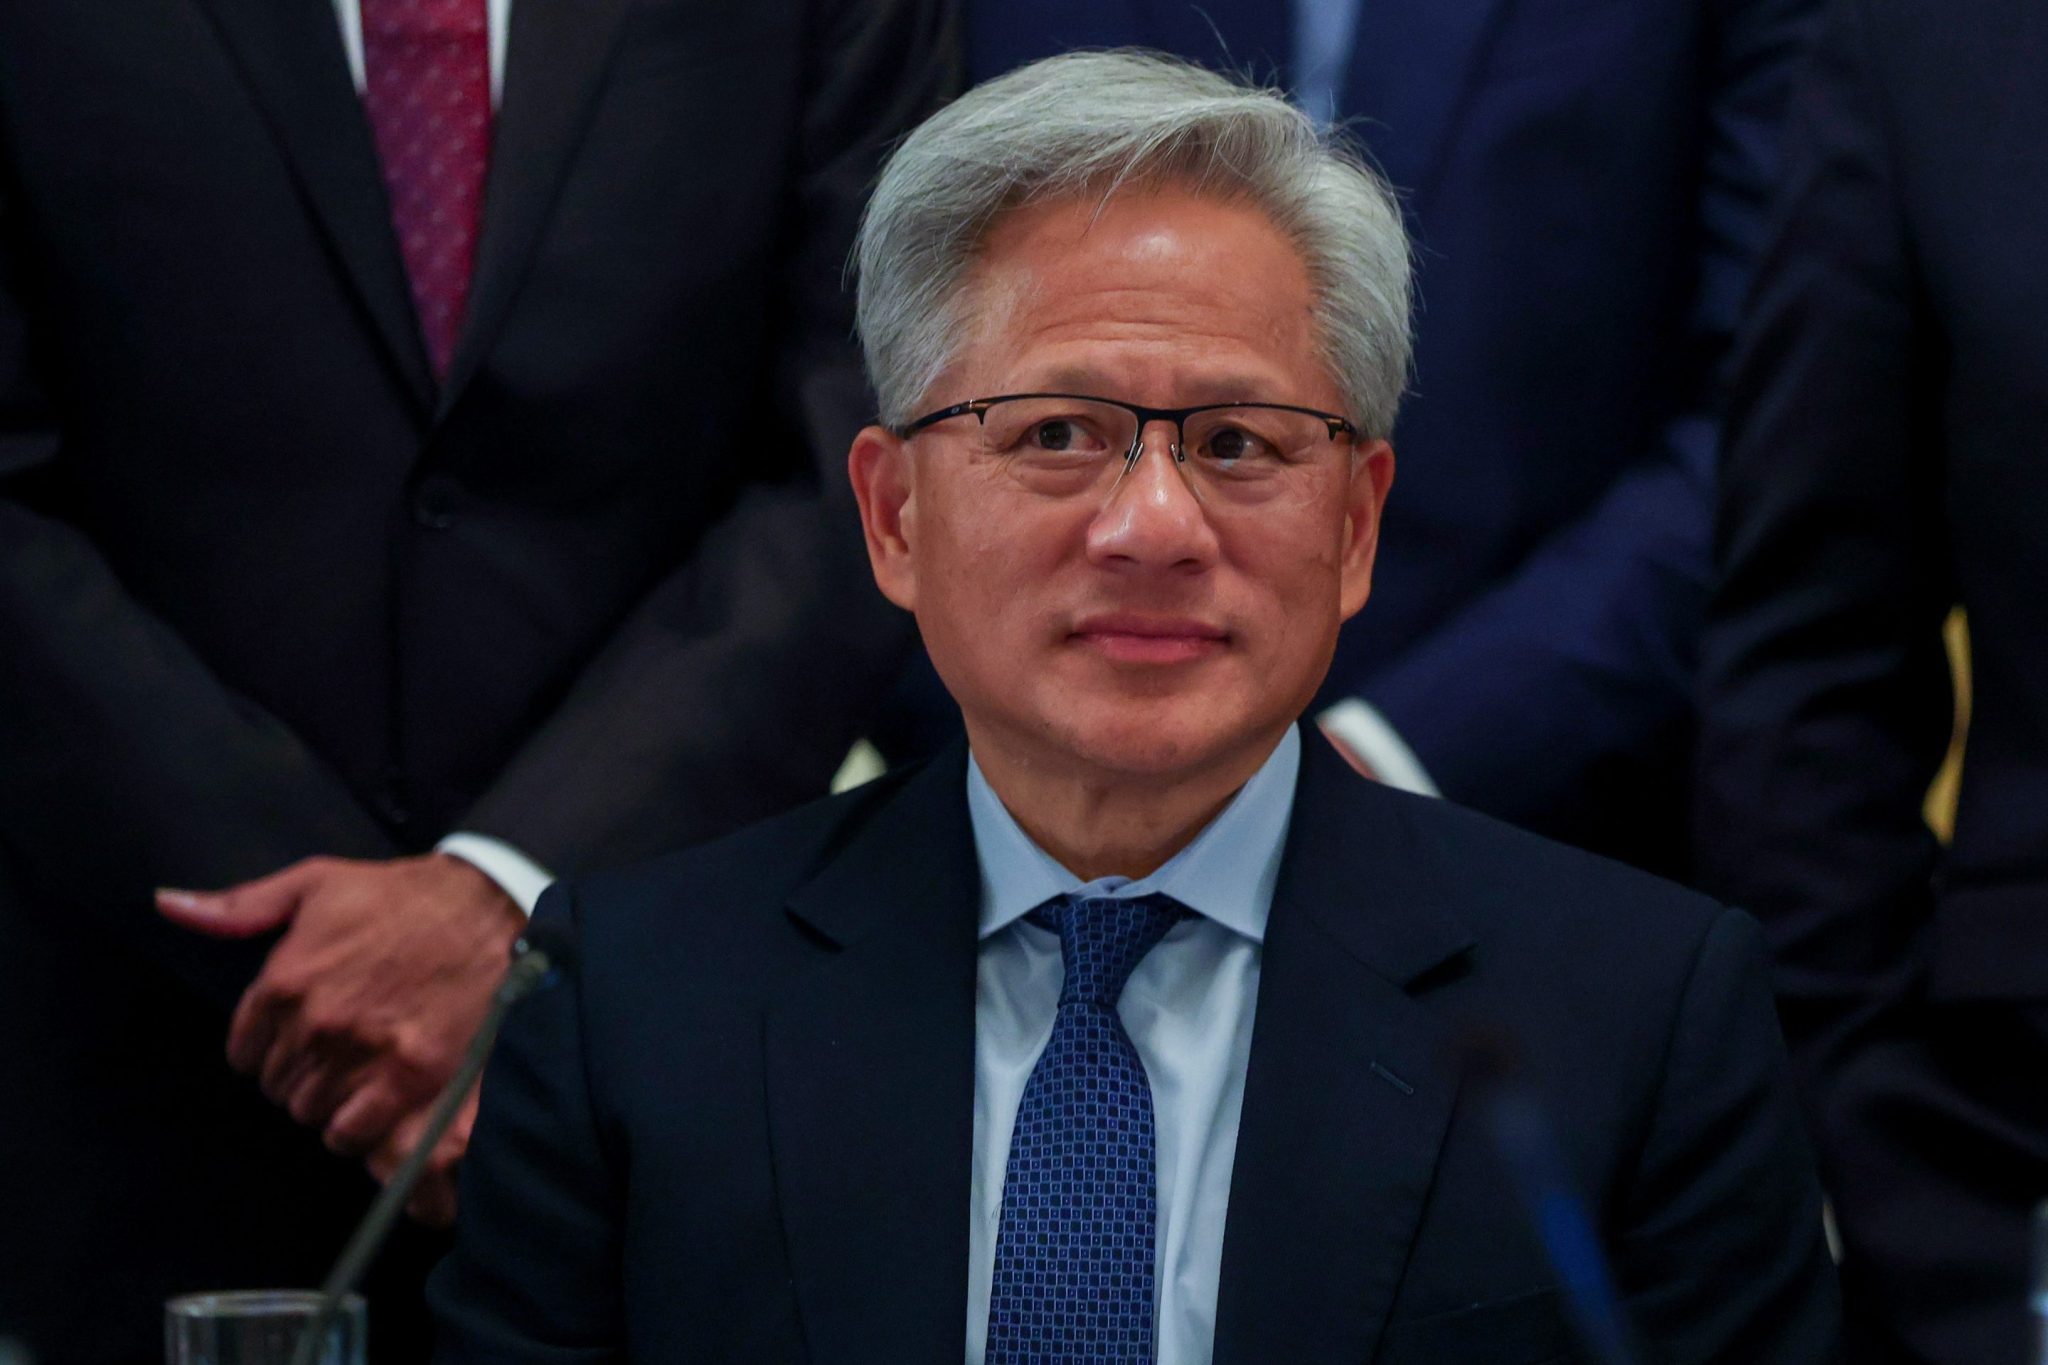
Nvidia CEOのJensen Huang氏はSam Altman氏とDario Amodei氏の「終末論」を「無責任」と批判し、月曜にNvidiaはOpen Agent Safety Platformを投入した
AIが構成づくりや言い換えを代行し作業は速くなったが、しばらくすると何を作りたいのかわからなくなり、着手までの時間が延びた

設計ガイドは、通話を信頼できない入力として扱い、処方更新のスタッフタスク作成などの許可操作をワークフローサービスが決めるべきだとする
Claude Codeプラグインpersona-feedbackがv0.2.0に
著者はPythonとClaude Codeだけで小規模事業のサイトを構築

