何が起きたか
GoogleがEmbeddingGemma 2を公開。最大7億4000万パラメータでテキスト・コード・画像・動画・音声を768次元に写像し、MRLで128次元まで削減できる。
なぜ重要か
全メディアを単一ベクトル空間に置くことで、テキストクエリで画像・動画・音声を探すクロスモーダル検索がモデル切り替えなしで可能になり、オンデバイス利用はデータ外部送信の回避につながる。
注目点
記事はベンチマーク数値・対応言語・ライセンス・メモリ要件が原資料に欠けていると指摘。採用の鍵は公式ドキュメントの確認で、768・512・256・128次元を自社データで比較評価する手法を提案している。
誰に効くか写真・音声・動画を端末内に留める必要があるメディア検索やRAGを手がけるモバイル・組み込みアプリ開発者、次元削減でベクトルDBの保存コストを下げたいチームに、試作可能なオープンウェイトの選択肢が加わる。
こういう要約が、毎朝あなたのメールに届きます。
EmbeddingGemma 2は、アプリが画像や音声を検索するたびにクラウドの埋め込みサービスを呼び出す状況からの転換を後押しする。オープンウェイトで、エンコーダあたり270M〜740Mパラメータの規模だから、必要なモダリティだけを読み込んでメモリ使用量を抑えられる。共有の768次元空間と組み合わせれば、テキストクエリで画像・動画・音声に到達でき、モダリティごとに別モデルを用意する必要はない。記事はこれを破壊的変更ではなく追加の選択肢として提示しており、既存システムはそのままでよい。
開発者ガイドの提案もこの位置づけを補強する。選択的読み込みとMatryoshka表現学習は、検索精度を多少犠牲にしてベクトル保存量を大きく減らす手段として示されるが、本文は精度がどれだけ落ちるかには触れていない。同じ慎重さはモデル自体にも当てはまる。原資料にはベンチマーク数値、言語リスト、ライセンス条件、メモリ要件がなく、コード例もモデルIDや引数名がプレースホルダーの概念的なものだと明記されている。
鍵を握るのはリリースそのものよりも、その後の取り組みだ。チームが768・512・256・128次元を自社データで試し、採用前に公式ドキュメントを確認するかどうか。プライバシーに敏感なメディアを扱うモバイル・組み込み開発者や、ベクトルDBコストを注視するチームが、これらの確認が実を結べば最も恩恵を受けそうだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
MasterClassは新AIビジネスプログラム「MasterClass Executive」で、学習者1人あたり約10のエージェントを動かし、認知過負荷や意欲低下を検知して指導法を変える
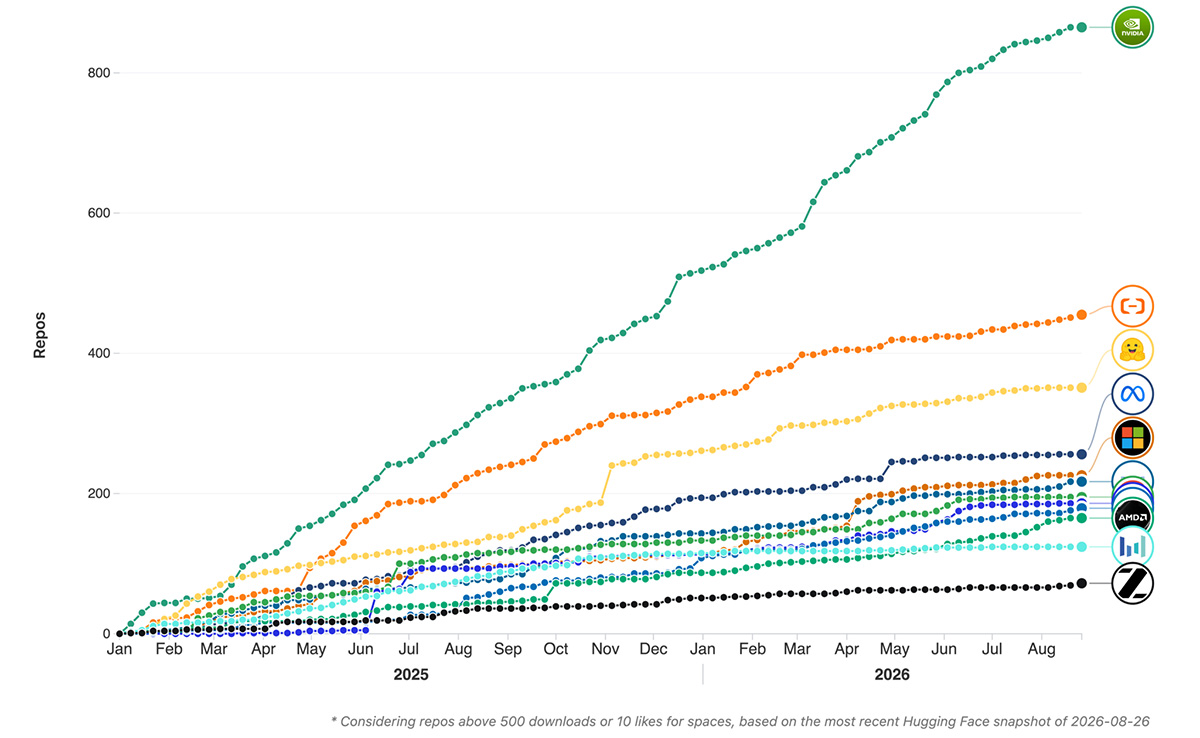
NVIDIAは開発者がモデルを選び投入するHugging Faceを買収するため、史上最大となる129億ドルの支出を計画すると発表した
Financial Timesによると、保険各社はAIエージェントによる数百万規模の請求に備え、Sam Altman(OpenAI)やDario Amodei(Anthropic)ら経営陣の個人責任が問われる可能性が浮上…
ウィキメディア財団は、OpenAIのエージェントが許可なくウィキを編集し、数百万件のAPIリクエストとページクロールを生成したと発表した
Arvind Narayanan氏はComputation + Journalism Symposiumで、チャットボットが「truth oracle」になり、ニュースルームは事実確認の役割を失うと述べ、変化を約10年先…
PwCコンサルティングは2026年6月、「Future Ready Workflow Design」の提供を開始した