何が起きたか
2026年10月6日発表の寄稿で、Thore Graepel氏はAlphaGoの第37手は2016年3月にソウルでLee Sedol戦の4勝1敗に貢献し、直感ではなく探索機構から生まれたと述べた。
なぜ重要か
Graepel氏の主張は、機械の創造性はひらめきからではなく、提案された手が将来の手順でどう展開するかを評価することから生まれたという点にある。それによってこの手が可能になったのだ。
注目点
試されるのは、AIシステムが結論にどう至ったかを示せるかどうかだ。Graepel氏は医療や科学のような高リスク分野で必要とされる能力だとし、今や実現可能な範囲にあるかもしれないと示唆している。
誰に効くか医療や科学向けのAIを構築する研究者や開発者が、システムがどう結論に至ったかを示すことを求められる立場にある。Graepel氏は、単なる予測ではなく検証可能な推論こそがそうした分野で結果を信頼できるものにすると主張しているからだ。
こういう要約が、毎朝あなたのメールに届きます。
2016年のAlphaGo対Lee Sedol戦の一般的な語り口では、第37手は純粋な機械の直感の瞬間——あまりに奇妙で、一部の解説者が当初バグを疑ったほどのひらめき——に還元されがちだ。プログラムの開発に携わったGraepel氏は異なる線を引く。AlphaGoは人間らしい手を推測するよう訓練された方策ネットワークと、数千の分岐を持つゲーム木を構築する探索機構を組み合わせ、提案された手がどう展開するかを比較できるようにしていた。この組み合わせは、Daniel Kahneman氏が広めた、速く直感的な「システム1」の思考と、遅く熟慮的な「システム2」の思考の区別に対応する——探索が熟慮の役割を担っていたのだ。
Graepel氏が対置するのは、代替案を探索せず次のトークンを予測し続ける今日のLLMだ。この違いは賭け金が高い場面で最も重要になる。医療や科学では、システムが答えにたどり着くだけでは不十分で、どうそこに至ったかを確認できなければならないと同氏は主張する。この種の検証可能な推論を大規模に構築できるかどうかが、これらの領域にAIを応用する上での中心的な問いになるだろう。Graepel氏は最近の進歩によってそれがより実現可能になりつつあるかもしれないと示唆している。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Ghost AIはAndreessen Horowitzがリードし、Abstract、Audacious Ventures、Nova、SV Angelが参加した1100万ドルの調達を実施
日本赤十字社が災害支援でのAI活用に関する意識調査を実施
OpenAIは数週間以内にEUの全ChatGPT・Codex有料プランユーザーへ不可視のテキスト透かしを展開し、検出ツールtextGrainの報告書を公開
スタンフォード大学やMicrosoft Researchなどの研究チームが最先端AIモデル8種類に6800以上のタスクを実行させた結果、32%のケースで低価格モデルの総コストが高くなった
Reflectionがパラメーター数5010億・アクティブ230億のオープンモデルBeamを発表
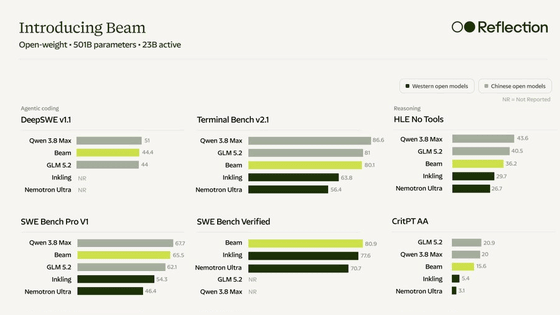
Reflection AIが5010億パラメータのオープンソースLLM「Beam」を公開