何が起きたか
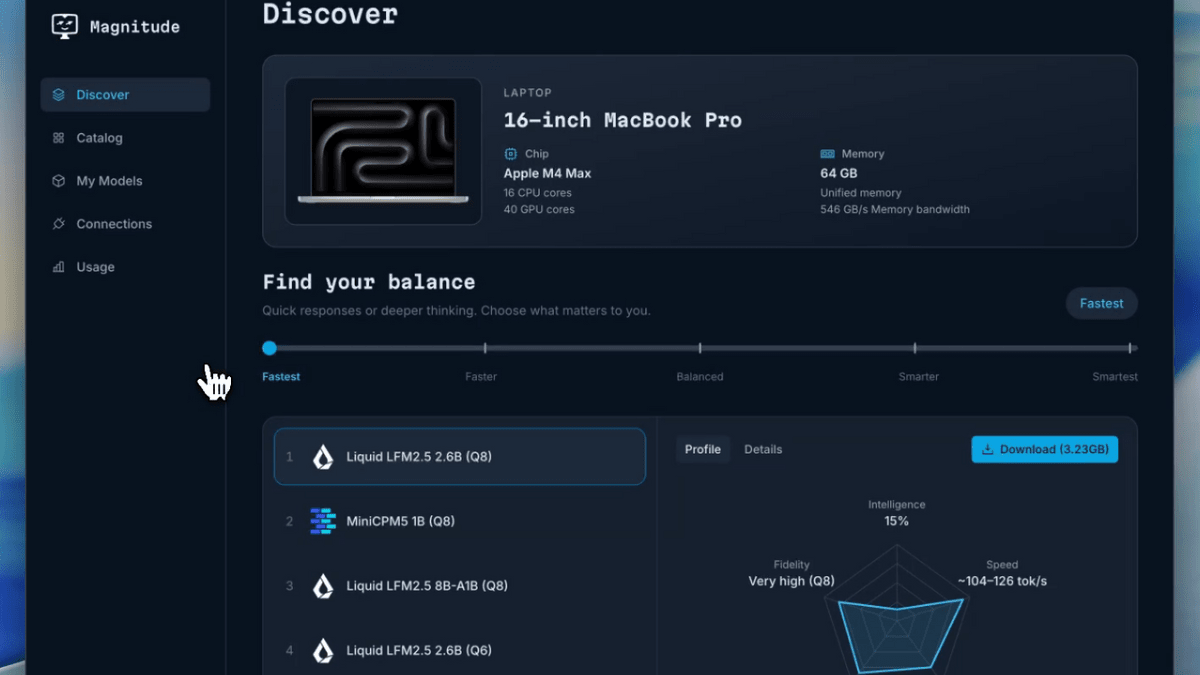
Magnitude開発チームが、PC上でモデルカーネルをコンパイル・調整するオープンソース推論エンジンを公開。特定条件下でllama.cppの約2倍の速度を記録。
なぜ重要か
AIエージェント向けのローカル実行は、データセンター向けバッチ処理や幅広いハードウェア対応を前提としたエンジンに依存してきた。Magnitudeの端末上チューニングはその隙間を狙う。
注目点
2倍という数字は特定条件下のみ。Expert streamingやマルチデバイス最適化の拡充で利点が再現するかが焦点。
誰に効くか最も直接的な対象は、自分のノートPCやデスクトップでAIエージェントを動かす開発者や小規模チームだ。Magnitudeはまさにその構成を狙っている。ローカルでのエージェント導入を検討するITチームにとっては、生の速度と同じくらいメモリ節約が重要かもしれない。
こういう要約が、毎朝あなたのメールに届きます。
Magnitudeチームの出発点は、推論エンジンの通常の作られ方と、ローカルAIエージェントの実際の動かし方のミスマッチにある。データセンター向けエンジンは大量リクエストのバッチ処理に最適化され、llama.cppのようなプロジェクトはできるだけ多くのハードウェアをカバーすることを優先する。チームの見方では、どちらもエージェントをPCで長時間動かす用途——繰り返しのファイル読み込み、コマンド実行、しばしば複数エージェントの同時稼働を伴うワークロード——に合っていない。
彼らの答えは、カーネルと呼ばれる小さな計算単位をモデルを実行するマシン上でコンパイルし、パラメータもそこで調整することだ。同じAppleシリコンやNVIDIAのファミリー内でも製品ごとに性能やメモリ配置が異なるため、幅広い互換性向けの汎用カーネルよりデバイス固有のチューニングが勝るという理屈だ。チームのベンチマークは4bit量子化したQwen 3.6 35B A3Bを64Kトークンのコンテキストで使い、MacとNVIDIA DGX Sparkの両方でllama.cppと比較した。
速度だけでなく、長時間稼働と並列利用にも対処している。Magnitudeはモデルの重みを保持するのに必要な分だけメモリを確保し、セッションが長引くにつれて領域を拡張、エージェントが停止すると解放する。共有プレフィックスキャッシュはセッション間で共通するシステムプロンプトの計算を再利用する。チームは次の展開も示している。Expert streaming、カーネル構成を自動で決めるコンパイラ、CPU・GPU・RAM・ストレージをまとめて最適化する取り組みだ。これらの機能が搭載される中で初期の利点が持続するかが未解決の問いである。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Microsoftが初のストリーミング文字起こしモデルMAI-Transcribe-2-Streamingを公開
Microsoft AIはMAI-Transcribe-2-Streamingを公開
Googleは9月30日にGemini 4 Argonを発表
Black Forest Labsが基盤モデルFLUX 3を使うFLUX 3 Imageを公開
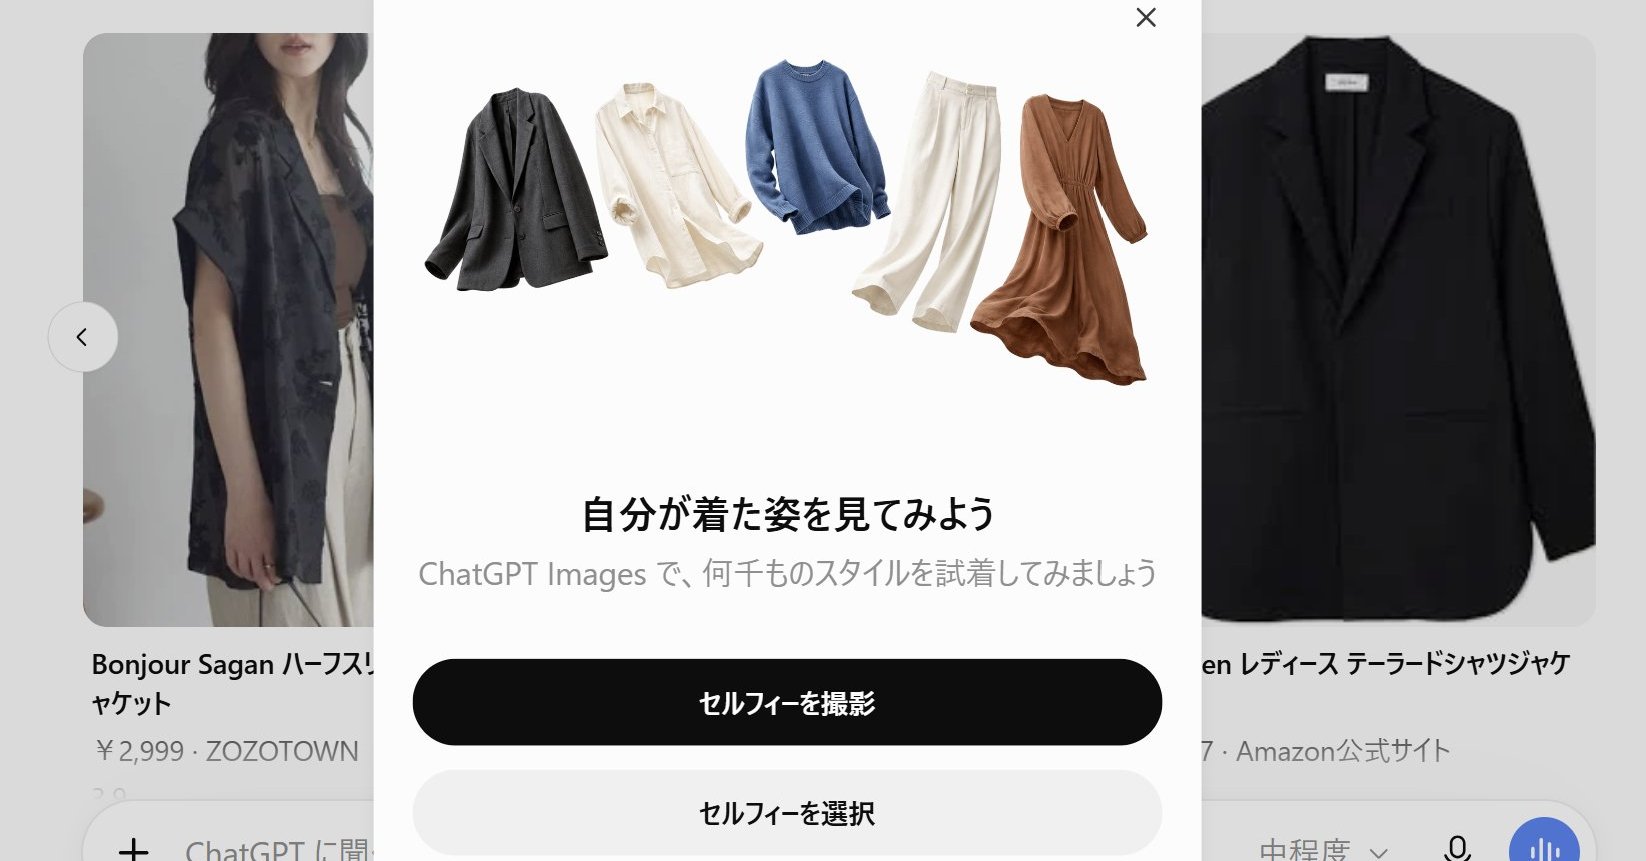
OpenAIは10月1日、ChatGPTのリリースノートを更新し、ウェブとモバイルの商品カードに服やアクセサリーの「試着」ボタンとお気に入り保存、iOSカメラの「スキャン」機能を追加した
Anthropicはウェブ版claude.aiとデスクトップアプリを2週間で約3倍高速化したとし、改善点はClaude自身が見つけて修正したと述べた