何が起きたか
Qualcomm Dragonwing RB3 Gen 2(QCS6490)上のYOLOv11-Nは、Qualcomm AI Hubで、デフォルトTFLite経由134.7 ms、w8a8 QNN経路5.03 msだった。
なぜ重要か
同じモデル・同じハードウェアでも結果が大きく異なるため、実行経路を欠いたレイテンシ値は真のベンチマークではないことを示す。
こういう要約が、毎朝あなたのメールに届きます。
動いているように見えるモデルでも、ネットワークの大半をGPUとCPUで静かに実行している可能性がある。デフォルトのTFLite経路では、343レイヤーのうちNPUで実行されたのは19のみで、168レイヤーがGPU、156レイヤーがCPUに割り当てられた。レイヤーごとのプロファイルがなければ、134.7 msをチップの性能として記録し、この誤配置に気づくことはない。
失敗も同様に示唆に富む。事前コンパイル済みFP32モデルは、デバイスが量子化されたI/Oを要求するため拒否された。w8a16 QDQ変換は終了コード14のみを返し、qualcomm/ai-hub-models#364で上流の問題が提起された。QNN DLC FP32モデルはコンパイルできたが、実機でMODEL_GRAPH_ERRORにより失敗した。コンパイル成功は実行成功ではないという戒めである。
Galaxy S25の対照実行が重要なのは、問題を切り分けられるからだ。フラッグシップスマートフォンでは、デフォルトのTFLiteデリゲートでも全レイヤーがNPUに配置され、約2.9 msだった。著者はRockchipボードでも同じ失敗パターンを確認しており、RKNNモデルはオペレーターごとに黙ってCPUにフォールバックする。結論は、実行環境、精度、レイヤー配置を欠いたレイテンシ値は不完全であり、遅いNPUと仕事を割り当てられなかったNPUを区別できる唯一の証拠はレイヤープロファイルだということである。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
コクヨは議事録や設計書、タスクをNotionとNotion AIに集約し、ClaudeとNotion MCPを連携させ、約100人規模の開発組織でAIエージェントが文書品質の確認や情報参照を行えるようにした
スタンフォード大「The Modern Software Developer」を教えMonacoでAIを率いるMihail Eric氏が、スタンフォード大CS146Sコース第2回にオープンソースのメンテナーを招いた
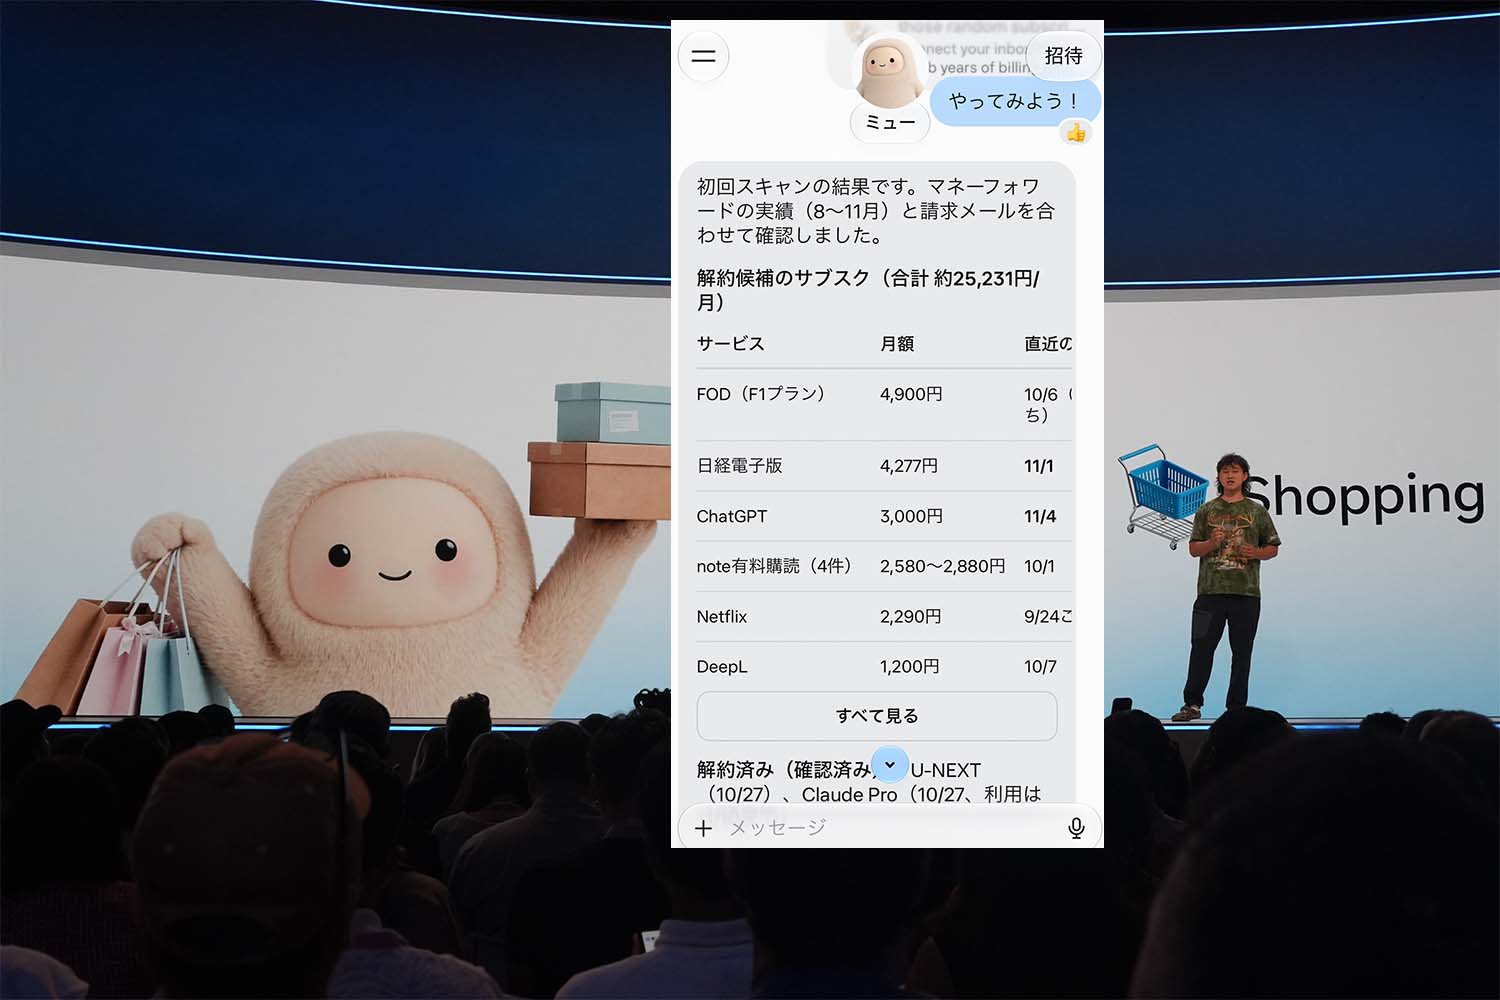
西田宗千佳氏はWatch Impressのコラムで、MetaのMuseがサブスク棚卸しや最安の電力プラン、買い物支援を提案する一方、AmazonのAlexa+は価格を追跡し確認後に注文できると述べた
Rockchipのrknn-llmマルチモーダルデモをQwen2-VL-2B-Instructで試すとtransformers 5.8.0はAttributeError、4.57.0と4.54.xはTypeError、4…
Fast Companyの報道によると、ゴールドマン・サックスはエンジニア以外の従業員による高度なAIツールの利用を禁止した
VisaのAgentic Commerce Benchmarkが12の研究所のAIモデル22種をテレビやノートPCの購入などの買い物タスクでテスト