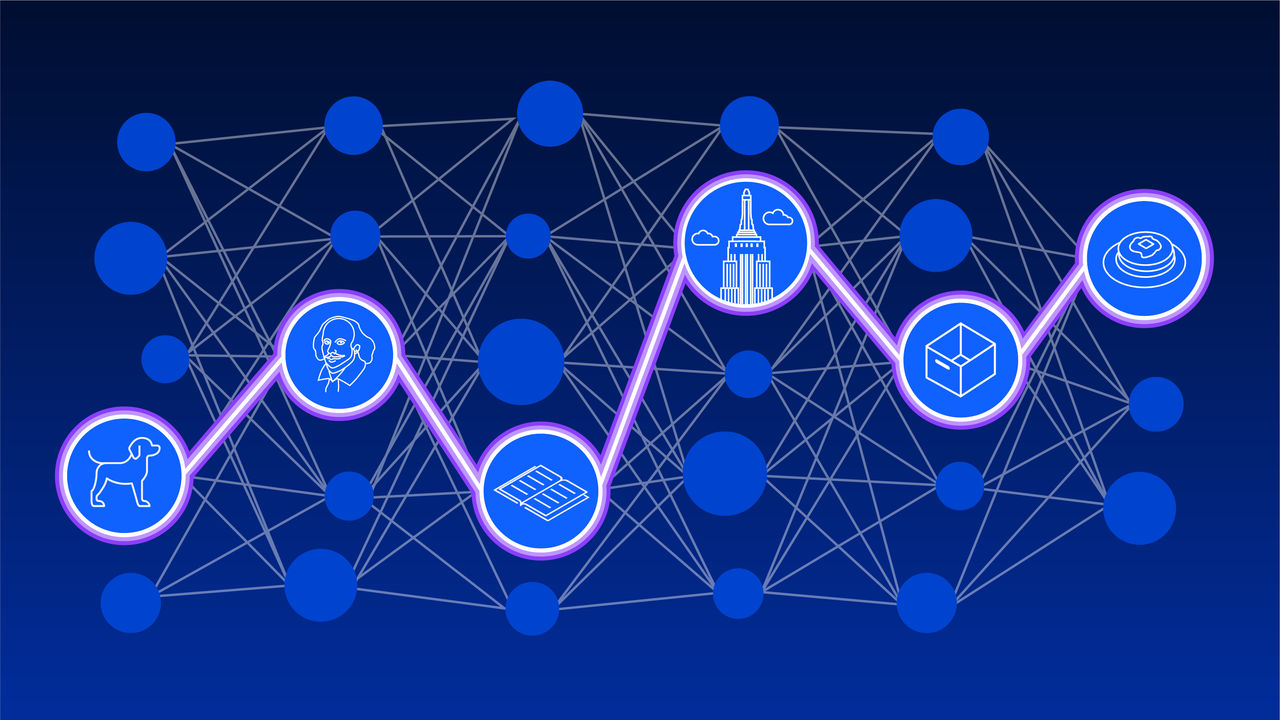
何が起きたか
プログラミング経験のない執筆者が、ChatGPTのような大規模言語モデル(LLM)がどのように実装されているかを理解しようと調べ始めた。数週間の調査の結果、AIシステムは本質的に表計算シートのように配列された数字の巨大なグリッドで構成されていることを結論づけた。例えば、GPT-3には577個の「スプレッドシート」(技術用語では「テンソル」)が含まれており、合計1,750億個の数字を保有している。
なぜ重要か
この執筆者は、AIが不可解な「ブラックボックス」であるという一般的な仮定に異議を唱えている。複雑さにもかかわらず、実はLLMの内部を見ることができ、その機能を理解することが可能だと主張している。この理解が重要な理由は、AIの謎を解く取り組み(専門家と一般人の両方による)がAIを安全に保つために不可欠だと彼が信じているからである。AIが「表計算シートのように見える」という認識により、これまで抽象的だった技術が具体化され、非技術的な聴衆にとって把握可能になる可能性がある。
注目点
この執筆者の比喩はすぐに破綻する。GPT-3の最初のスプレッドシートは本質的に単語を数字のベクトルにマッピングする辞書(50,257個の単語、それぞれに12,288個の数字を割り当て)であるが、残りの576個のスプレッドシートはより複雑な数学的演算を実行し、その目的の説明にはより深い掘り下げが必要である。著者は、これを数字が実際にどのようにインテリジェントな出力を生み出すかを説明する旅の始まりとして位置づけている。
こういう要約が、毎朝あなたのメールに届きます。
執筆者の探求は、AIシステムが公開される方法と実際にどのように機能するかについての、より広い乖離を反映している。「ブラックボックス」という表現は、AIの内部動作が未知であることを示唆する便利な言い方になっているが、執筆者はこれが少なくとも部分的には神話であること、またはひどく単純化されていることを示している。GPT-3のアーキテクチャはよく文書化されている。それは本質的に数学的構造であり、魔法ではない。577個のスプレッドシート(テンソル)がランダムに組み立てられているわけではなく、「訓練」と呼ばれるプロセスの産物であり、その後、次のモデルがリリースされて再び訓練されるまで数字は固定されている。この説明が価値あるものにしている点は、専門用語(「自己注意」、「ニューラルネットワーク」)から、より直感的な枠組み(グリッド内の数字)へと会話をシフトさせることである。著者は、GPT-4(2兆個の数字を含むと言われている)やGPT-5のような大規模モデルも同じ基本アーキテクチャで構成されており、単に圧倒的にスケールアップされていることに注目している。この洞察は、AIを理解するのに博士号は必要ないこと、要求されるのは忍耐力、好奇心、および技術専門家が却下する可能性のある単純な質問をしようとする意思であることを示唆している。著者の、AIを安全に保つために「理解する必要がある」という観察は、より広い議論を指す。謎解きそれ自体が説明責任の一形態なのである。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
NVIDIAは2026年9月21日、「AIセキュリティは工学の問題――エージェントスタックの全層で解決する方法」と題したブログ記事を公開し、判断を誤ったエージェントでも行動を止められる理由を説明した

検証では、Haiku 5.5はmedium設定で定型文書ならSonnet 5.5に近いスコアを約1/17のコストで出したが、英語メール課題では6.3点まで落ちた

Metaは8160億パラメーターのオープンウェイトモデルMuse Spark Openを公開
PrismMLは2026年10月15日、Ternary Bonsai 2の2B・4B・9Bを公開した
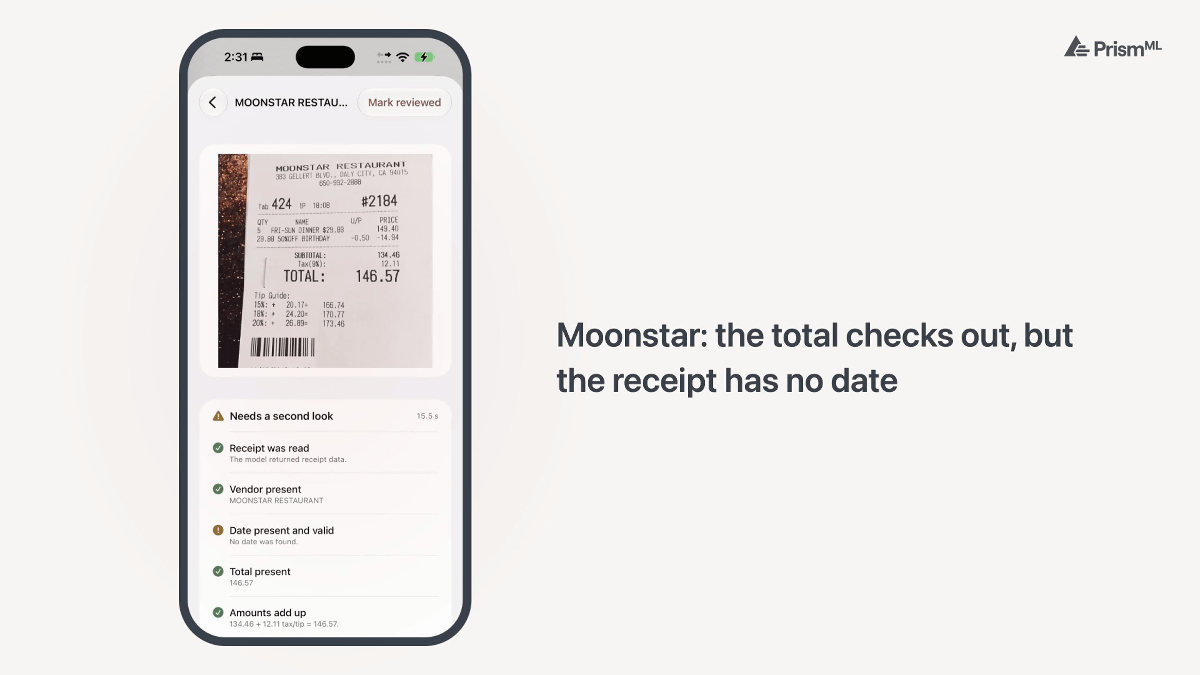
EC自動化工房がZenn記事で商品マスタ生成前クレンジング手順を示した

Claude Codeへの一言の依頼3回と完了条件付きの依頼3回では機能的に同一のMyntPackコードが生成されたが、後者では各回テストが3〜5本追加され、3回とも最後にlintを1回実行した

