何が起きたか
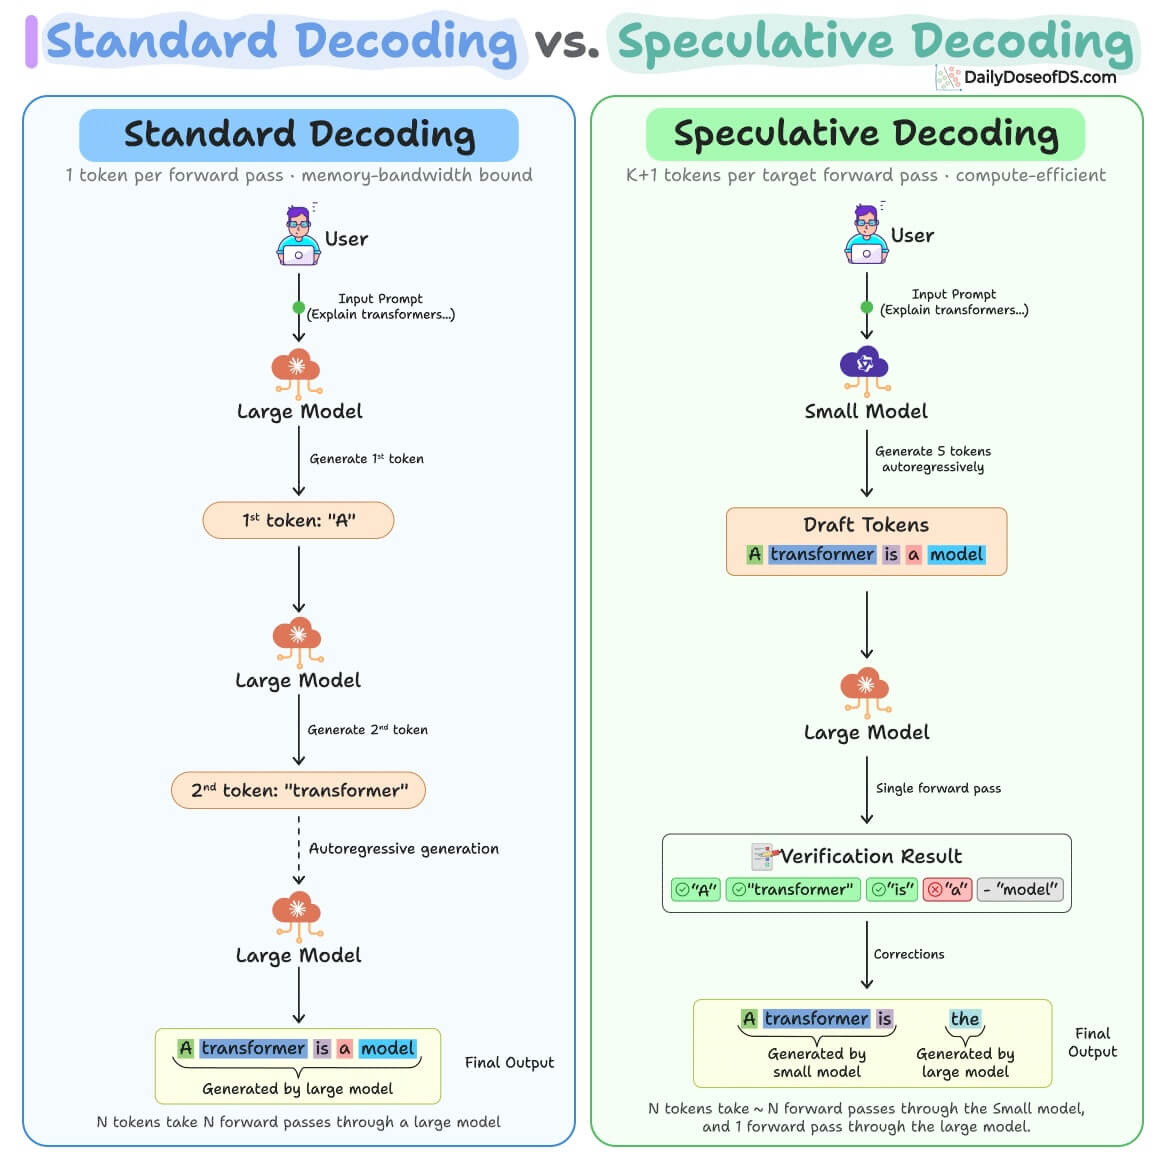
Modal が新しい DFlash ドラフトモデルを Qwen モデル向けにリリースしました。従来の推測デコーディングは 1 トークンずつ予測する方式で 2~3 倍の速度上限に留まっていましたが、DFlash はブロック拡散モデルを使って複数トークンを一度に並列予測するため、この上限を超えることができます。Qwen 3.5 122B-A10B では 250 トークン/秒から 1000 トークン/秒以上に高速化しました。
なぜ重要か
推論処理の高速化は、AI サービスの応答時間短縮やコスト削減に直結するため、LLM を実運用するビジネスにとって重要な課題です。DFlash モデルが実データに基づいて訓練されているため、提案トークンの採用率が baseline の 3 から 9 以上に向上し、より実用的な速度向上が実現できるとみられます。
注目点
DFlash ドラフトモデルは既に vLLM、SGLang、Transformers に統合済みであり、HuggingFace で Qwen および他のモデルファミリー向けに提供されています。
こういう要約が、毎朝あなたのメールに届きます。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Chunghwa Telecom社長のRong-shy Lin氏は、会話型AIから自律型AIエージェントへの移行が企業導入を変え、大規模導入にはデータガバナンス、アクセス制御、説明責任が不可欠だと述べた

AppleとMetaは、ハイエンドMacでの動作を想定した新しいオープンウェイトAIモデルを共同で公開すると発表した

作家兼起業家が毎日のToDoリストを開くと156件が並んでおり、AIアシスタントは仕事を完了させるより速く生成できると結論づけた

Zennの投稿者がAIの使い方を3モードに整理した

CLIをANTHROPIC_BASE_URL環境変数でローカルのモックに向ける手順を解説
AI動画翻訳を「文字起こし・翻訳・字幕・音声」の工程として捉える見方が誤認識の影響を警告

