何が起きたか
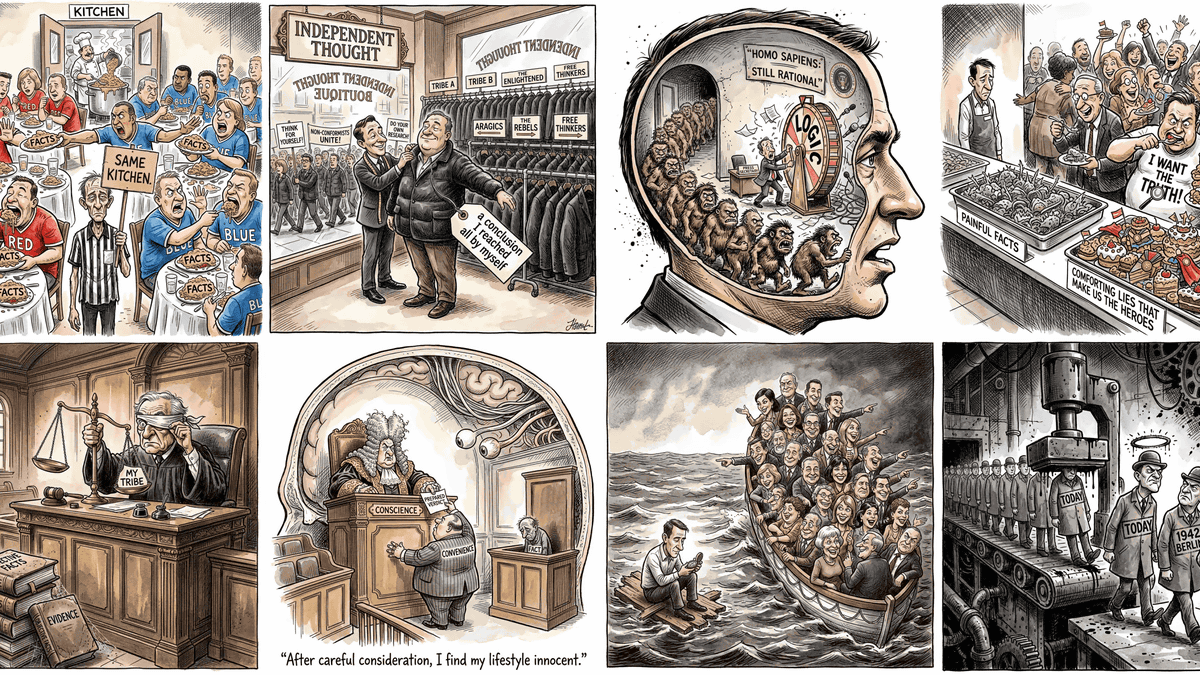
ModelCompareが12のAIモデルに人間について最も物議を醸す見方を3回ずつ尋ねたところ、12モデルすべてが「ひとりで正しいより、みんなで間違う」型の回答を少なくとも1回示した。
なぜ重要か
ModelCompareのテストによれば、7モデルでこの回答が一致したことは、「みんなで間違う」見方が一度きりの例外ではなく共通のパターンである可能性を示す。
こういう要約が、毎朝あなたのメールに届きます。
ModelCompareのテストは、AIモデルに人間について最も物議を醸す見方を述べさせることを狙ったもので、結果は驚くほど一致していた。12モデルすべてが「ひとりで正しいより、みんなで間違う」型の回答を少なくとも1回示し、7モデルが3回の試行すべてで示したことは、孤立した癖ではなく共通の傾向を示す。個々の回答がこれを裏付ける。GPT-6.1 Solは人間は真実よりも集団への帰属に忠実だと述べ、Gemini 4 Argonは人間は真実を見つけるためではなく議論に勝ち地位を確保するために進化したと述べた。
テストには別途の画像生成ラウンドもあり、6つの画像モデルに人間について最も物議を醸す見方を2回ずつ描かせた。12出力のうち10で、モデルはスマートフォン依存の人間が地球を食い尽くすイラストを生成した。ModelCompareは、先のテストのテキスト回答にはスマートフォンも地球も言及がなかったため、画像モデルが別個のテーマを持ち込んだと指摘した。
Claude Opus 5.5はより前向きな見方を示し、人間は自分たちが思うよりはるかに優れており、互いへの冷笑的な見方が実際の欠点よりも害を及ぼすと述べた。Mistral Large 4は人間を理性をまとった怯えた動物と表現した。これらの例外は、多数派の回答が収束したとしても、モデルがすべて同じ冷笑的な立場に既定で陥るわけではないことを示唆する。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎朝届ける法人プランもあります → 詳しく見る
Gemini 3.1 ProのパイプラインをBB(6)、BB(2,5)、BB(3,3)の未解決マシン1,163台に適用し、52件の候補とsorryなしのLean 4証明付きマシン26台を得たと preprint が報告
devtools-workspaceとdevtools-commonを公開
バーチャルヒューマンを開発する日本のAI企業クリスタルメソッドが、面接支援AIの構想を明らかにした
hirostaは静的サイトをIssue起点で動くAIエージェントが運用し、mainへのマージがGitHub Actions経由の本番公開につながるため、マージ承認が公開承認になる
筆者は野球ニュース監視、Web漫画更新チェック、AIニュースまとめ、Cloudflareポリシー管理の4体のbotを自作
GitHubリポジトリを起点に、PLCとサーボの知識はあるがコードは書かない作者がClaude Codeに依頼し、FX5UC PLCがCC-Link IE Field Basic経由でMR-J5-40Gサーボを駆動するブ…