何が起きたか
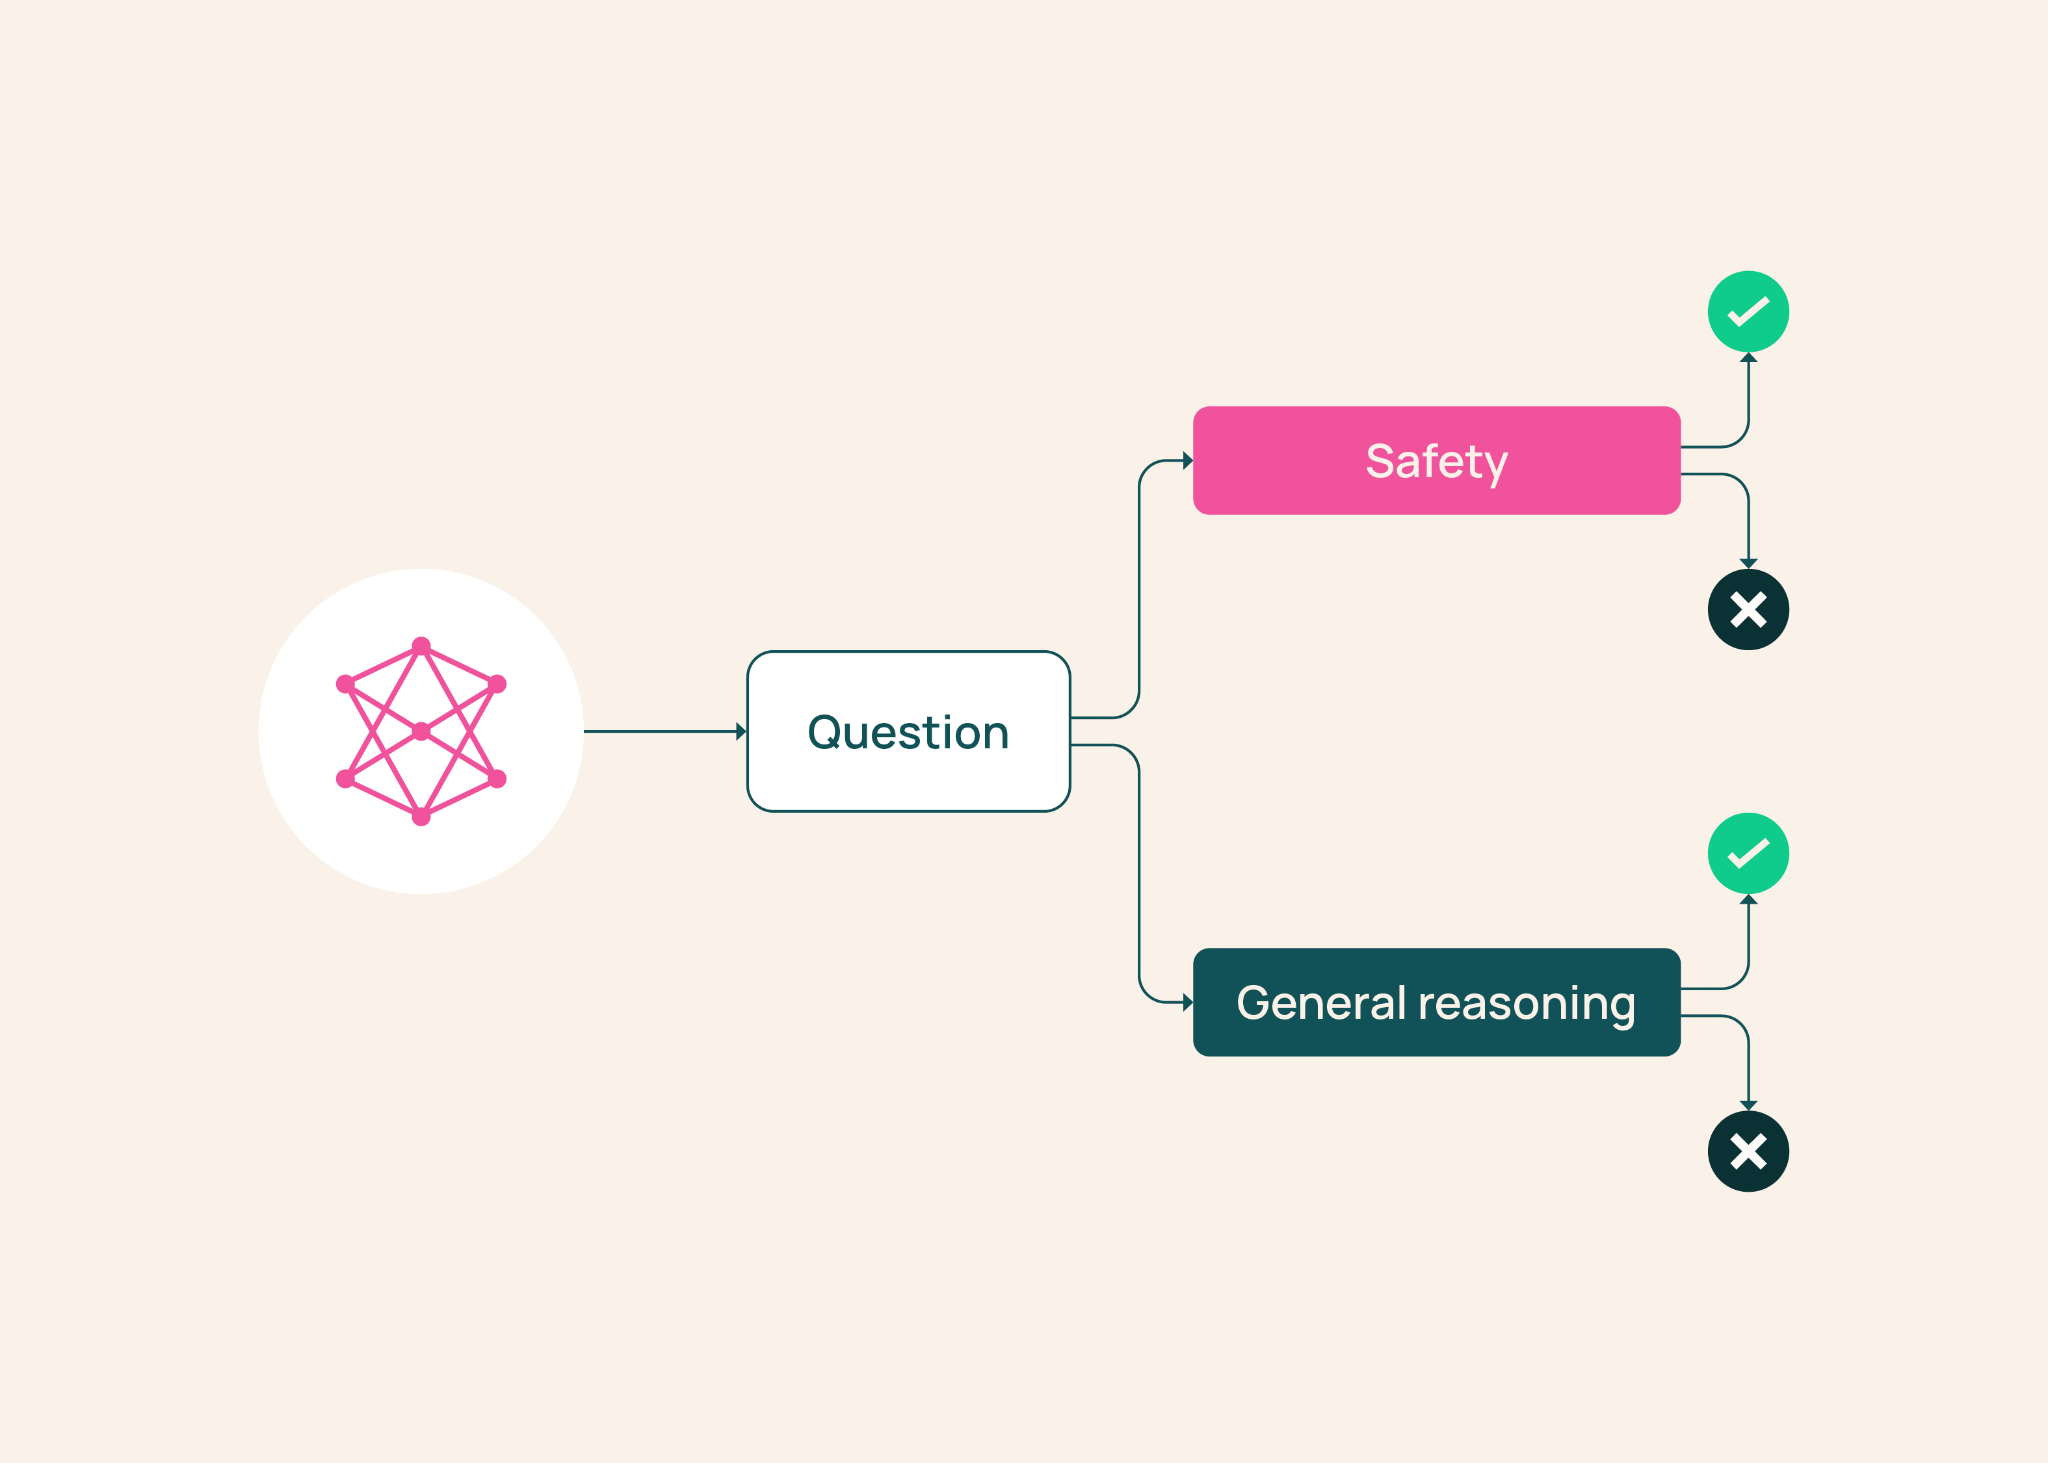
AI研究機関AI2が、LLMベンチマークを個別問題レベルで監査する新手法「BenchMIRT」を発表した。100のLLM、16のベンチマーク、34K以上の質問で訓練し、安全性と一般的推論の2つの主要因子を独立に回復した。
なぜ重要か
BBQは安全性より推論との関連が強く、WMDPは推論と関連しつつ推論力が高いほどスコアが低い、など単一スコアに複数の信号が混在する実態を可視化した。ベンチマークの意図と実際の測定内容のズレが明確になる。国内のAI開発企業は、自社のモデル評価が意図せぬ別の能力を測っている可能性を踏まえた再確認を迫られる。
注目点
質問の10%だけでも全体とほぼ同じモデル評価が得られ、未回答問題の正答予測は79%(単純手法は70%)だった。一方で、安全関連の質問除去に悪用されるリスクも指摘している。
こういう要約が、毎朝あなたのメールに届きます。
BenchMIRTは項目応答理論(IRT)を多次元に拡張した手法で、心理測定学の知見をLLM評価に応用している。背景には、単一のベンチマークスコアに複数の能力が混在し、解釈を難しくしているという問題意識がある。実際、BBQやWMDPが安全性ではなく推論と強く関連するという発見は、従来のベンチマーク分類の前提を問い直すものだ。
この手法はモデル評価の効率化にも寄与する。全質問の10%だけで全体とほぼ同じ評価結果が得られる点は、評価コスト削減の可能性を示す。未回答問題の正答予測精度も単純手法を上回った。ただし、2025年3月以前のモデルで訓練されているため、新しいモデルへの適用には限界がある。また、安全性の質問を特定できるがゆえに、それを取り除いて弱いモデルを通す不正利用のリスクも作者は認めている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
OpenAIは、GPT-6.1 SolがCOBOL移行ベンチマークで低推論設定ながら86.6%を記録したと発表した
Windows 11上のOllama 0.40.4でqwen2.5:0.5b(936MB)を走らせ、ollama psのUNTIL表示が既定で「4 minutes from now」、keep_alive="30m"指定…

Uday Kiran Medisetty氏によると、UberのバックグラウンドエージェントMinionが本番PRの約15%を生成
筆者はClaudeのFable 5.1とGoogle GeminiのArgonを司会Twill経由で10章・約100発言討論させ、Argonの従属発言をFableが指摘し撤回した
v2.1.299は20万トークン超の会話を約54分の放置後に要約する
2026年10月15日、11ルールを実装したv0.1.1を同梱の架空データで実行し、383仕訳から25仕訳を抽出、ルール該当は延べ53件だった

