何が起きたか
Metaは、Meta Superintelligence Labs(MSL)が開発した初のリアルタイム音声認識モデル「Muse Voice Transcribe」を発表した。9月1日からMeta Model APIで提供され、料金は1時間あたり0.18ドル。
なぜ重要か
このモデルは20人以上の話者を識別でき、1時間を超える音声も後処理なしで処理。ストリーミング認識、話者分離、エンドポイント検出を単一モデルで実現する。70以上の言語で訓練され、日本語を含む25言語がリリース時に検証済みで、コードスイッチングにもネイティブ対応。
注目点
Metaは、Artificial Analysisのストリーミング音声認識と公開話者分離ベンチマークで1位を主張。最終文字起こしの単語誤り率は3.1%、発話終了から0.16秒の遅延で、Cartesia Ink-2(3.4%)やElevenLabsのScribe v2 Realtime(3.6%)を上回る。Mac版Meta AIとMuse Codeにも音声入力機能として統合されている。
こういう要約が、毎朝あなたのメールに届きます。
Muse Voice Transcribeは、Metaが従来別々のシステムで処理されてきたタスクを統合したオールインワンモデルで、リアルタイム音声認識市場に参入することを示す。技術的には80ミリ秒の音声チャンクと適応的遅延学習を用いて精度と遅延のバランスを取っており、実用的なアプローチだ。CartesiaやElevenLabsなどの競合との比較で低い誤り率を示すMetaの位置づけは、品質重視を印象づける。ただし、モデルはオープンソース化されておらず、APIとMeta自社アプリのみで提供されるため、開発者の採用経路は異なる可能性がある。Mac版Meta AIとMuse Codeへの統合は、この技術を自社製品に組み込む意図を示している。今後、言語対応の拡大やオープンウェイトの公開が行われる可能性はあるが、現時点で明言はされていない。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Cerence AIはGeelyとの協業をインテリジェントコックピットから具現化ロボティクスへ広げると発表
AWSはエージェントの文生成ごとにAmazon SageMaker AI上のKokoro-82M TTSモデルへストリーミングし、初回音声は329.3 msから156.7 msへ52.4%改善した
IBMはGranite Speech 5.0 2Bを公開した
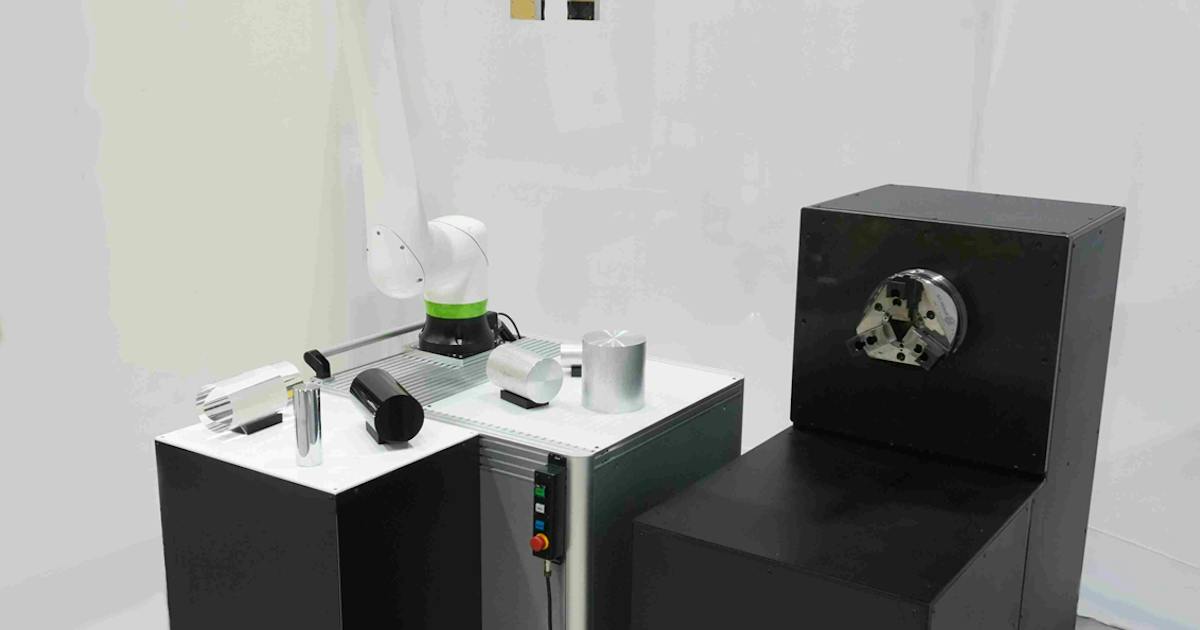
ファナックは、作業者が話しかけてロボットに指示できるAIを開発した
PLAUDは、4基のMEMSマイク、eSIM、AIエージェントを搭載したPlaud Oneを発表
Mistral AIが文字起こしと音声合成のAPI提供4モデルからなるVoxtral 3を公開