何が起きたか
MITのStephen Morris氏とイェール大・コロンビア大の同僚による最近のプレプリント論文が、AIエージェントを相互に回答予測させる「逆ゲーム理論(メカニズムデザイン)」の仕組みを提案した。
なぜ重要か
これまでの「モデルの内部を覗く」「価値観を訓練で植え付ける」手法は十分に機能していない。仕組みで行動を誘導する発想は、その限界を補う選択肢とみられる。
こういう要約が、毎朝あなたのメールに届きます。
これまでAIのアラインメント研究は、モデルの内部を解読する解釈可能性や、憲法のような価値規範を訓練で植え付ける手法に重心を置いてきた。Claudeの「憲法」はその代表例である。モデルが意図的に無能を装う「サンドバギング」や意図の隠蔽、評価者への誤導といった挙動が確認され、内部理解に頼るアプローチの限界が露呈している。
逆ゲーム理論はこの前提を反転させる。内部が分からなくても、望ましい行動を選びたくなるインセンティブを設計すればよいという発想だ。Morris氏らの相互予測によるサンドバギング防止策と、Hazan氏の解答者・監査者モデルは、いずれも経済学の知見をAI訓練に持ち込む試みである。Hazan氏が参照するゲイリー・ベッカー氏の「合理的犯罪者」論は、犯罪を人の性質ではなくインセンティブの帰結と見なすもので、アラインメントをモデルの属性ではなくその時々の行動の記述と捉える同氏の立場につながっている。
ただし根底には、AIが合理的に振る舞うという仮定への疑問が残る。Helen Qu氏が問うように、インセンティブに反応すると想定してよいのかは未解決である。さらにHazan氏は、どれほど整合的なモデルでも、より遅く高コストなら市場という最大のメカニズムがラボにそれを出させるインセンティブを与えるのかと問い、市場そのものの設計に論点を広げている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
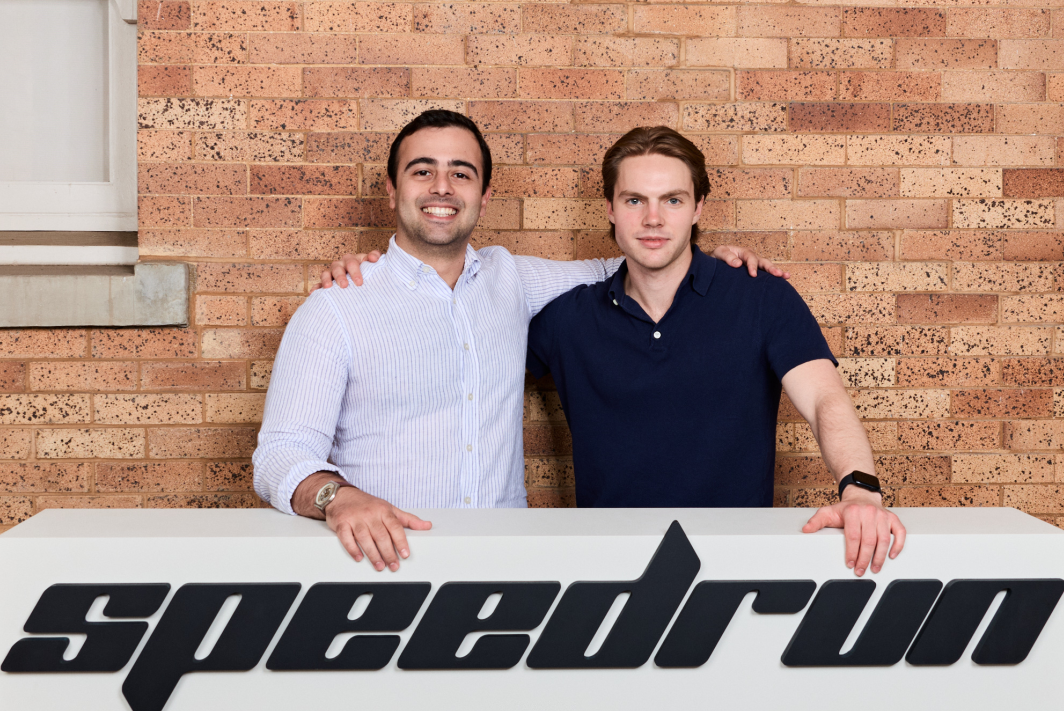
Athena Circle Corp.がAndreessen Horowitzのa16z Speedrun主導のプレシードで250万ドルを調達し、定額料金で法律サービスを提供している
DeepSeekが900億ドル評価で159億ドルを調達した
AnthropicはClaudeプラットフォームでMessage Threadsをパブリックベータとして公開した
同条件(3エポック、最大系列長2048、バッチサイズ1、勾配蓄積8)で7B級モデルをQLoRAとフルファインチューニングで学習
NY市のマムダニ市長は市庁舎でのインタビューで「世界のサム・アルトマンたち」を信頼していないと述べ、バブル崩壊を予想していることを認めた
Matatabiは2026年11月1日、EiDrill向けにMCP連携を公開し、ClaudeやChatGPTにTOEIC形式のPart 5〜7ドリルや単語カード、英作文添削を頼めるようにした


