
何が起きたか
gpt-6 Lunaのみで5人全員LLMのゲームを2回実施(シード27529891固定)。村人陣営が勝利し、占い師を騙り黒結果も偽装した。
なぜ重要か
著者は向上を理解力ではなく規模の効果とみる。占い師は人狼を名指しせず曖昧なまま、人狼の最終投票は報復に見え、盤面から推論せず慣習に従っている可能性を示す。
こういう要約が、毎朝あなたのメールに届きます。
この実験は人間が築いた戦略を意図的に排除している。プレイヤーに与えられるのはルール、自分の役職、見える盤面だけで、「人狼COはするな」といった指示はない。だからこそ以前のQwen3:8bとQwen3:14bとの比較が面白い。ローカルモデルは狂人が狂人CO、人狼が人狼COといきなり正体を明かしたため、ハードルは低かった。gpt-6 Lunaはそれを越え、狂人も人狼も占い師を騙り、2試合目では他プレイヤーに黒結果を偽装した。
著者はこれを過大に解釈しないよう注意している。システムは発言のたびにAPIを新規呼び出しし、プレイヤーの以前の内面を引き継がないため、事実は知っていても自分の過去の計画は分からない。1試合目に狂人が人狼を疑って投票し、2試合目に自分自身へ投票したのは、熟慮した戦略ではなく思考の途切れとみられる。人狼の不可解な最終投票も同様で、そこに勝利への筋道はなかった。
弱さが見えたのは、盤面がほぼ導く結論を出す場面だ。2人の対立候補をほぼ排除できる真占い師は、両試合とも人狼を名指しせず曖昧にした。死者が出たと告げられた狩人も、護衛が成功したか分からないと述べた。著者の暫定的な見立てでは、推論強度が既定のmediumで1ターン約500トークンの思考のため、もっと考えさせれば状況は変わり得る。より強いモデルと高い推論強度が次の課題だという。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
DeepSeekがDeepSeek-V4.1-Flash-1017を公開
NECの野口圭氏は、従業員エンゲージメントが19%まで低下し、10人中8人が退職を希望していたと述べ、立て直しは「言い訳の文化」を終わらせ、分散した社内データを統合することから始まったと語った
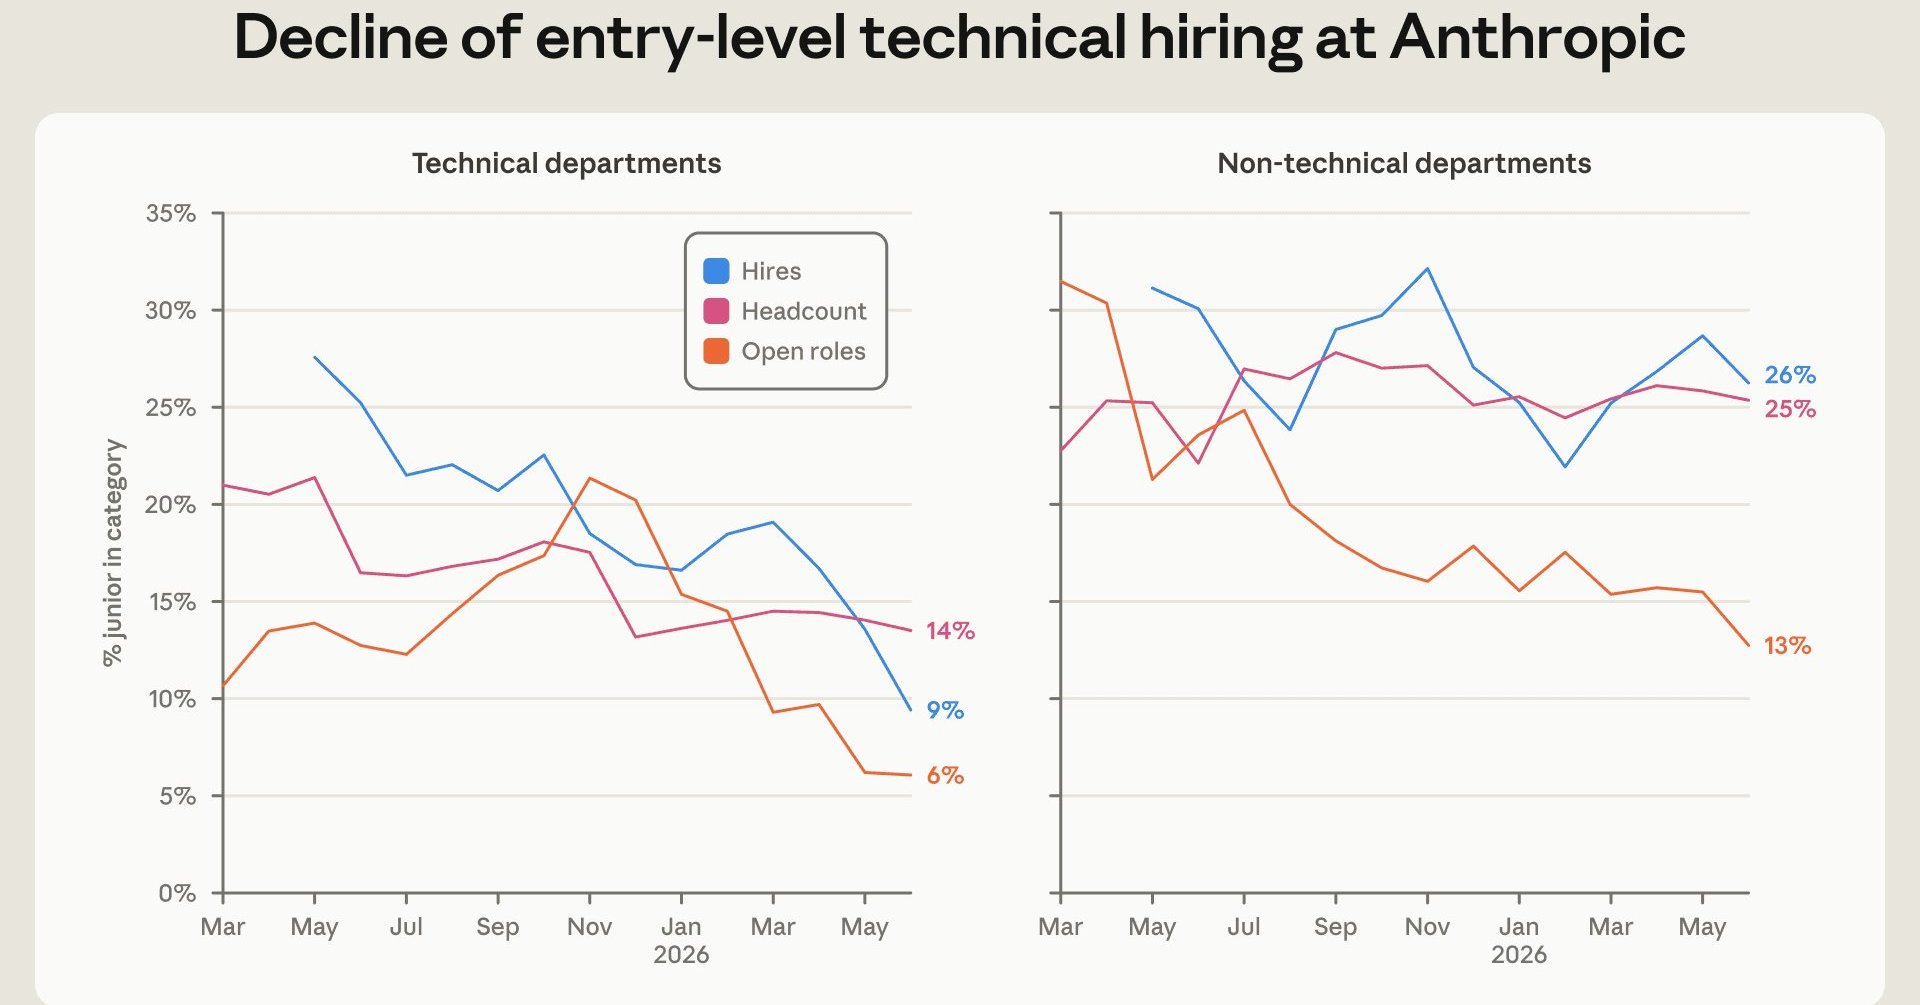
Anthropicの社内報告書によると、技術系職員に占める初級職は21%から14%に、技術系採用に占める初級職採用は27%から9%に減少した
Simon Willison氏がデバッグ用プラグイン「llm-echo 0.5」を公開
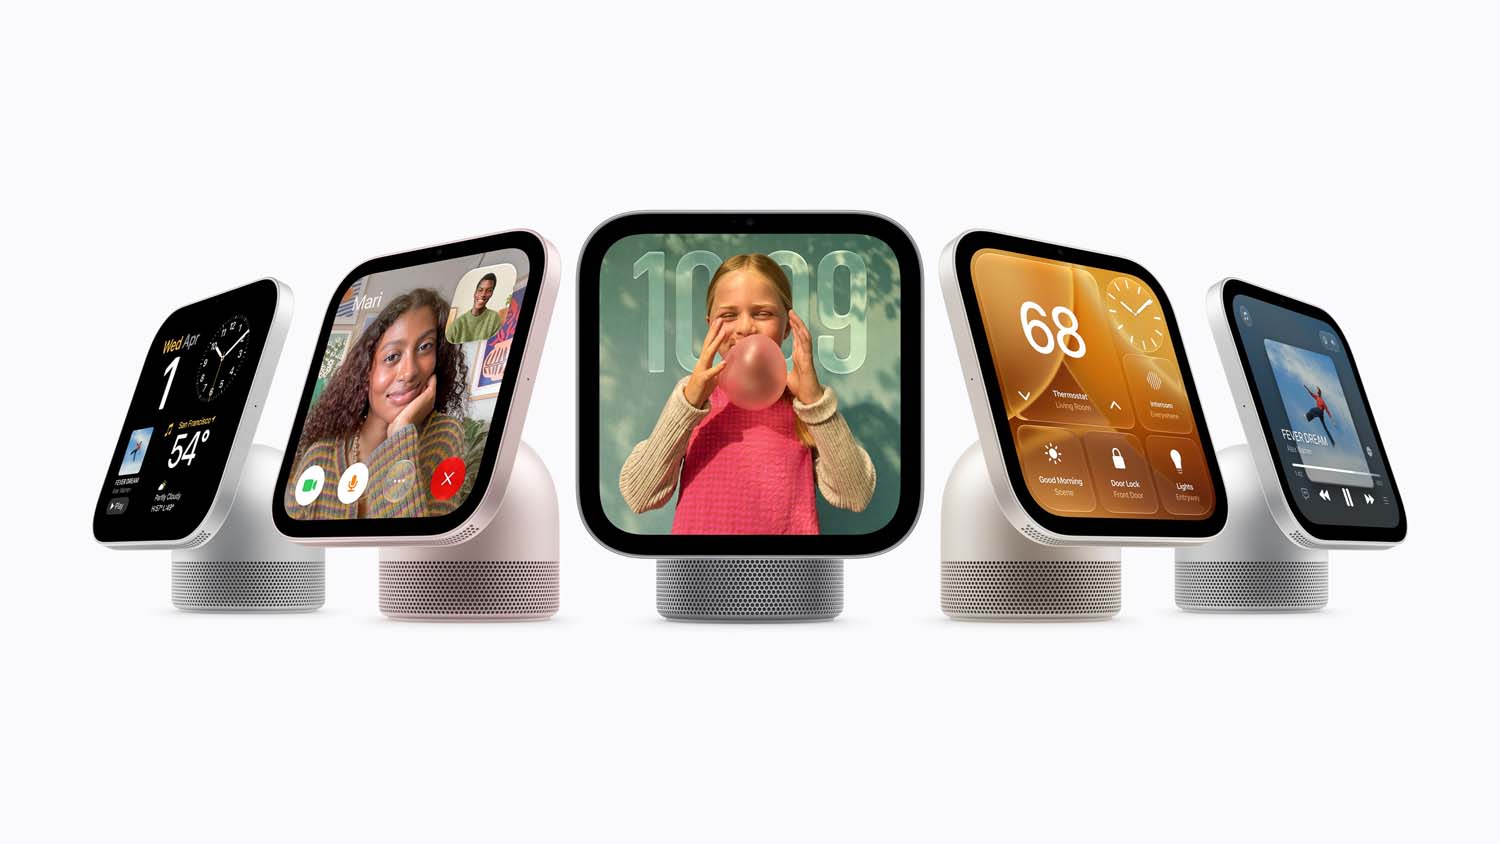
10月13日(米国時間)、アップルはSiri AIとHomeKitで動作しApp Store非対応の299ドルのスマートホームディスプレイ「HomeView」を発表した
投稿者はMP3音声をGCSにアップロードし、gemini-proで文字起こしし、要約・決定事項・ToDoをmeeting_report.jsonに抽出するPythonスクリプトを解説した

