何が起きたか
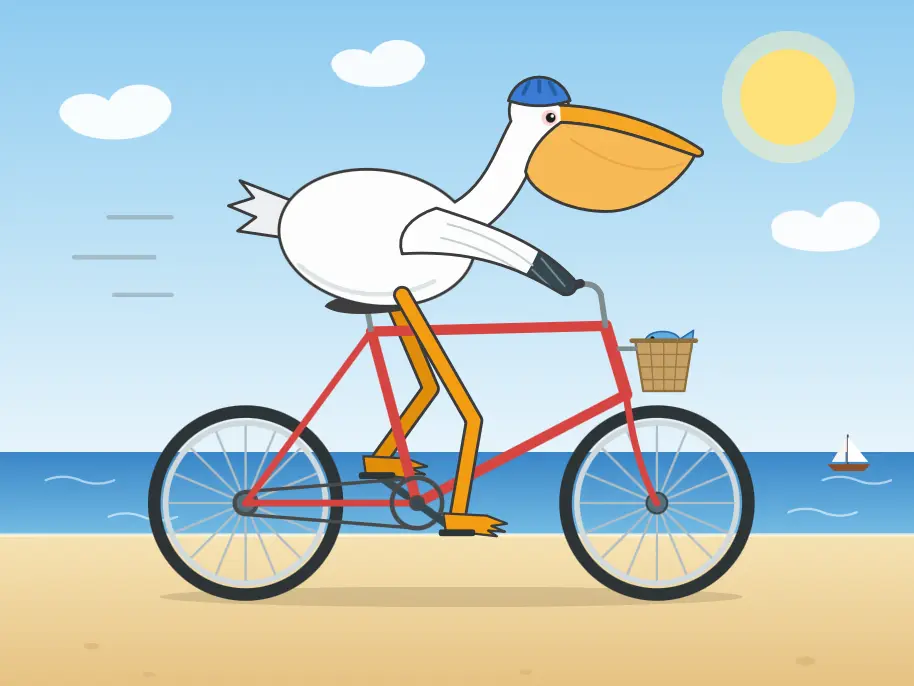
Anthropicは2026年9月1日にClaude Fable(およびMythos)5.1をリリースした。テストでは、モデルの「max」推論設定が、これまでAnthropicが生成した中で最も優れたAI生成ペリカン画像を生み出し、そのコストは3.30ドル、処理時間は13分54秒だった。
なぜ重要か
新ベンチマークTerminal-Bench-Science 0.1で、同モデルは52.6%を記録。Fable 5の24.7%、Opus 5の29.0%、GPT-5.6 Solの22.4%を上回った。ただし著者によると、低い推論設定(「low」と「medium」)ではペリカンのプロンプトに対して推論が完全にスキップされたようで、コストは約10セントだった。国内のAI開発企業は、高性能な出力と引き換えに推論コストが増大する事例を参考に、自社のモデル設計を見直す可能性がある。
注目点
「max」推論レベルでは65,927個の出力トークンと詳細な推論トレースが生成され、青い帽子と魚の入ったバスケットを持つペリカンが完成した。この出力を別のプロンプトでアニメーション化した際は、コストは1.37ドルで、元のSVGで車輪が正しく回転する動画が生成された。
こういう要約が、毎朝あなたのメールに届きます。
Claude Fable 5.1のリリースで注目されるのは、新設の科学ベンチマークTerminal-Bench-Science 0.1での飛躍的なスコア向上だ。前モデルの24.7%に対し52.6%を記録し、科学研究タスクの処理能力が大幅に改善したことを示している。これはAnthropicのマーケティングにおいて重要な領域だ。
一方、著者の実機テストでは、モデルの推論能力に関するより複雑な実態が浮き彫りになった。単純なSVG生成にかかるコストと時間は、推論努力設定によって劇的に変動し、「low」では約10セント・24秒だったのに対し、「max」では3.30ドル・約14分に達した。興味深いことに、低い設定ではこのタスクに対して推論が完全に省略されたようだ。
「max」設定の長時間に及ぶ推論トレースを見ると、モデルは視覚的な衝突チェックから自転車フォークの曲線修正まで、詳細で意図的な計画を実行している。複雑で反復的なタスクにおいては、高コストのティアが真に異なる、より高度な動作モードを提供することが示唆される。ただし著者は、競合モデルであるGemini 3.7 Flashのような創造性は依然として欠けていると指摘している。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。