何が起きたか
開発者はKoehaku音声ランタイムにNemotron 3.5 Streaming ASR 0.6B 560ms INT8を追加し、100ターンのテストで発話終了からp50 1.594秒を計測した。
なぜ重要か
これは会話のテンポに近く、音声AIの返答がテキストチャットの読み込みを待つ感覚ではなくなる可能性がある。
注目点
テストは1つのローカル環境で行われたため、同じコードが他の環境でも通用するかが鍵となる。ONNX Runtimeのスピン問題の修正に注目だ。無効化するとワーカーのCPU時間が約78%削減された。
誰に効くかローカルハードウェアでリアルタイム音声アシスタントを構築する開発者が、これを行動に移せる立場にある。数字が示すのは、音声認識の速度は手段の一つにすぎず、スレッドスピンのようなランタイムの詳細が長時間セッションを静かに劣化させ得ることだ。
こういう要約が、毎朝あなたのメールに届きます。
このプロジェクトは、AIにゆっくりしたキャラクター風の声で喋らせる実験として始まり、音声合成にAquesTalk、認識にwhisper.cpp、その間にLLMを組み合わせて作られた。そのバージョンは動作したが、やり取りがタイピングではなく音声になると、返答前の間が目立つようになった。開発者の答えは、ユーザーがまだ話している間にテキストが届くよう、音声認識側を作り直すことだった。
変わったのはストリーミングモデルだけではない。VADがユーザーが間を置いたと判断し、Smart Turnがターンが本当に終わったかを判断し、LLMが暫定テキストで投機的に開始する。最終的な文字起こしが推測と一致すればその回答が採用され、一致しなければ破棄して再生成する。100ターンのテストでは、100件の返答のうち74件がこの方法で採用された。別のWhisper経路は、最終認識ステップをキャンセルしていたタイムアウトも明らかにし、開発者は確定作業と投機的タイムアウトを分離することで修正した。
今後の焦点は、これらの改善が開発者自身のマシン以外でも維持されるかどうかにかかっている。スレッドスピンの問題は長時間のソークテストでのみ現れたため、このランタイムの価値は、そうした遅延を測定し続けて捉えられるかどうかにかかっているかもしれない。音声機能を構築するソフトウェアチーム、そして適切なタイミングで答える必要があるAIキャラクターを作る人々が、違いを実感する立場にある。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
ElevenLabsが220億ドルの評価額で3億ドルの従業員向けテンダーを完了し、Mati Staniszewski氏は音声が主要なインターフェースになると予測した

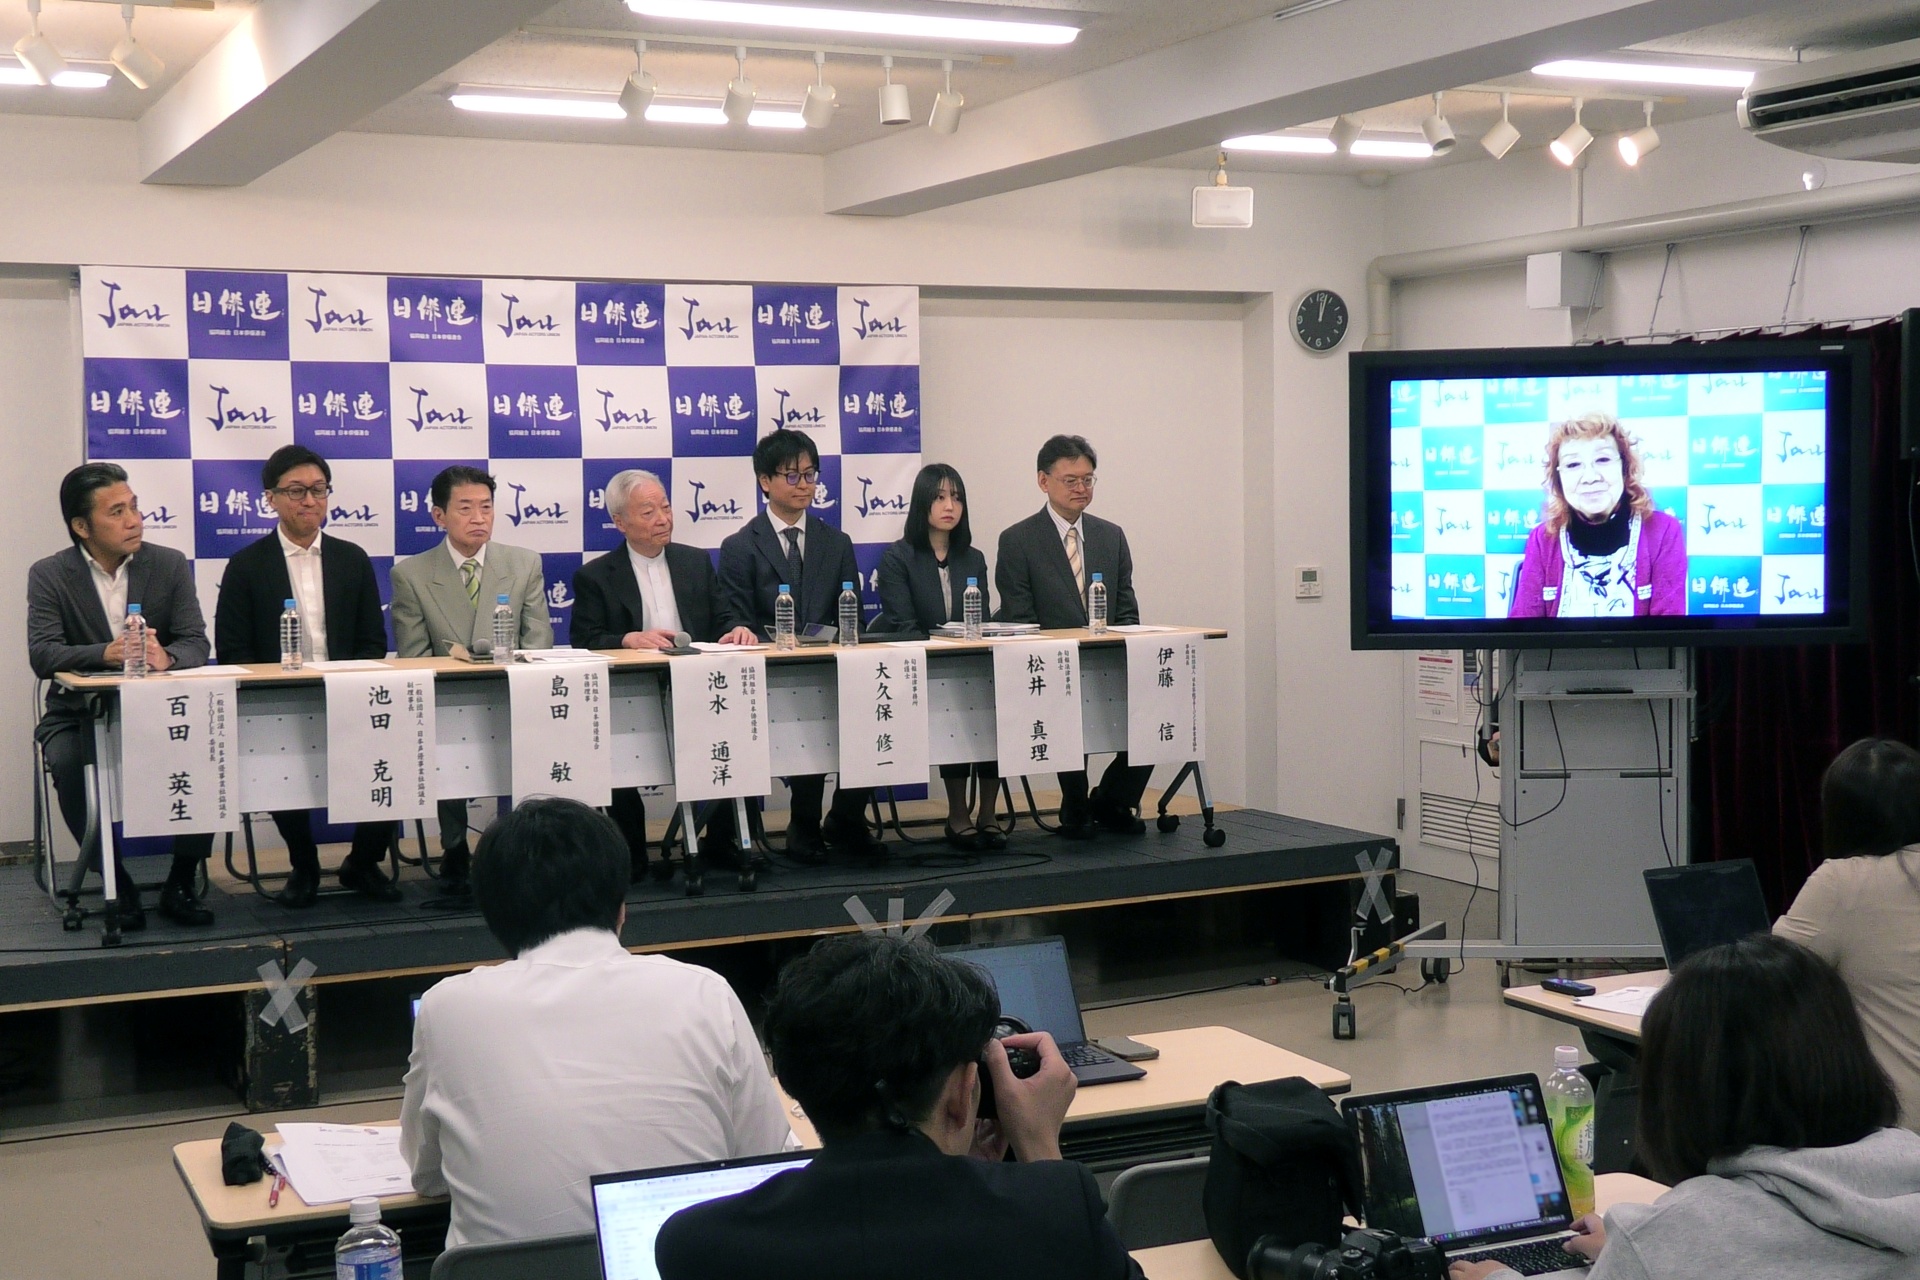
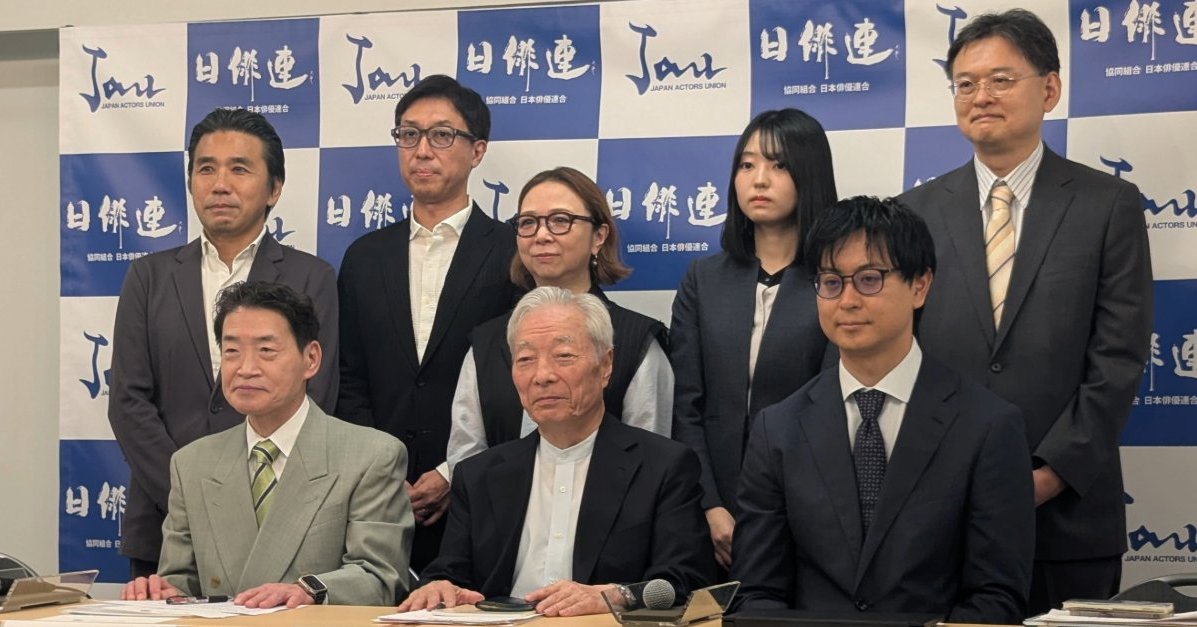
日俳連は10月15日、生成AIの音声利用ガイドラインを発表した
Aratakoによる日本語専用のオープンTTSモデルIrodori-TTSを、Databricks Model Serving上で動かし、テキストを送ると音声を返すAPIとして使う手順が公開された
個人開発者がYuruneを制作した
開発者がMoonshine Voiceの日本語「Small Streaming」モデルをLinux CPU(16コア)上でfaster-whisperのsmallモデルと比較し、合成音声・FLEURSの20クリップ・自作…

日本俳優連合は10月15日、音声に関する生成AIガイドラインを策定し、学習・生成・公開の全段階で演者の事前同意を求めた