何が起きたか
StationeryBenchでOpenAIのGPT-6 Astraは100件中7件の双腕ロボットタスクを完全に完了したが、Ai2のMolmoAct2は0件で、200回の試行における進捗スコアの中央値は100点中46点と12点だった。
なぜ重要か
研究者Yoav Artzi氏はAstraを「空間推論における段階的な変化」と呼び、未公開のREMAPベンチマークでは人間レベルに近い精度に達するが、Artzi氏はAstraが他の場面では依然として人間に及ばないと指摘する。
注目点
Artzi氏はOpenAIがBlenderシーンなど大量の3DデータでAstraを学習させたと推測しており、それが3Dタスクでの向上を説明するだろう。結果、動画、コードはGitHubで公開されている。
誰に効くか双腕マニピュレーションを評価するロボティクスおよび身体性AIのチームは、StationeryBenchを空間推論の新たな基準点として扱う可能性が高いが、このベンチマークは5つの机上文具タスクしか対象としていない。
こういう要約が、毎朝あなたのメールに届きます。
StationeryBenchは初期の小規模なテストだが、そこで示された差は歴然としている。同じ双腕YAMロボットによる200回の試行で、OpenAIのGPT-6 Astraは100件中7件のタスクを完了し、Ai2のMolmoAct2は1件も完了しなかった。Astraの進捗スコアの中央値は100点中46点で、MolmoAct2の12点と比べると、違いはタスクを完了するかどうかだけでなく、各モデルがどこまでタスクに近づくかにもあることがうかがえる。
ベンチマーク自体は、マーカーのキャップを外す、クリップを注ぎ出す、2本のロボットアーム間で定規を渡すという5つの机上文具タスクしか対象としておらず、操作のごく一部に過ぎない。それでも、結果はGitHubで公開された動画とコードを伴い、独自の消費者向けロボットを構築するというOpenAIの公表済みの長期計画に続くものであり、同社のモデルがテキストや画像の外でどう機能するかを示す初期の兆候となる。
外部の研究者Yoav Artzi氏の「空間推論における段階的な変化」という表現は、まだ未公開のREMAPベンチマークに一部基づいており、そこではAstraが人間レベルに近い精度に達する。Artzi氏自身の「ASTRAでさえ、他のシナリオで人間がすることには及ばない」という留保と、OpenAIがBlenderシーンなど大量の3Dデータで学習したという同氏の推測は、この成果がどれだけ汎用的か、3D中心の学習にどれだけ結び付いているかにかかっていることを示唆している。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Growill合同会社がGrowill Compassの先行導入企業5社の募集を開始

Claris Conference 2026でClaris International幹部が「Claris Harbor」と「Claris Pulse」を世界初公開すると発表した
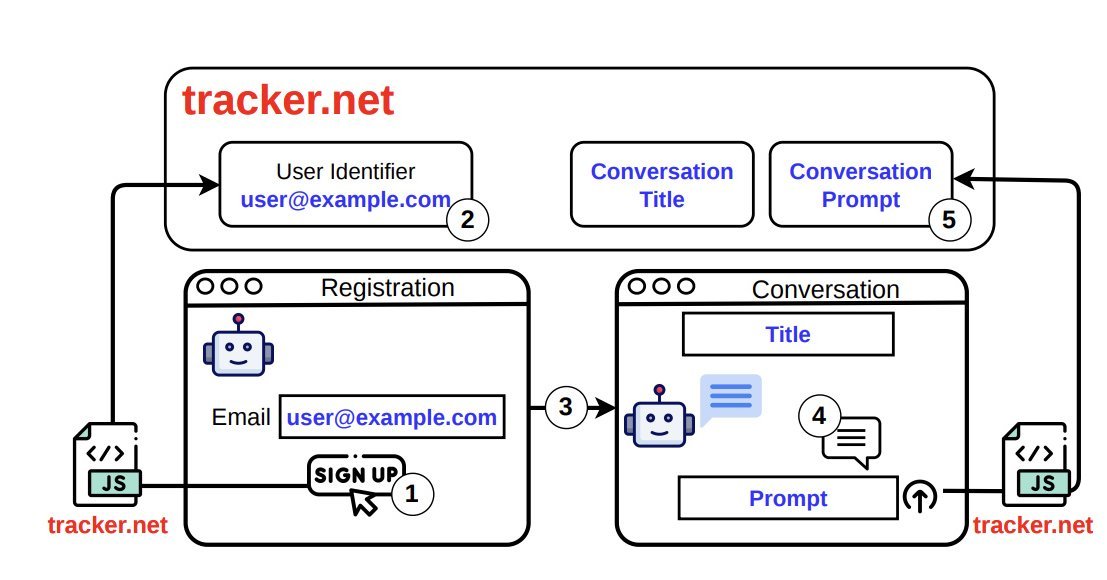
ChatGPT、Claude、Geminiを含む42のAIチャットサービスを調査した結果、21が自動生成の会話タイトルを外部トラッカーに漏えいし、9では生のプロンプトも送信されていた
IBMとMicrosoftは2026年11月10日、AIエージェント基盤「Imagine Enterprise」を発表
Agile Robotsは85億ドル評価でSoftBank Group主導の5億ドルシリーズFを完了、NVIDIA、Hitachi Group、T.Capital参加、累計20億ドル
OpenEvidence CEOのDaniel Nadler氏はSemaforで、認知の外部化のリスクは「本当に、本当に深刻」だと述べ、医学生にAIを使いつつ紙の試験を受け内容を習得するよう助言した