何が起きたか
Apple研究者らがFAE(Feature Auto-Encoder)を発表。事前学習済みの視覚表現を、画像生成に適した低次元潜在変数に変換するため、わずか1層のアテンション層を使用するフレームワークです。FAEはDINOやSigLIPといった様々な自己教師あり学習エンコーダと互換性があり、拡散モデルと正規化フローの両方に適用可能です。
なぜ重要か
高品質な事前学習済み視覚表現を生成に適応させることは、理解タスク向けの高次元潜在変数と、生成に必要な低次元潜在変数の間の不整合が原因で課題となってきました。FAEはこの適応を最小限の構造複雑性で実現しながら、画像再構成と理解の両方に必要な情報を保持します。開発者が生成モデルをより容易に構築できる可能性があります。
注目点
ImageNet 256×256でのFAEの性能は、分類器フリーガイダンス使用時にFID 1.29(800エポック)および1.70(80エポック)、ガイダンスなしでFID 1.48(800エポック)および2.08(80エポック)に達しており、最先端またはそれに近い性能と評価されています。
こういう要約が、毎朝あなたのメールに届きます。
本論文は生成モデリングにおける周知の課題に取り組んでいます。意味理解を高次元表現で効果的に捉える事前学習済み視覚エンコーダは、効率と品質のバランスを取るため圧縮潜在空間で動作する生成モデルの要件と自然には一致しません。先行研究は複雑な目的関数と特殊な構造でこの不整合に対処してきましたが、FAEは著しくシンプルな解決策を提案しています。単一のアテンション層と2つの独立した深層デコーダの組み合わせです。このフレームワークは元の特徴空間の再構成と画像生成ステップを分離することで、各成分が両者を同時に1つの表現に強制することなく、特定の目標に最適化できます。
FAEの適用範囲の広さ—複数の自己教師あり学習エンコーダ(DINOやSigLIP)と複数の生成モデルファミリー(拡散と正規化フロー)で機能—はこのアプローチが特定のアーキテクチャに合わせたものではなく、汎用的であることを示しています。最小限の層数と組み合わせると、高品質な事前学習済み表現を工学的オーバーヘッドなく組み込みたい実務者にとってアクセスしやすい手法である可能性が示唆されます。報告されているベンチマークはFAEを競争力のあるポジションに置いています。ImageNet 256×256で最先端またはそれに近いFIDを達成しながら、高速学習も実証(80エポックでも800エポックでも強い結果)しており、高品質と実用的な訓練効率の両方を反映しています。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
TOPPANホールディングスと慶應義塾大学は2月1日から7月31日まで量子コンピュータと生成AIの実証実験を実施し、10qubitで16×16ピクセルのコア画像を生成、AI処理後に256×256ピクセルのカラー画像を出力…

Black Forest Labsが2026年10月15日、FLUX 3 Image Kleinをオープンウェイトとして公開した

KreaがKrea 3のベータ版を公開
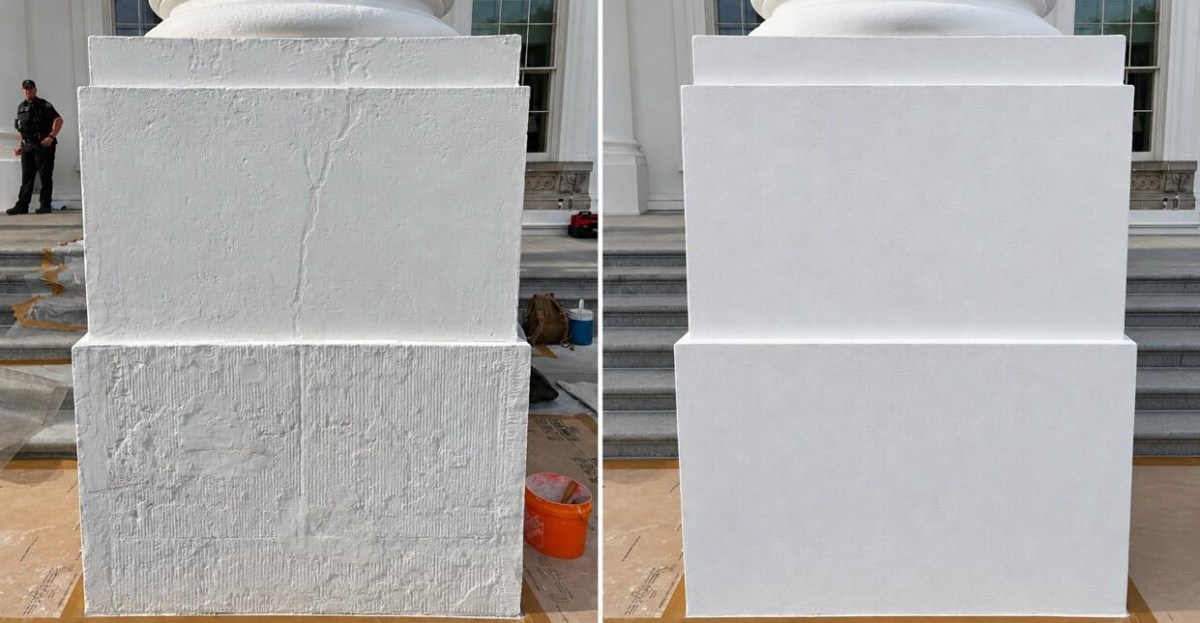
トランプ大統領がTruth Socialにホワイトハウス改修の写真を投稿したが、1枚はGoogleのSynthID DetectorによりOpenAIで作成または編集と判定された
Universidad de Córdoba(UCO)が「AI NSFW 2026:参考ツール、再利用可能なワークフローとビジュアルAI」と題したガイドを公開した
Black Forest Labsが5.6-billion-parameterのオープンウェイト画像モデル「FLUX 3 Image Klein」を公開した