何が起きたか
ビジネス読者向けの日本語解説記事が、ローカル推論――AIモデルを手元のPCやスマートフォンのCPU、GPU、NPUで動かし、データを端末外に出さない技術――を説明した。
なぜ重要か
顧客データや未公開のソースコードをクラウドに送る必要がなくなり、利用量に応じたAPI課金も避けられ、通信遅延も削減できる。ただし端末の性能が動かせるモデルを制限する。
こういう要約が、毎朝あなたのメールに届きます。
ローカル推論は、クラウドAIの代替としてではなく、計算をどこで行うかという問題として提示されている。スマートフォンのカメラが犬や猫を認識する例が分かりやすい。クラウド推論なら写真をサーバーに送って解析するが、ローカル推論ならその解析をスマートフォンの中で完結させる。
魅力は三つの実用的な利点として整理されている。第一に、情報を端末外に出さずに処理できることで、顧客の個人データや未公開のソースコードを扱う場合に重要になる。第二に、自分のモデルを動かせば利用量に応じたAPI課金を避けられるが、ハードウェアの購入費と運用コストは残る。第三に、ネットワークの往復をなくすことで、音声や画像認識、ロボット制御など遅延が問題になる用途に役立つ。
変わったのは、ローカル推論が普通のマシンでも容易になったことだ。オープンウェイトモデルの普及、小さいが高性能なAIモデルの登場、NPU搭載PCの増加が挙げられている。筆者自身の環境――2026年10月時点で32GBのメモリとIntel Core Ultra 7を搭載したノートPC――は、下書きの軽微なテキストを確認・修正するなど用途を絞れば、ローカルLLMが実用になる証拠として示されている。機密性の高い資料をローカルで扱うには、端末自体の安全確保が依然として必要だ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
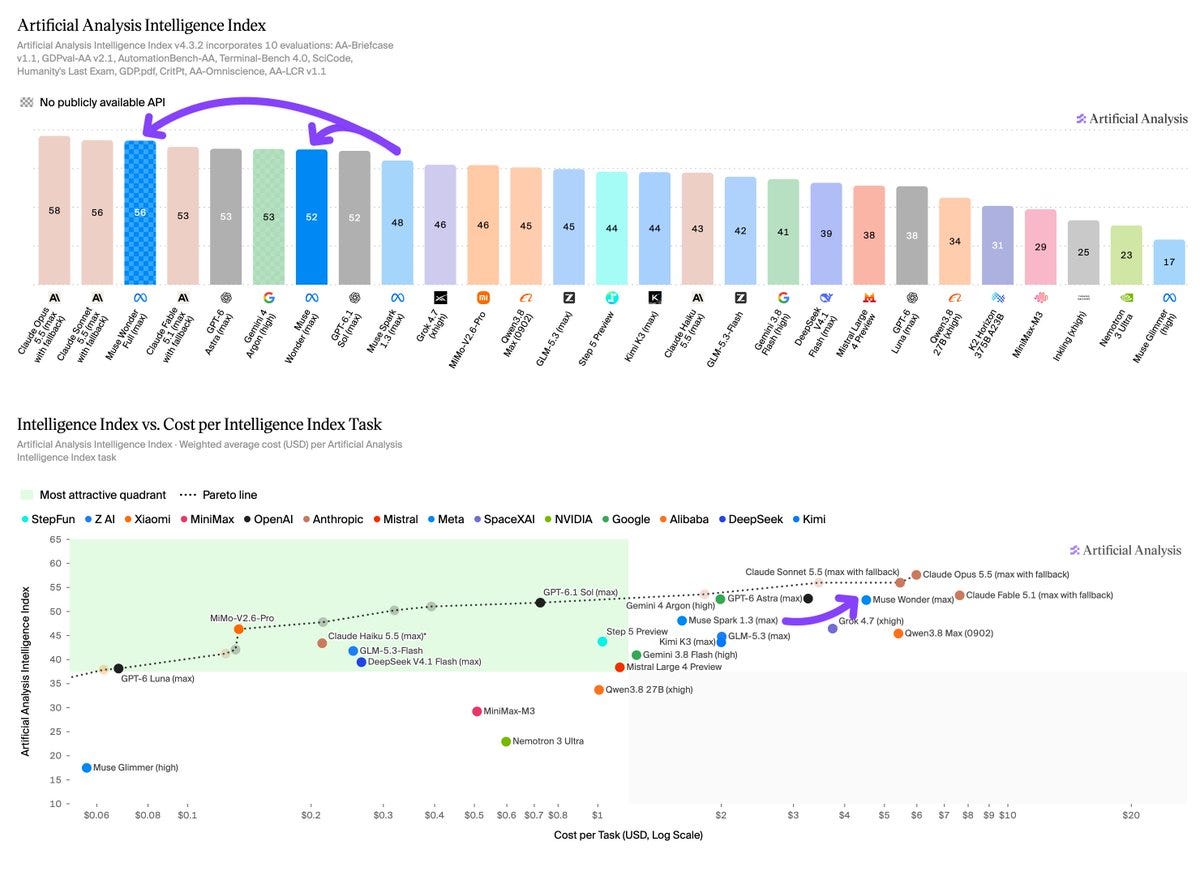
Metaは新モデル「Muse Wonder」と「Muse Wonder Full」の2つを発表し、ザッカーバーグ氏はOpenAIとAnthropicの最新モデルに匹敵すると述べた
Meta Superintelligence LabsはMuse WonderとMuse Wonder Fullを投入し、Artificial Analysis Intelligence Index v4.3で52と56…
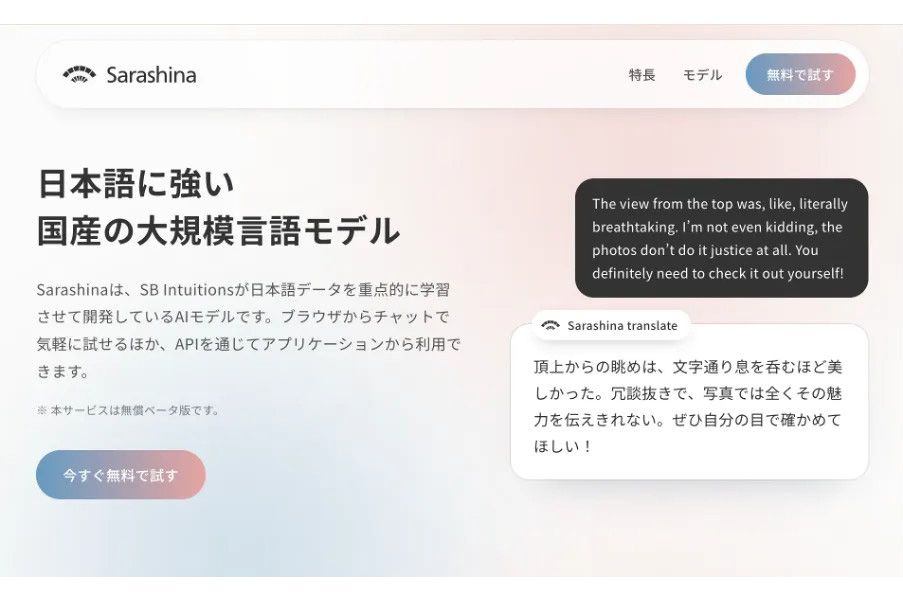
SB Intuitionsが10月13日、Sarashinaサービスの無償β版を開始
「Windows AI and Surface」でNVIDIAとMicrosoftがWindows PC上のAIエージェント計画を発表し、MXCを一般提供、DGX Station for Windowsを予告した
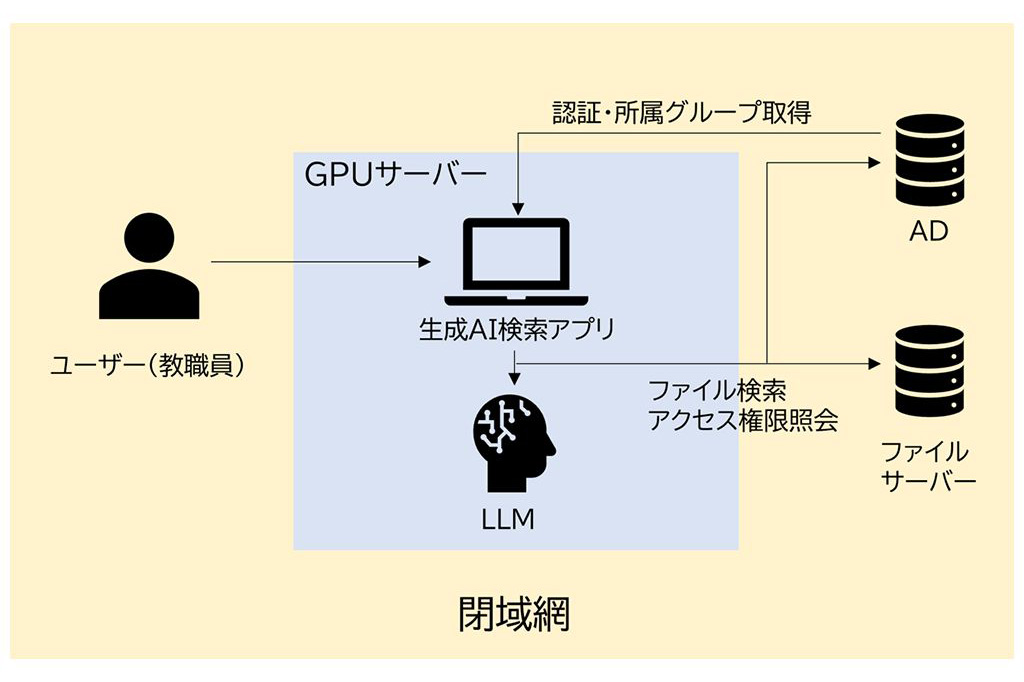
NTT西日本と茨木市は10月13日、市立小中学校で校務向け純国産プライベートLLMの実証を始める
SimpleClosureは4月、Asset Hubでデータ販売を追加