何が起きたか
Metaは9月2日、Muse Spark 1.3を発表し、同日からMuse CodeとMeta Model APIを通じて開発者向けに提供を開始した。エージェント型タスクとコーディング性能が改善され、実用性も向上したとしている。
なぜ重要か
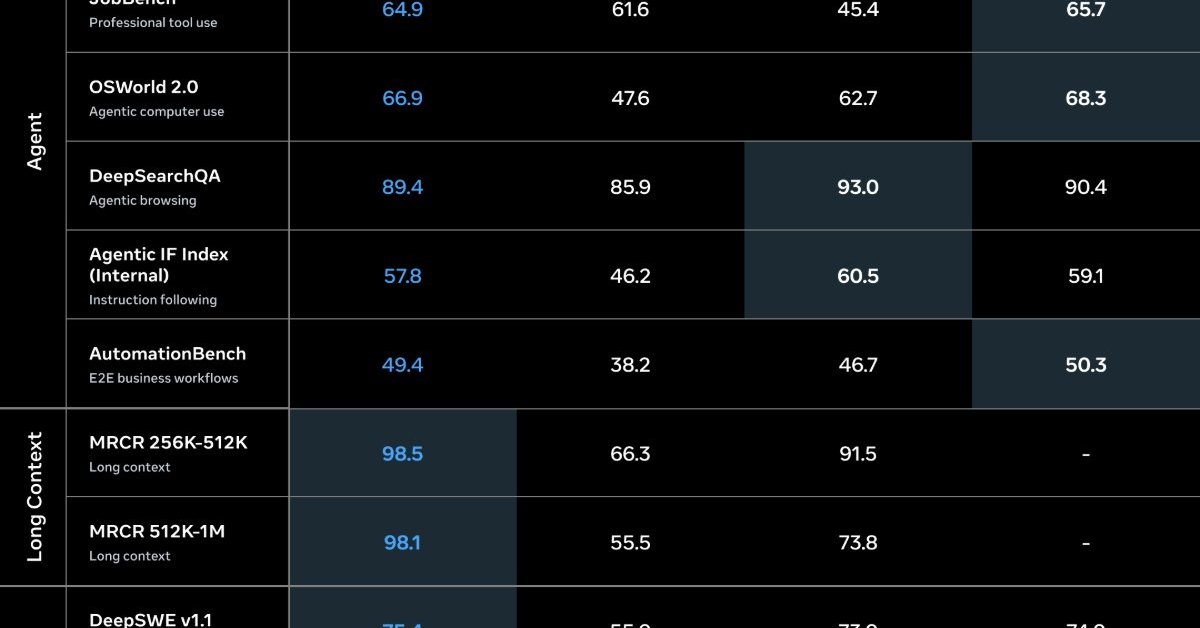
Metaのベンチマーク表によると、Muse Spark 1.3はDeepSWE v1.1で75.4を記録し、前世代のMuse Spark 1.2(55.0)を上回り、Claude Opus 5(74.0)やGPT-5.6 Sol(73.0)も追い抜いた。MRCRの512K〜100万トークン領域では98.1を達成し、1.2の55.5やGPT-5.6 Solの73.8を大きく引き離した。一方、エージェント系ベンチマーク6項目のうち4項目(GDPVal-AA v2を含む)ではClaude Opus 5が最高スコアを記録している。国内の開発企業は、コード生成の性能向上を踏まえ、自社のAI活用競争力の変化を注視する必要があるとみられる。
注目点
エージェント系6項目中4項目でClaude Opus 5がリードを保っており、実業務での総合優位性はなお不確定だ。DeepSWE v1.1の75.4がコーディング偏重の指標である可能性も焦点となる。
こういう要約が、毎朝あなたのメールに届きます。
Muse Spark 1.3は、Meta Superintelligence Labs設立後に4月に初めて導入されたネイティブなマルチモーダル推論モデルの最新版だ。今回のリリースは、実用的なAI利用で繰り返し指摘されてきた2つの課題、すなわち長時間のエージェント型ワークフローでの信頼性維持と、コーディングにおける無駄なやり取りの削減に対応しようとするものだ。同社によると、このモデルは曖昧な指示に対して明確化を求め、行き詰まった際には支援を要請し、影響の大きい行動の前には確認を行うようになった。また、失敗時に結果を捏造しないよう訓練されているという。
ベンチマーク結果は一様ではない。Muse Spark 1.3は、示されたコーディング関連の3指標でトップとなり、特にDeepSWE v1.1では大幅なジャンプを見せた。512K〜100万トークンでテストされた長文脈のMRCR領域でも圧倒的だ。しかし、エージェント系の6指標では、GDPVal-AA v2を含む4指標でClaude Opus 5が最高スコアを記録しており、エージェント分野での優位性は揺るぎないものではない。OpenAIのGPT-5.6 Solを含む同社自身の比較は明らかにプロモーション的だが、Muse Spark 1.2からの改善は具体的だ。
Metaの経営陣はコスト削減と能力向上を同時に推し進めている。ザッカーバーグ氏が、最前線の性能は測定する必要がないほど安価になったと述べたことは、進行中の効率化ストーリーを示している。ロードマップは今回のリリースにとどまらず、より大規模なモデルが計画されており、Muse Spark 1.2のオープンウェイト版は最終的な安全性の微調整後にリリースされる見込みだ。段階的なアプローチは、コードネーム「watermelon」とされるモデルで継続される可能性がある。
たとえば、いま届くならこの3本です
AIが要約して、あなたの選んだトピックだけを1日1通。LINE・Email・Slackで届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。Q&Aはこのページに公開され、他の読者も読めます。
Lightbits LabsがInferraの一般提供を発表

Databricksが検索モデルAdaptive Instructed-Retrieverを拡張

シーコイアがCymphonyの2500万ドル規模のシリーズAを共同主導し、評価額は1億ドル超に

非営利団体ControlAIの米国事務局長コナー・リア氏は、「OpenAIのHugging Face侵害などの安全上の事故は人間より有能なシステムのリスクを示す」と述べた

OpenAIとAnthropicで事前学習に3年間携わったJacob Coxon氏は火曜日に辞任し、自己改善型AIを巡る競争で両社が責任を果たしていないと非難した

評価額25億ドルのAIアシスタントInstinctが独自メールアドレスを展開


