何が起きたか
vfcaiは3x3の局所領域ごとに9x9の文脈から線形関数を推定し、5チャネルの関数マップを生成してCNN分類器に入力。MNISTで99.20%、Fashion-MNISTで92.00%を記録した。
なぜ重要か
CNNが生のピクセルではなく局所関数表現だけで分類できることを示し、通常のCNNやViT入力の代替となり得る。ただし検証はMNISTとFashion-MNISTに限られる。
こういう要約が、毎朝あなたのメールに届きます。
このプロジェクトはシンプルだが異例な前提に立つ。生のピクセルをCNNに与えるのではなく、vfcaiはまず各画像を局所線形パラメータの「Boundary Function Space」へ変換する。3x3の中心領域それぞれを、周囲9x9の文脈から導いた線形関数で記述し、存在確率、x方向・y方向の成分、符号付きオフセット、信頼度を含む5チャネルのマップを得る。この表現を標準的なCNN分類器に渡す。
著者はクラスごと1,000サンプルのMNISTとFashion-MNISTでパイプラインを評価した。結果はMNISTで99.20%、Fashion-MNISTで92.00%となり、局所関数表現だけで学習したCNNでも形状を正確に分類できることを示す。視覚的に似た服飾クラスが混同され得るFashion-MNISTでも同様だ。
今後の課題として著者は二点を挙げる。ストライド幅を変えたときの情報圧縮の挙動と、幾何学的制約を伴う境界認識フィルタが少数ショット学習を改善できるかどうかだ。コードとCLIはGitHubで公開されており、実験の再現や関数再構成の可視化を誰でも試せる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Sony AIなどがStable Diffusion 3 MediumやAmazonのTitan Image G2を含む画像生成14モデルを1,809件のプロンプトで検証し、14モデル全てが少なくとも10%の確率で認識可…
Pruna AIは、MiniMax H3動画モデルを蒸留と構成要素の再構築で最適化したオープンウェイト画像モデルP-H3-Imageを公開
LinumがP-JiTを公開した
Pradaはベテランアニメーターを雇い手描きのクリスマス広告を制作する一方、Coca-Colaはホリデー広告でのAI利用をめぐり反発を受けている
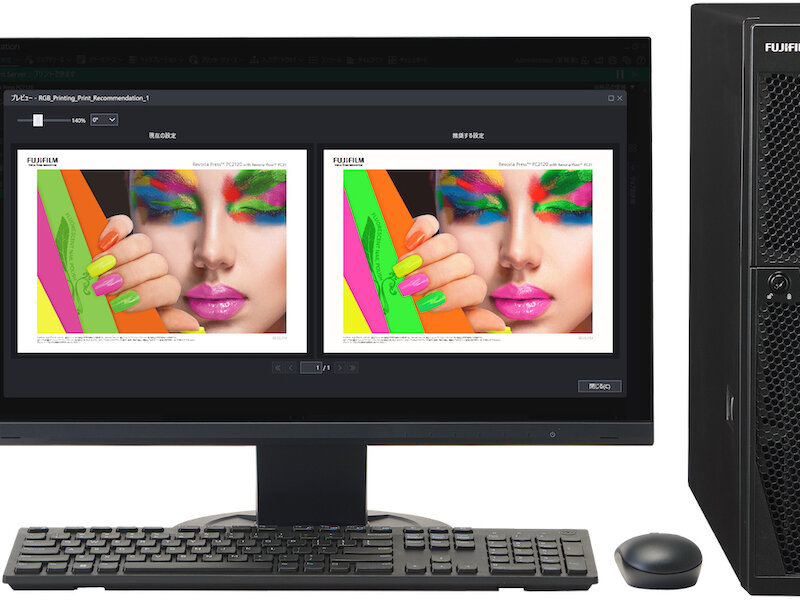
富士フイルムBIはAI「Print Recommendation」をRevoria Press EC2100S/EC2100とSC285S/SC285のオプションとして11月16日から日本とアジア太平洋地域で提供する
筆者は1枚の絵をComfyUIに通して360°回転動画を作り、髪の寸法13項目をJSONファイルに記録、Claude Opus 5.5にBlenderメッシュを生成させ、IoUと毛束幅の検査で元絵と照合した