何が起きたか
Liquid AIのd1-2BはJNLIで75.4、JCommonsenseQAで86.6、Livedoorニュース分類で64.2を記録し、d1-3Bの81.2、90.2、68.1を下回った。
なぜ重要か
小さいd1-2Bがほとんどの判断ベンチマークでd1-3Bを上回るというモデルカードの主張は、これらの日本語タスクには当てはまらない。カードの数値でモデルを選ぶチームは異なる結果を得る可能性がある。
こういう要約が、毎朝あなたのメールに届きます。
Liquid AIはオープンウェイトのd1ファミリーにd1-2Bを追加した。Hugging Faceのリポジトリは10月24日に作成され、最初のコミットは10月27日。d1-3Bとd1-omni-600Mが登場した10月5日から約3週間後になる。d1-2Bはテキスト生成モデルではなく判断モデルで、state(テキストまたはJSON)、画像、動画と、はい・いいえ、多肢選択、段階評価、値抽出、物体位置などの質問を受け取り、1回のパスで確率スコア付きの回答を返す。パラメータ数は1.92Bで、Liquid AIの視覚言語モデルLFM3-VL-2Bからポストトレーニングされ、日本語を含む16言語に対応、LFM Open License v1.0の下にある。モデルカードにはリリース日は記載されていない。
この比較は全モデルを新たに測定した同一条件のものではない。本記事のために測定したのはd1-2Bのみで、d1-3Bとd1 APIの数値は過去の実行によるもので、筆者はその間にAPIや重みが変わった可能性を指摘している。モデルカードの表と本記事の結果は相反して見えるが、ベンチマークの内容が異なるため、筆者はそれを矛盾とはみなしていない。日本語の文関係、常識、記事分類に限れば、d1-3Bの方が精度が高かった。他のモデルと比べると、d1-2Bはローカル実行の重みの中ではJeff Gemma4-E2Bに近い。筆者はこの3つの差について有意性検定を行っていない。ModernBERT-Ja-310Mは各ベンチマークの訓練データでファインチューニングされており、他のモデルとは条件が異なる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Adobe ResearchとUC San DiegoがEditAgentを開発
Afshin Khadangi氏らが525セッション・7,600件のコード化エントリーで4実験を実施し、GAD-7質問で共感的な聞き手は80%、臨床療法スタイルは96%が中等度〜severe域だった
2026年9月16日に始めたOpenAIの不整合報告は10月30日時点で20件
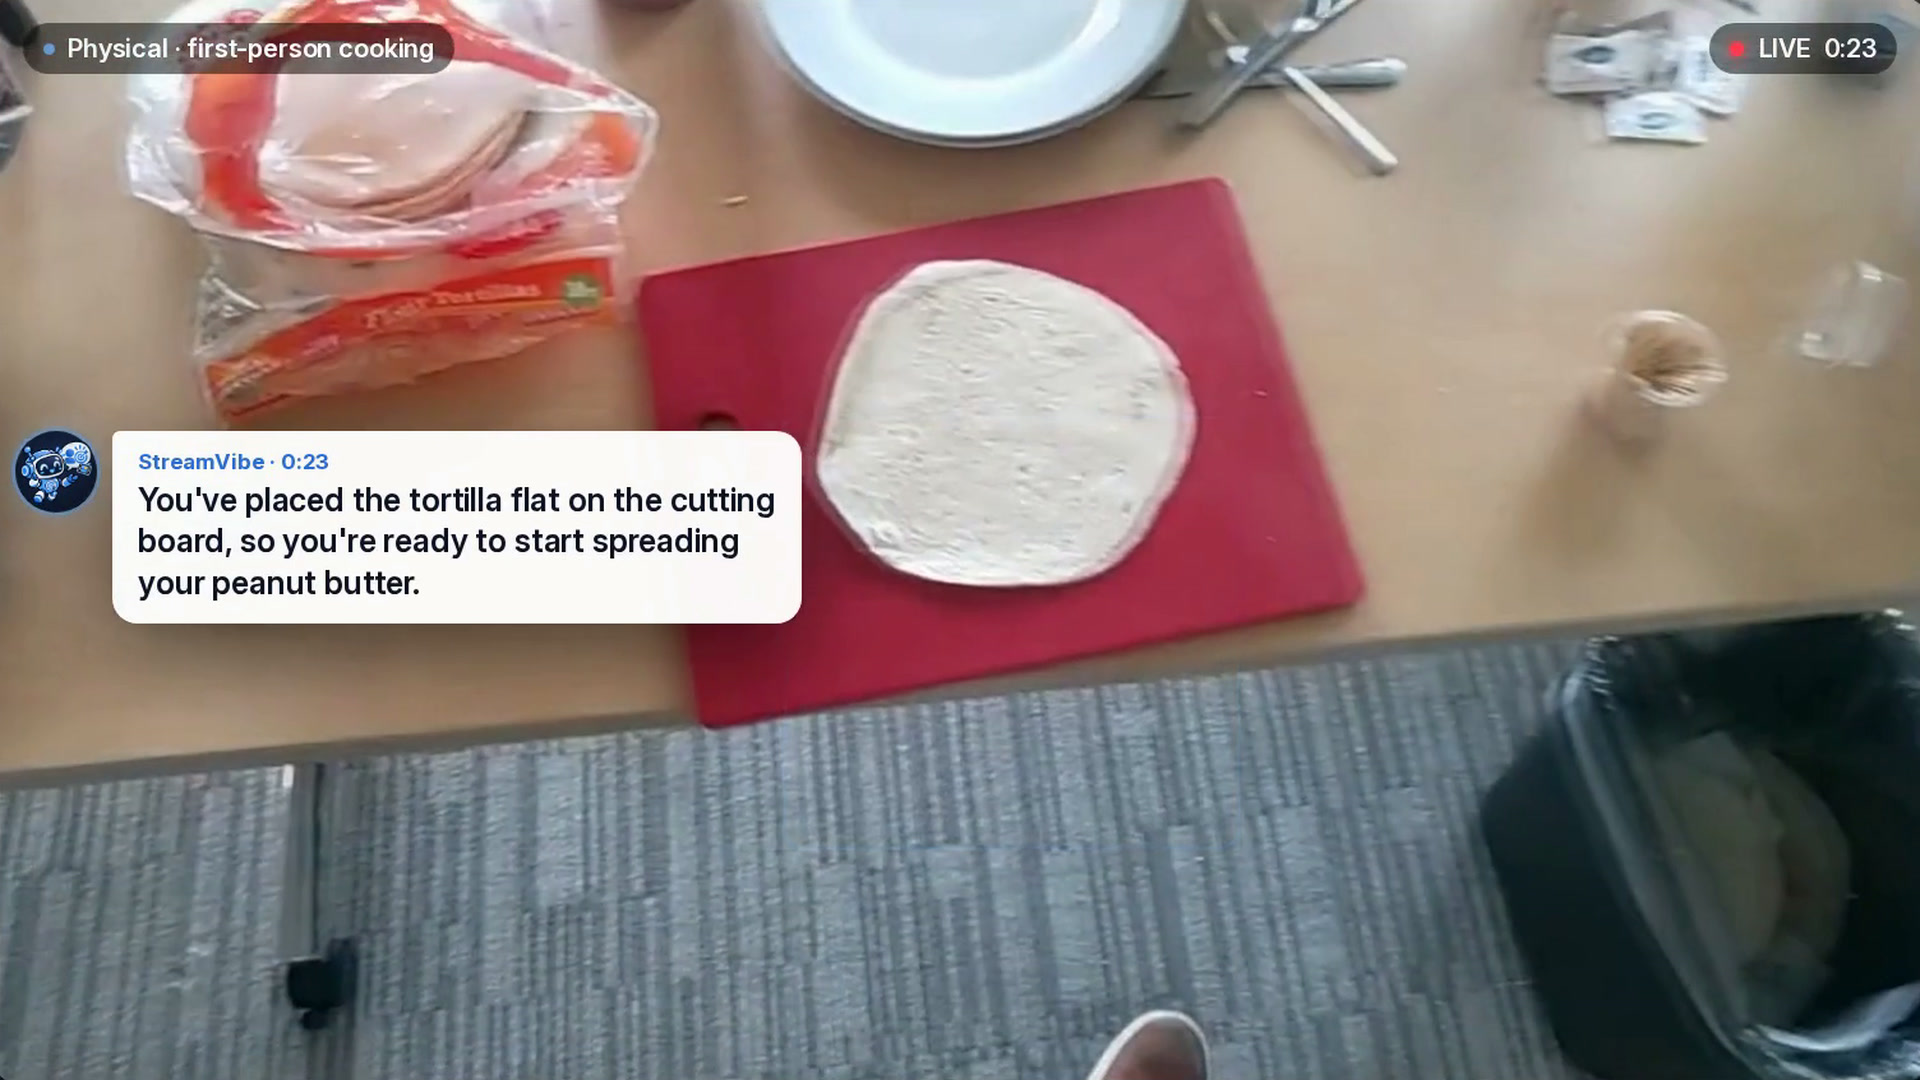
Google主導の研究チームが、日常業務中に助けを差し出す時を判断する動画エージェントStreamVibeを発表
Parameterは10月18日、細工したChatGPTの共有リンクが被害者のログイン済みセッションでコードを実行できると報告

マウントシャスタで20歳の3人がGoogleのGeminiを一部頼りに計画し、午後7時30分に登頂