何が起きたか
筆者は初めて一人で担当した分析案件で、前処理のリークと評価設計の甘さにより実データで精度が半分近くまで落ちた経験を振り返り、その差を埋める日本語版書籍4冊を選んだ。
なぜ重要か
書籍はデータ処理、古典的機械学習、深層学習、生成モデルの順に学習段階として並んでおり、4冊すべてを買わずとも現在のボトルネックに合う1冊を選べる。
こういう要約が、毎朝あなたのメールに届きます。
出発点は具体的な失敗だ。初めて一人で担当した分析案件は交差検証では良いスコアだったが、実データに差し替えると精度がおよそ半分に落ちた。筆者は原因を前処理のリークと評価設計の甘さの2点に求め、知識の量よりも順序立てて学ぶことの重要性を導く。生データ処理とモデル検証の基礎を欠いたままアルゴリズム名だけを知っても役に立たないというわけだ。
4冊はこの診断に沿って並ぶ。最初の2冊で土台を築き、NumPyとpandasの内部から特徴量エンジニアリング、評価、Pipelineの実践へと進む。残る2冊で表現の幅を深層学習と生成モデルへ広げる。1冊目の機械学習の章はアルゴリズム入門の域を出ないと筆者は注記するが、それ以前の下地があれば読む速度は保たれ、2冊目は数式を意図的に抑えて決定境界の図とコードを重視している。
最後の助言は年次ではなく具体的な症状に書籍を結びつける。データ整理が絡み合うならハンドブック、検証と本番のギャップならscikit-learn本、深層学習の使い方を吟味したいならKeras本、生成AIの内部への好奇心なら最後の1冊だ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
OpenAIのGPT-5.6 Solが「php2shell」と呼ばれるPHPの重大脆弱性CVE-2026-109618とCVE-2026-109619を発見し、PHP Foundationは10月21日午後11時に緊急パ…
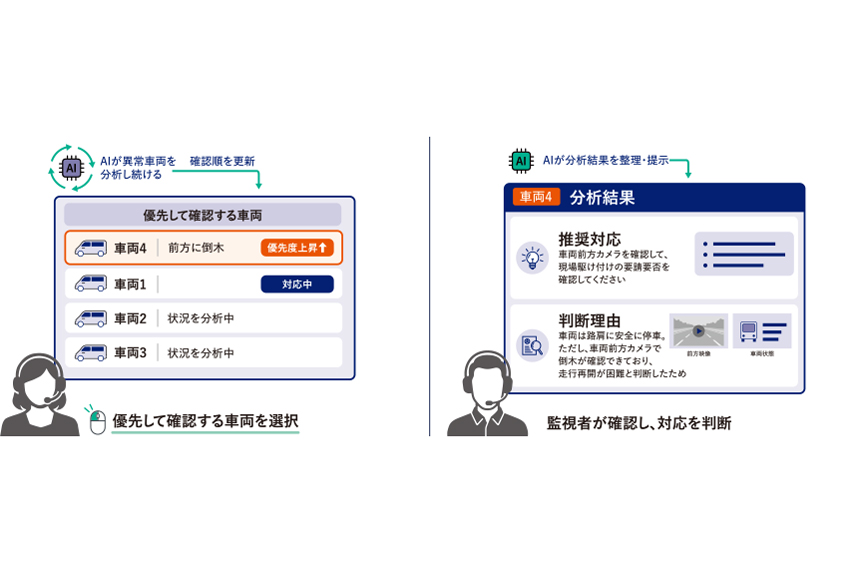
KDDIがレベル4自動運転の1対N遠隔監視向けAIエージェントを開発
インプレスは10月22日、Gemini Notebook(旧NotebookLM)の実践的な「推し技」100個を紹介する書籍を発売する
KDDI、沖縄セルラー、KDDI Digital Lifeは10月22日、povo AIにChatGPT 5.5、ChatGPT 5.5 Pro、ChatGPT 5.5 Thinkingを追加した
GoogleとOpenAIはGPT-6 Astra、GPT-6.1 Sol、GPT-6 LunaをModel Garden経由で提供し、一部顧客向けプレビューを開始した
OpenAIがChatGPT広告を26カ国へ広げ、世界89市場に拡大