何が起きたか
FLUX.2-Klein-Base 4Bを4サンプリングステップで使うとVA-TDMはGenEval 0.80対0.78、OCR類似度0.69対0.64、LPIPS多様性0.56対0.47を報告。
なぜ重要か
同じ4ステップの計算量で改善しており、追加のサンプリングステップではなく手法自体による向上だと論文は位置づける。
誰に効くか数ステップ拡散モデルを評価するAI画像生成チームは、公開GitHubリポジトリで手法とコードを入手できる。現在の4ステップベースラインと比較試用しやすくなる可能性がある。
こういう要約が、毎朝あなたのメールに届きます。
論文はVA-TDMを単一の新しい工夫ではなく統一的な視点として位置づける。著者らはこのフレームワークが「スコア蒸留、Fisherベースのマッチング、モーメントマッチングを統一し、既存のヒューリスティックなMMD更新も説明したうえで新たな学習目的を提供する」と書く。数ステップ拡散の研究では多くの個別のヒューリスティックが生まれてきたが、VA-TDMはそれらを生徒と教師の速度場の間の一つの敵対的ゲームとして扱えると主張する点が注目に値する。
結果は2つのモダリティにまたがる。画像側ではFLUX.2-Klein-Base 4Bを4サンプリングステップで使って検証し、報告されたGenEval、OCR類似度、LPIPS多様性の数値はいずれも同じ計算量の公開4ステップモデルを上回る。動画側では33Bのテキスト動画モデルMiniMax-H3に4-NFEの計算量で適用し、ユーザー調査ではVA-TDM-H3が同じ計算量のFast-H3との一対比較で61.33%に勝利した。要旨は「テキスト画像生成とテキスト動画生成の両方で、さまざまなバックボーンにわたり4ステップで最先端の性能」をうたう。
発表時期から見ると、VA-TDMは今週続くAI動画の蒸留やRL学習の論文の流れの中にある。取得したページには著者の所属機関の記載がなく、この研究の機関的な後ろ盾はそこでは示されていない。github.com/Luo-Yihong/VA-TDMでのコード公開により、実務者は報告された比較を直接調べて再現できる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
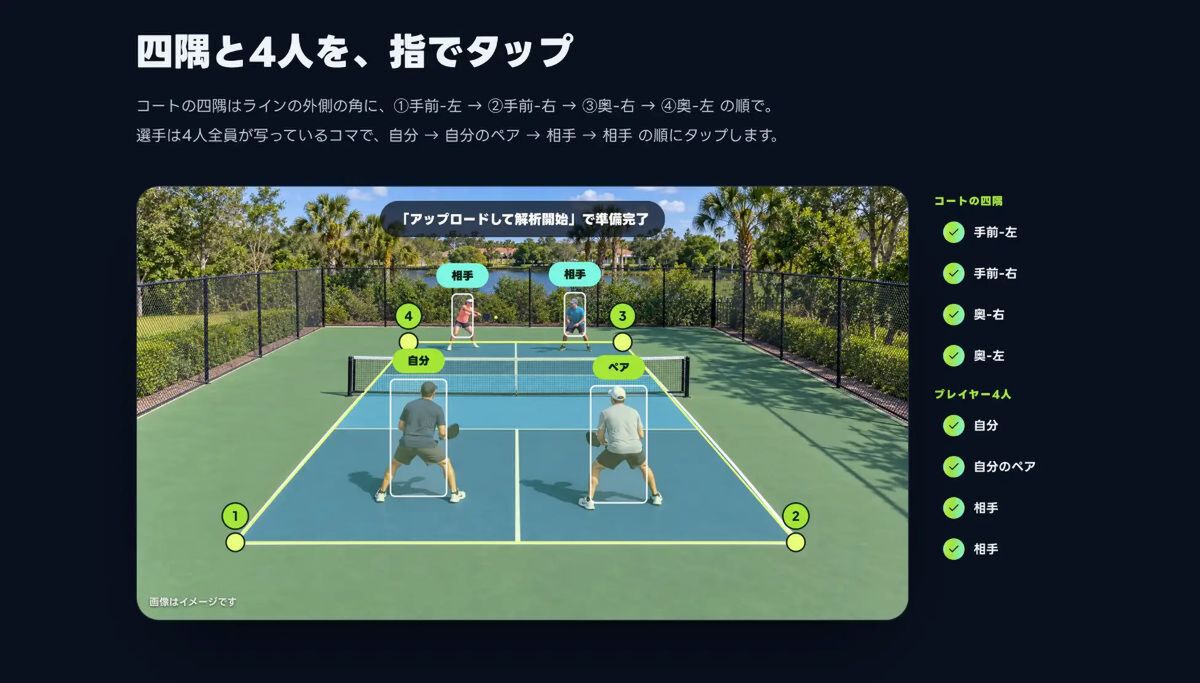
DWZは11月17日、PickleballMeをApp Storeでリリースした
Appleの研究者らが論文「Split-and-Scale Latent 3D Representations」を発表した
ブラックバーンにあるマクドナルドのAI制作壁画が、地元の名所とつづりを間違えた
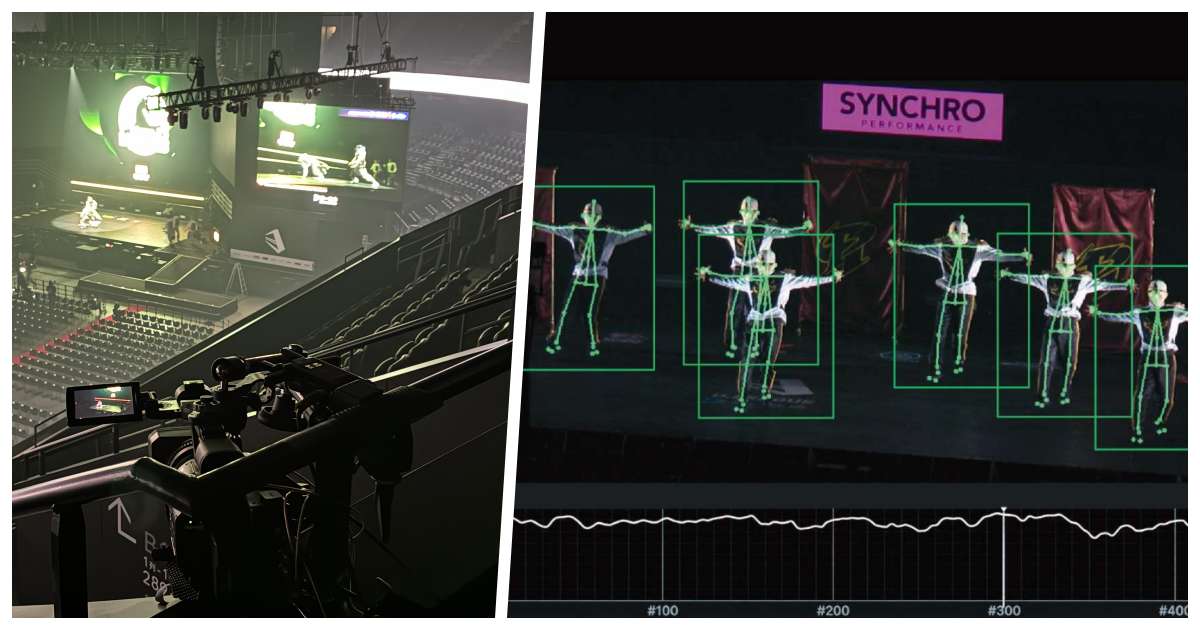
ソニーは複数カメラとAI画像解析を組み合わせ、8人のダンサーの動きの同期を数値化する映像解析システムを開発
Zennのガイドが、CLIP系モデルで画像とテキストを同じベクトル空間に写し、自然言語で個人の写真・動画ライブラリを検索する実装方針を公開
2025年8月18日にApache-2.0で公開されたQwen-Image-Editは、20B MMDiTバックボーンを持つ20.43Bパラメータのモデルである