何が起きたか
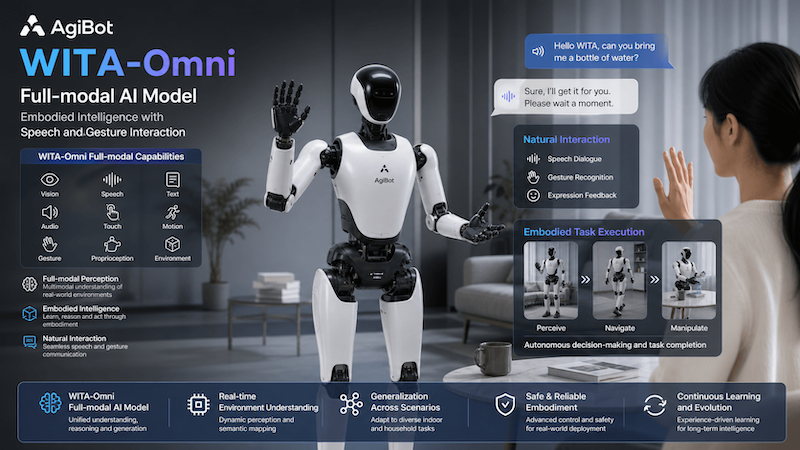
AGIBOTのWITA-Omni Previewファウンデーションモデルが、Daily-Omniオーディオビジュアル推論ベンチマークで平均精度85.21%を達成し、Alibabaの Qwen3.5-Omni-Plus、GoogleのGemini 3.1 Pro Preview、ByteDanceのDoubao Seed 2.0 Liteなど競合他社を上回った。報告された8つの評価指標のうち6つで第1位または同率第1位にランクインした。
なぜ重要か
Daily-Omniベンチマークは、AIモデルが実環境でオーディオとビジュアル情報を同時に理解できるかどうかをテストするもの。AGIBOTは、ロボットが動的環境で動作する際に音と動作を関連付け、イベントのシーケンスを追跡し、いつ応答すべきかを判断する上で、この能力が不可欠だと述べている。画像テキストベンチマークとは異なり、Daily-Omniはオーディオ、ビデオ、およびそれらの組み合わせ全体でのクロスモーダル推論を評価する。
注目点
AGIBOTのWITA-Omni Previewは、リアルタイムで音声と協調した物理的動きおよび顔表情を生成する「Thinker-Talker-Actor」アーキテクチャを統合している。同社はこの技術をヒューマノイドロボット、四脚ロボットを含む自社のロボットプラットフォームに統合し、より自然な人間とロボットの相互作用を実現する計画を立てている。
こういう要約が、毎朝あなたのメールに届きます。
Daily-Omniに関するAGIBOTの成果は、ロボットのためのファウンデーションモデルがどのように評価されているかの転換を反映している。従来のAIベンチマークは画像テキスト理解に重点を置いているが、Daily-Omniはクロスモーダル推論、つまり音を可視イベントにリンクし、状況がどのように時間とともに発展するかを理解する能力をテストする。物理環境で動作するロボットなどの具現化されたAIシステムは複数のデータストリームを同時に解釈する必要があるため、この区別は重要である。声は聞こえるが話者と結びつけられない、あるいは周囲で展開しているイベントのシーケンスを見逃すロボットは、自然に相互作用したり安全な決定を下したりするのに苦労するだろう。
数千万時間のマルチモーダルデータで訓練し、その後数千時間の人間中心の相互作用記録で、モデルを洗練させるというAGIBOTのアプローチはこのギャップに対処している。オーディオ、ビデオ、動き、顔表情の時間的関係(タイミングと順序)に対する同社の強調は、いつどのように応答するかを学ぶことが、応答するかどうかを学ぶのと同じくらい重要であることを示唆している。これはAGIBOTの明記された設計目標と一致している:正確な応答を生成するだけでなく、適切性、タイミング、および意図した受信者を決定することである。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。