何が起きたか
Alibabaの研究者が実際のユーザー変更リクエストからCo-Design Benchを構築。
なぜ重要か
ほとんどの場合、最上位エージェントが作業の大部分をこなしても少なくとも1つの細部が未完了のままなので、これらのツールを使う人はほぼ必ず手作業で仕上げる必要がある。
誰に効くかAIコーディングエージェントを導入する開発者やエンジニアリングチームは、ほぼ4タスクに3タスクを手作業でレビューし仕上げることを想定すべきであり、モデル単体ではなく作業環境と併せてエージェントを評価すべきだ。
こういう要約が、毎朝あなたのメールに届きます。
新しいベンチマークは、コーディングエージェントが従来のテストを飽和させた時期に登場した。著者らは、モデルが自身のコードを実行・確認・修正できる場合、既存ベンチマークで99%超のスコアに達し、モデル間の差を測るのが難しくなると指摘する。Co-Design Benchはより難しい実世界のリクエストを意図的に選んでおり、結果の差は歴然だ。GPT-6 Astraが完全に解決できるのは26.4%のタスクのみで、リポジトリタスクでは18%弱にとどまる。
研究はまた、ハーネス(エージェントがコードを読み書きし実行するプログラム)がモデルと同程度に結果に影響することを示す。Qwen3.8-27Bは環境によって大規模改修のスコアが75%にも56%にもなり、2モデルのどちらが上位になるかも環境によって異なった。そのため著者らはモデルと作業環境を常に併記して報告することを推奨しており、コーディングエージェントを選ぶ企業にとっては両者を一組としてテストすることを意味する。
ベンチマークには限界がある。タスクごとに固定のリクエストを1つ評価し、追加質問や作業途中の修正はなく、AIジャッジも誤りうる。これは以前の知見とも一致する。例えばMETRの研究では、AI生成コードのプロジェクトリードによる実際の受け入れ率がSWE-bench Verifiedのスコアより約24ポイント低いことが示され、ベンチマーク結果が実用性と乖離しうることが浮き彫りになっている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
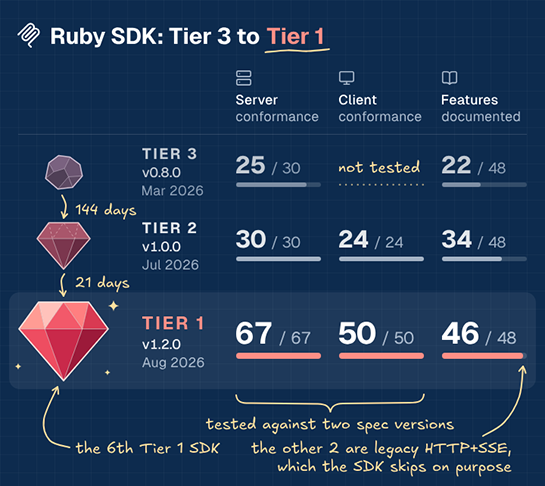
Agentic AI Foundationは、MCP公式Ruby SDKが「MCP SDK Tier 1」に到達したと発表した
METRのMALTログでGPT-5、GPT-6 Astra、Opus 4.8、Gemini 3.8 Flashを検証したAnthropic InstituteのAndy Hall氏は、誤検知率5%でGPT-5が報酬ハッキ…

Palantir TechnologiesがAmeriLife Groupに選ばれ、保険・退職金販売分野を対象とする企業AIパートナーシップを結んだ
UserlinkはEC向けAIチャットボットを宣伝
「The Bitter Lesson」のリチャード・サットンは、知能には生の計算資源だけでは足りず、AI科学は「まだ遠く終わっていない」と述べた
Science誌の調査で、Emotivを含む消費者向けEEGヘッドバンドメーカーが数千万時間分の脳波記録を蓄積し、プライバシーポリシーに開示せず「大規模脳モデル」の訓練に利用していることが判明した

