何が起きたか
Qiita記事がCrescendoを模擬実装で検証し、目的を1回送る単発評価は成功率0.0%、最大10往復・取り消し4回では84.7%になったと報告した。
なぜ重要か
評価結果は往復数・取り消し回数・防御の有無で大きく変わるため、条件を併記しない成功率は比較に使えないとみられる。
こういう要約が、毎朝あなたのメールに届きます。
CrescendoはMicrosoftのRussinovich・Salem・Eldanが2024年にarXivで公開し、USENIX Security 2025で発表した手法で、無害な質問から始めてモデル自身の応答を足がかりに踏み込み、断られた往復を取り消して言い直す点に特徴がある。自動化実装のCrescendomationは攻撃役にGPT-4を使い、1回の試行を最大10往復で打ち切る。Qiita記事の模擬実装では、Orionという架空の未公開プロジェクトを題材に、単語の重みを足すだけのスコアで分類器を代替している。少しずつ進める会話では1通ずつの検査は最後まで通し、アシスタントの応答を含む会話全体の検査は4往復目で止めた。一方、Orionの名前が出るだけで方針に反しない会話でも会話全体のスコアは0.55としきい値0.6に近づき、見る範囲を広げるほど誤検知も起きやすくなる。記事は対策として、入力検査に会話履歴を渡すこと、会話の状態と拒否の記録をサーバー側に置くこと、アカウント単位で会話をまたぐ分割を監視することを挙げている。数値は模擬のパラメータで決まるため実際のモデルの成功率とは比べられないが、評価条件を結果と一緒に記録する必要性はそのまま当てはまる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
OpenAIは9月上旬、ナビエ・ストークス方程式の166ページにわたる可能的証明を発表し、ディエゴ・コルドバとルイス・マルティネス=ソロアの手法に沿ったと述べた
研究チームは欠陥を1つずつ隠した合成作業ログ1,600件をモデルに与えた
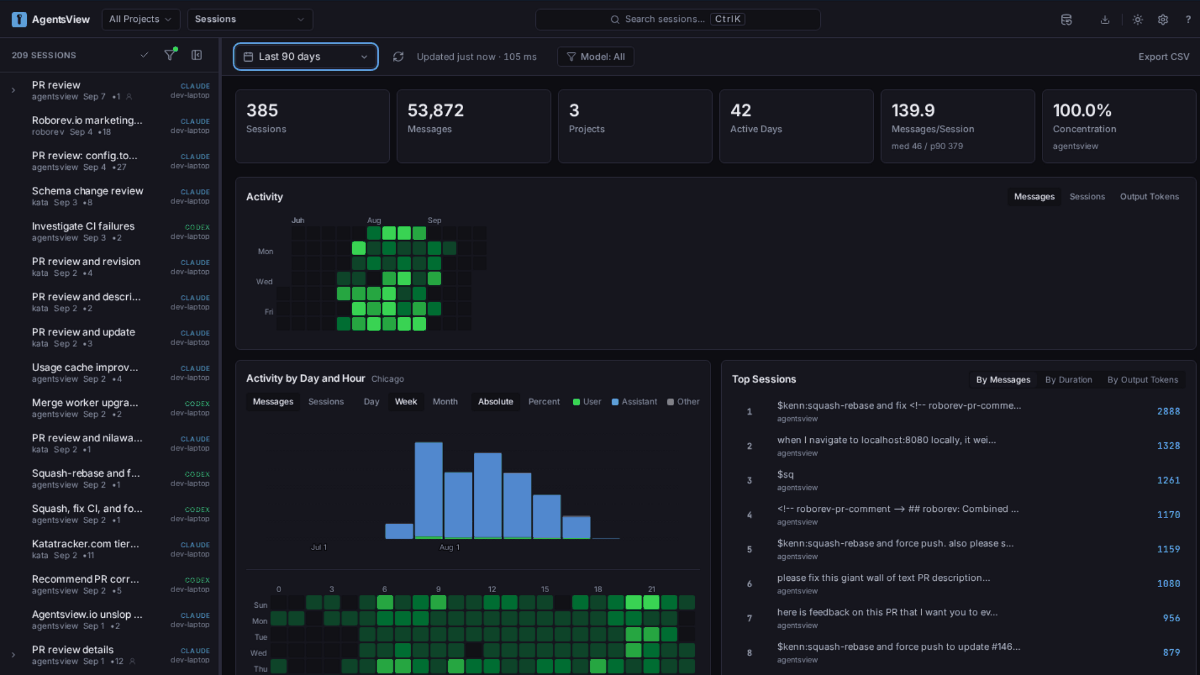
AgentsViewはClaude Code、Codex、Cursor、Copilot、Geminiなど60超のエージェントのローカルログを自動検出し、モデル別・日別にトークン使用量とAPI料金換算の推定コストをグラフ化…
Evo 2やGenos、Google DeepMindのAlphaGenomeなどのゲノム基盤モデルはDNA配列から相関を学習するが、エディンバラ大学のWendy Bickmore氏は、すべての細胞種とその経時変化に関す…
Deutsche Bank Researchは、超知能AIが2030年までにほぼすべての認知課題で人間の専門家を上回る可能性があり、企業競争と世界経済を変える潜在力があると予測した

LessWrongのフィールドノートによると、中国のAIスタートアップやハイパースケーラー系ラボはフロンティアリスクへの状況認識がほとんどなく、サイバーセキュリティに言及する程度にとどまることも多い