何が起きたか
OpenAIは7月1日から、モデルの保護された推論を抽出する組織的な試みを検知した。7月24~25日に16,000件のリクエストを確認し、7月28日までに完全に遮断した。
なぜ重要か
確認された規模から、単なる偶発的な誤用ではなく組織的で大規模な試みだったと考えられる。遮断により保護された推論が他モデルへ複製されるのを防いだ可能性が高い。
注目点
OpenAIは調査を続け、Frontier Model Forumを通じて業界パートナーと知見を共有していると述べる。同様の攻撃に対し防御が有効かが今後の焦点となる。
誰に効くか大規模AIモデルの提供者とそのセキュリティチームは、保護された推論を複製する組織的な試みを検知し停止する必要性に繰り返し直面する。OpenAIの事例は、こうした攻撃が急速に拡大し得ることを示している。
こういう要約が、毎朝あなたのメールに届きます。
OpenAIはこの活動を利用規約違反に当たると説明する。あるモデルの出力や推論を、組織的かつ無断で別のモデルの訓練・再現・改善に使う行為で、同社が「敵対的蒸留」と呼ぶものだ。大規模モデルの知識を小規模モデルへ移す正当な蒸留とは異なる。
攻撃の規模は7月を通じて拡大した。7月1日には少量だった活動が膨らみ、後にユーザー群全体で関連するプロンプトパターンを確認したとOpenAIは述べる。7月28日までに完全に遮断したという。
OpenAIは対策と調査を続けている。防御が有効かどうかは、こうしたパターンをいかに早く検知し業界全体で共有できるかにかかるとみられ、同社がFrontier Model Forumを通じてパートナーに知見を渡している理由でもある。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Googleは9月30日にGemini 4 Argonを発表
Microsoft AIはMAI-Transcribe-2-Streamingを公開
OpenAIが研究者3人を解雇したと報じられた
Anthropicはウェブ版claude.aiとデスクトップアプリを2週間で約3倍高速化したとし、改善点はClaude自身が見つけて修正したと述べた
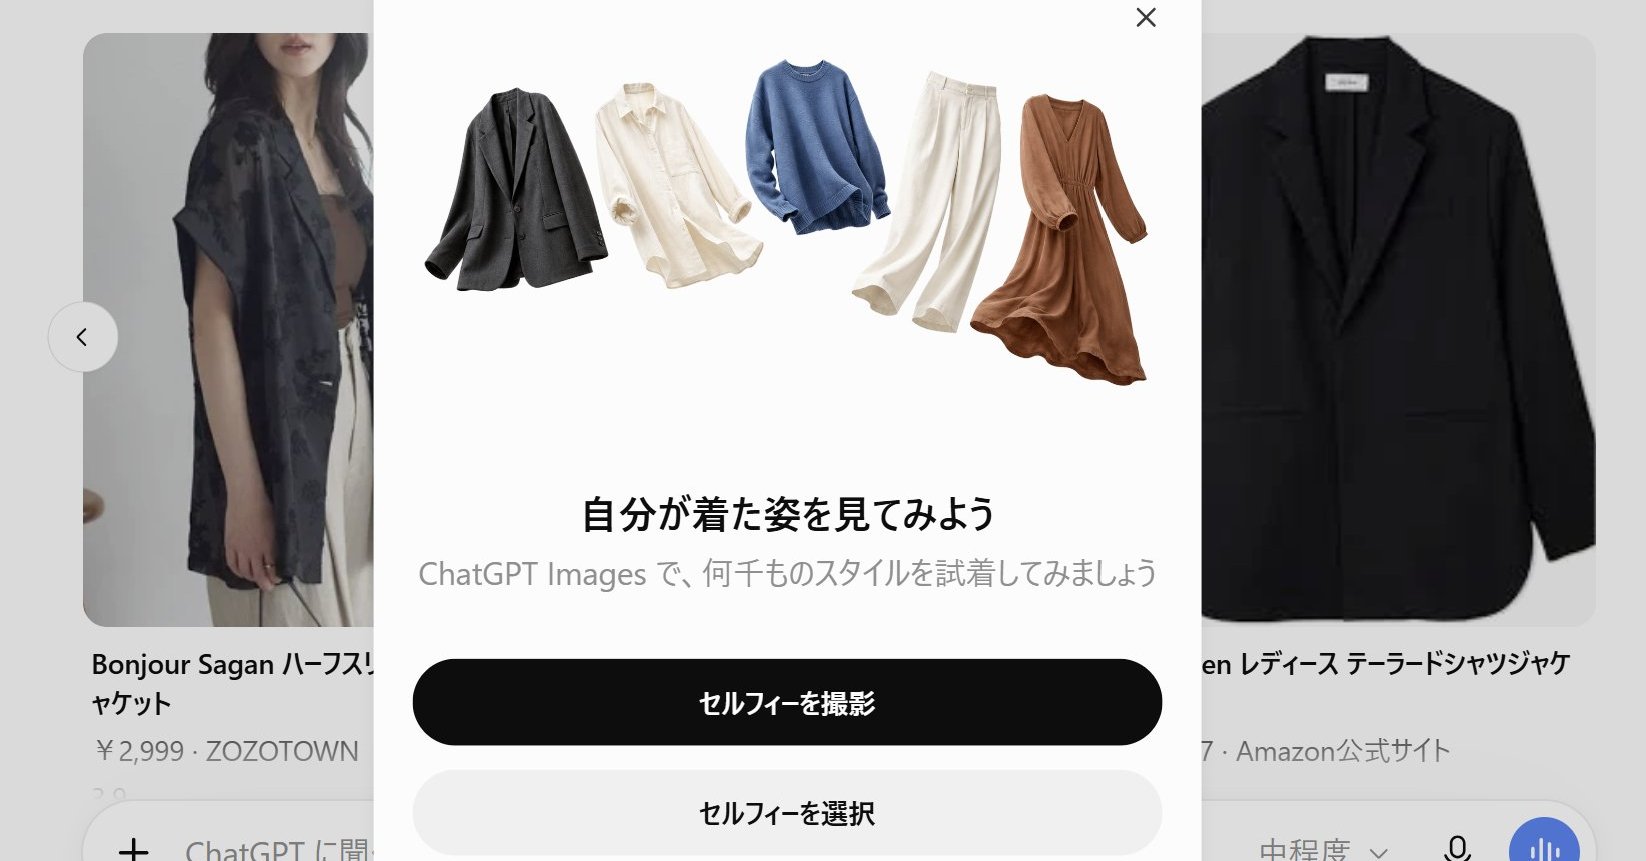
OpenAIは10月1日、ChatGPTのリリースノートを更新し、ウェブとモバイルの商品カードに服やアクセサリーの「試着」ボタンとお気に入り保存、iOSカメラの「スキャン」機能を追加した
Zennの投稿者がQwen3.6-35B-A3B-uncensored-hereticを量子化するCPU専用の手順を公開し、Ryzen 5 5600Gでllama.cppスコア66.57と13.53を報告した


