何が起きたか
higurashi-ai/Haru-4B(Apache-2.0)はharu-inference CLIでCPU422.1~462.1ms、RTX 5060 Ti 72.5~104.9msで設計133msを下回った。
なぜ重要か
全二重動作が不安定で、同じ入力でも無応答、ユーザーの発話終了後の返答、発話の重なりが生じたため、単一の出力では相槌モデルとも無応答モデルとも断定できない。
こういう要約が、毎朝あなたのメールに届きます。
Haru-4Bは全二重音声対話モデルとして設計されており、ユーザーが話し終えるのを待たずに、同じ133msのフレームで聞き取りと自身の音声・テキスト生成を並行して行う。テストではApache-2.0のコードとモデルをGitHubから直接インストールし、同梱のharu-inference CLIをオフラインで実行した。Hugging Face Spacesのデモは使わず、有料APIキーも不要だった。CPUのみのマシンでは9回の実行で1フレーム422.1~462.1ms、GPUなしのRyzen 7 7700では445.7msと、実時間の約3.2~3.5倍遅かった。NVIDIA RTX 5060 Tiでは8回の実行で1フレーム72.5~104.9ms、PyTorchコーデックの平均は約87.5ms、Tritonコーデックの1回は72.5msだった。Webデモサーバーは6.7秒でモデルを読み込み、86.1msでウォームアップし、GPUメモリを約13,592MiB使用した。全二重動作自体は一貫せず、出力テキストをユーザー音声のRMSと突き合わせると、CPUの1回は発話中に相槌を入れた一方、英語のGPU実行はほとんど無言か一言だけ、日本語のGPU実行はユーザーが話し終えてから発話を始めた。同じシードでもGPUとCPUで出力が異なったため、単一の実行でモデルを判断するのは誤解を招く。ブラウザのマイクを使ったリアルタイム会話は未検証である。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
ShweetsStuffがGTAパロディー楽曲にSunoのメタデータを発見し、Nicalisは『The Binding of Isaac: Repentance Plus』を更新してAI生成音楽を削除した
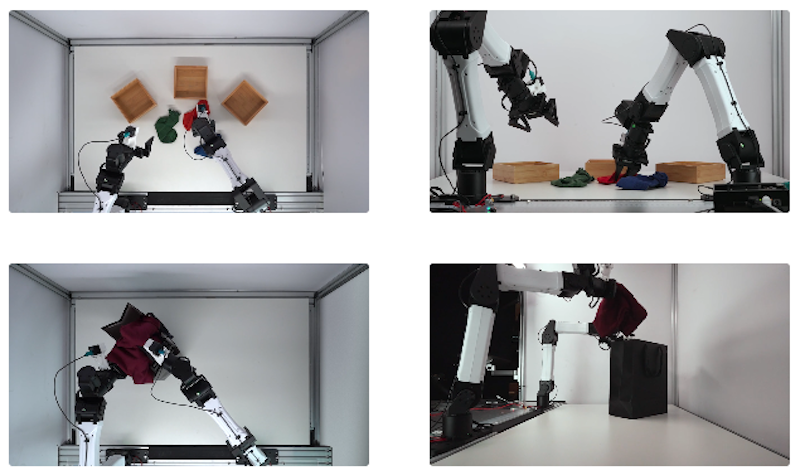
Runwayが27-billion-parameterのオープンウェイト世界行動モデル「Praxis-1」をApache 2.0ライセンスで公開した
Irodori-TTSを試した筆者は、4kHz超で見本より4〜7dB静かに発話すると判明(―31.9dB対―22.9dB)
MomongaCodeがMITライセンスで公開された
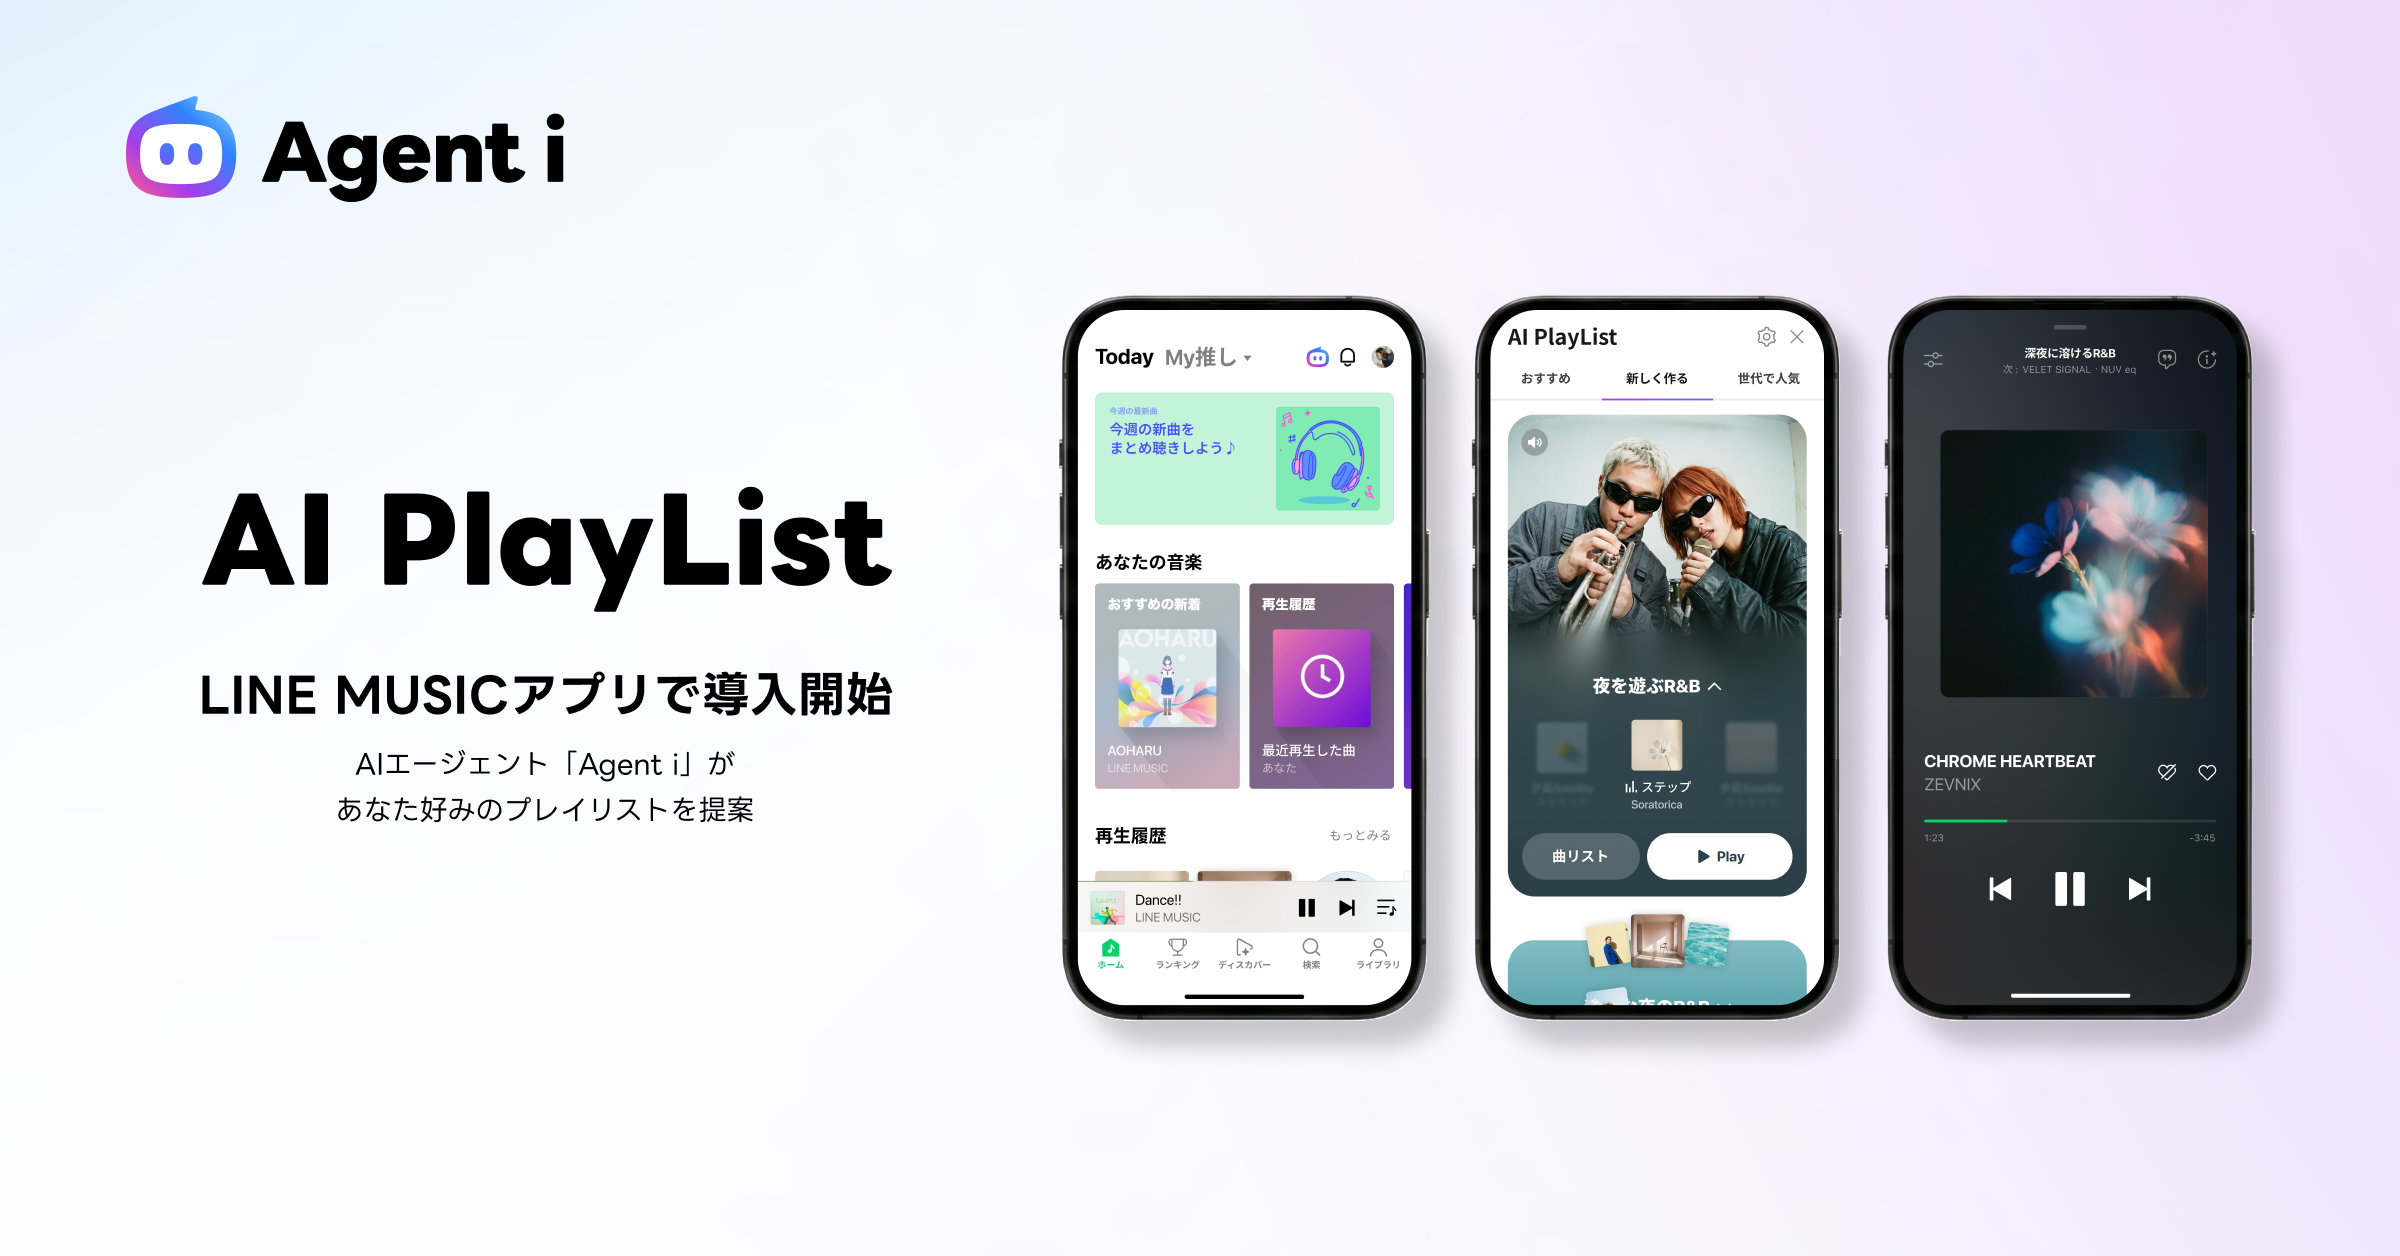
LINE MUSICとLY CorporationのAIエージェント「Agent i」が、個々の視聴好みに合わせたプレイリストを提案する機能「AI PlayList」を導入した
Gyro Governance LabがAI安全性研究向けデスクトップアプリAIR Officeを公開