何が起きたか
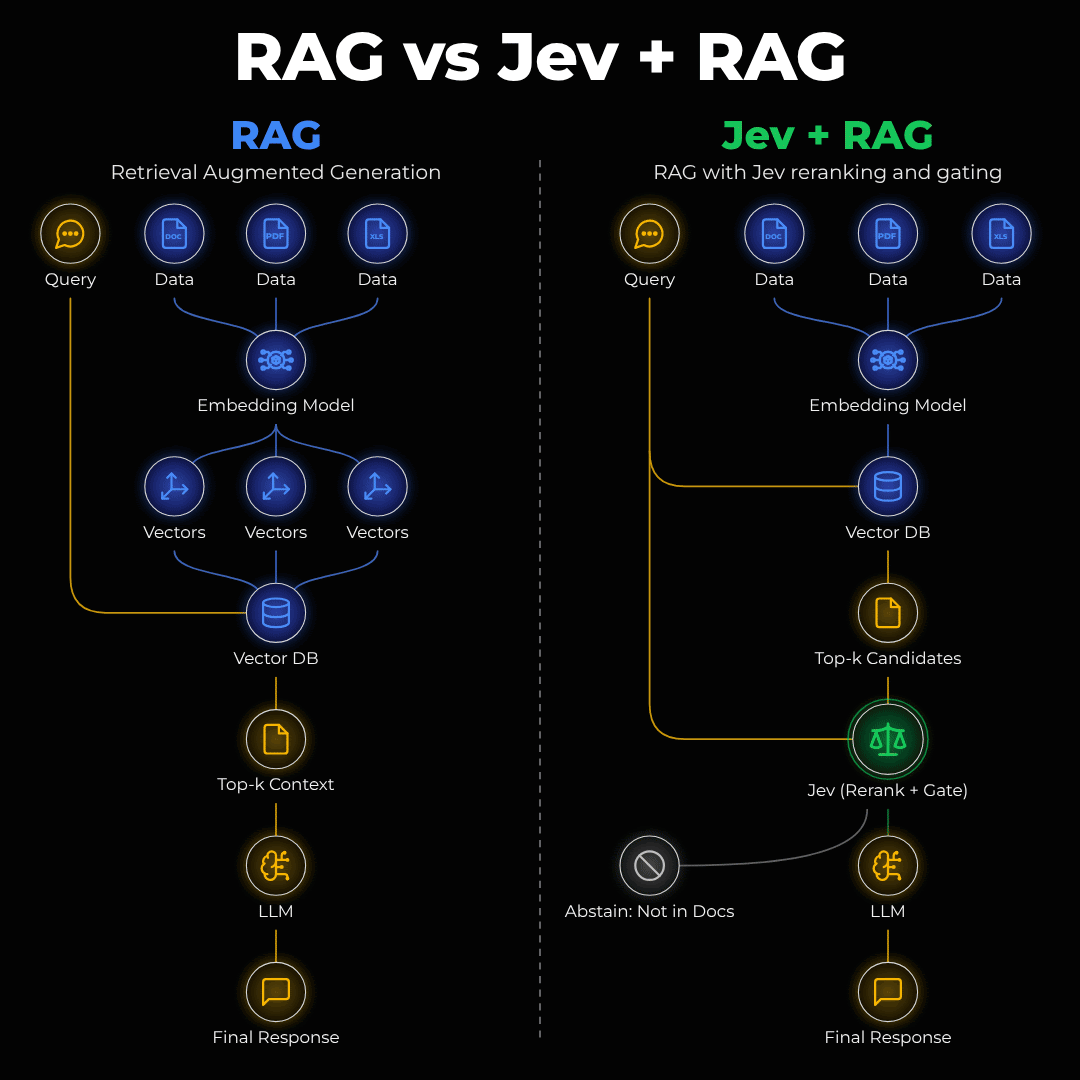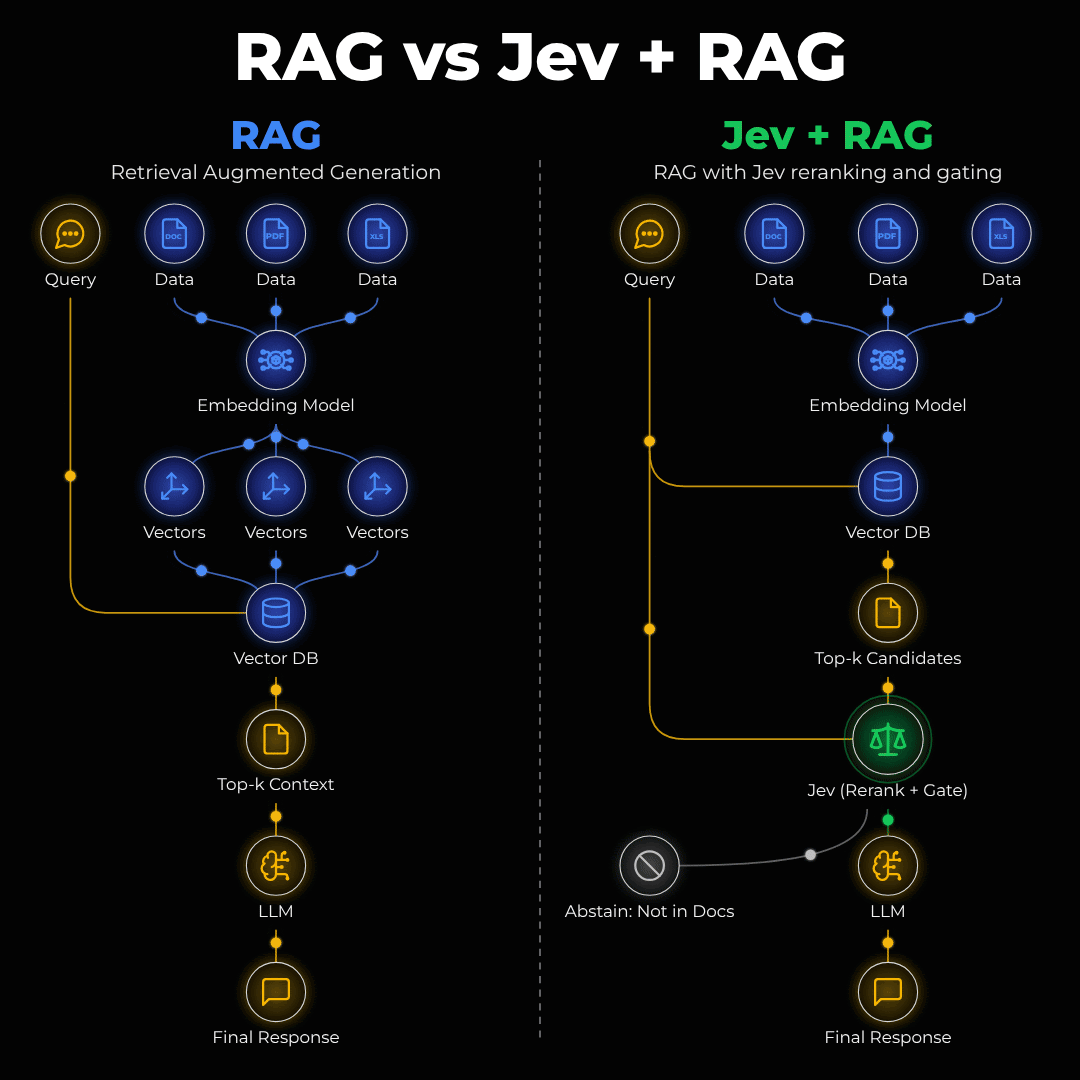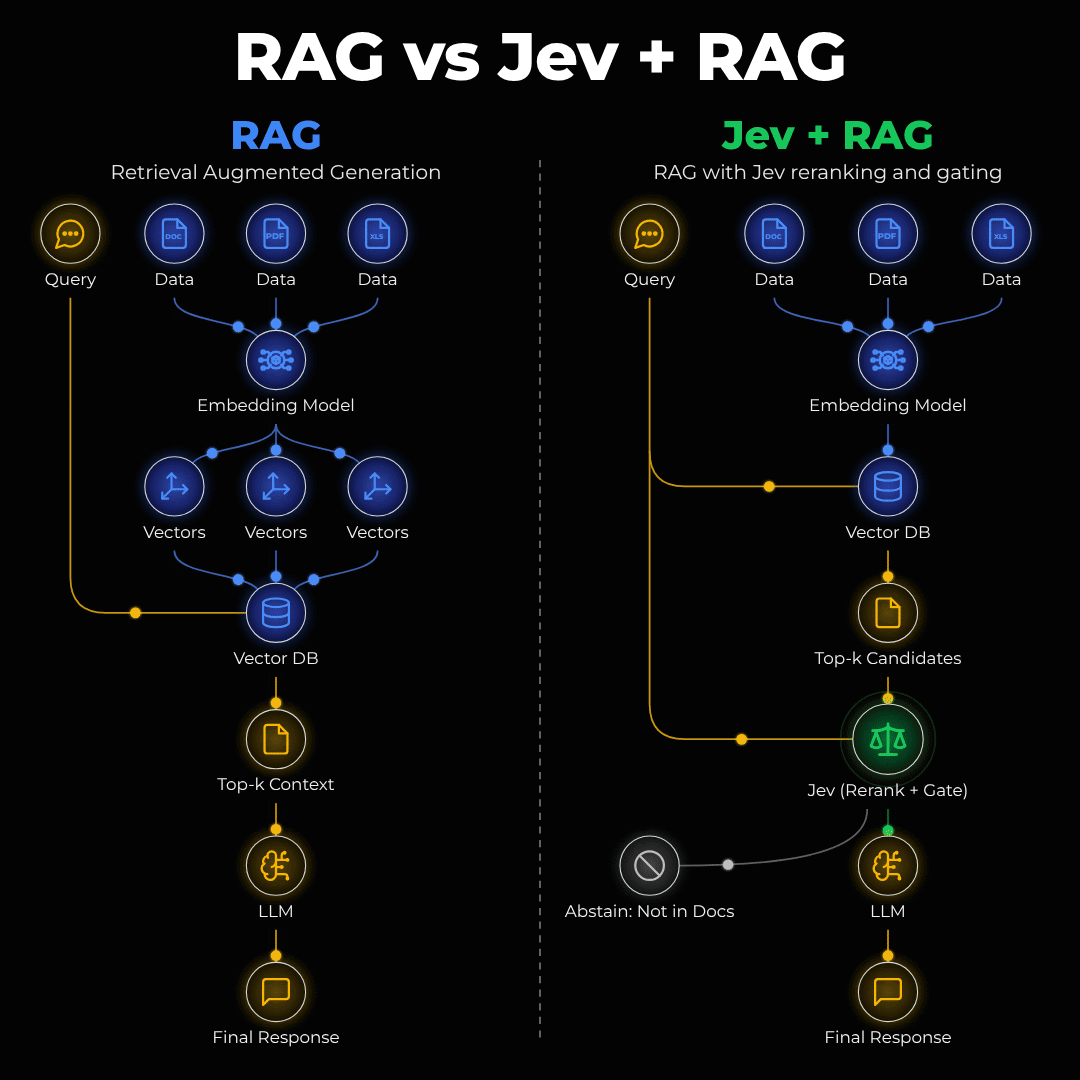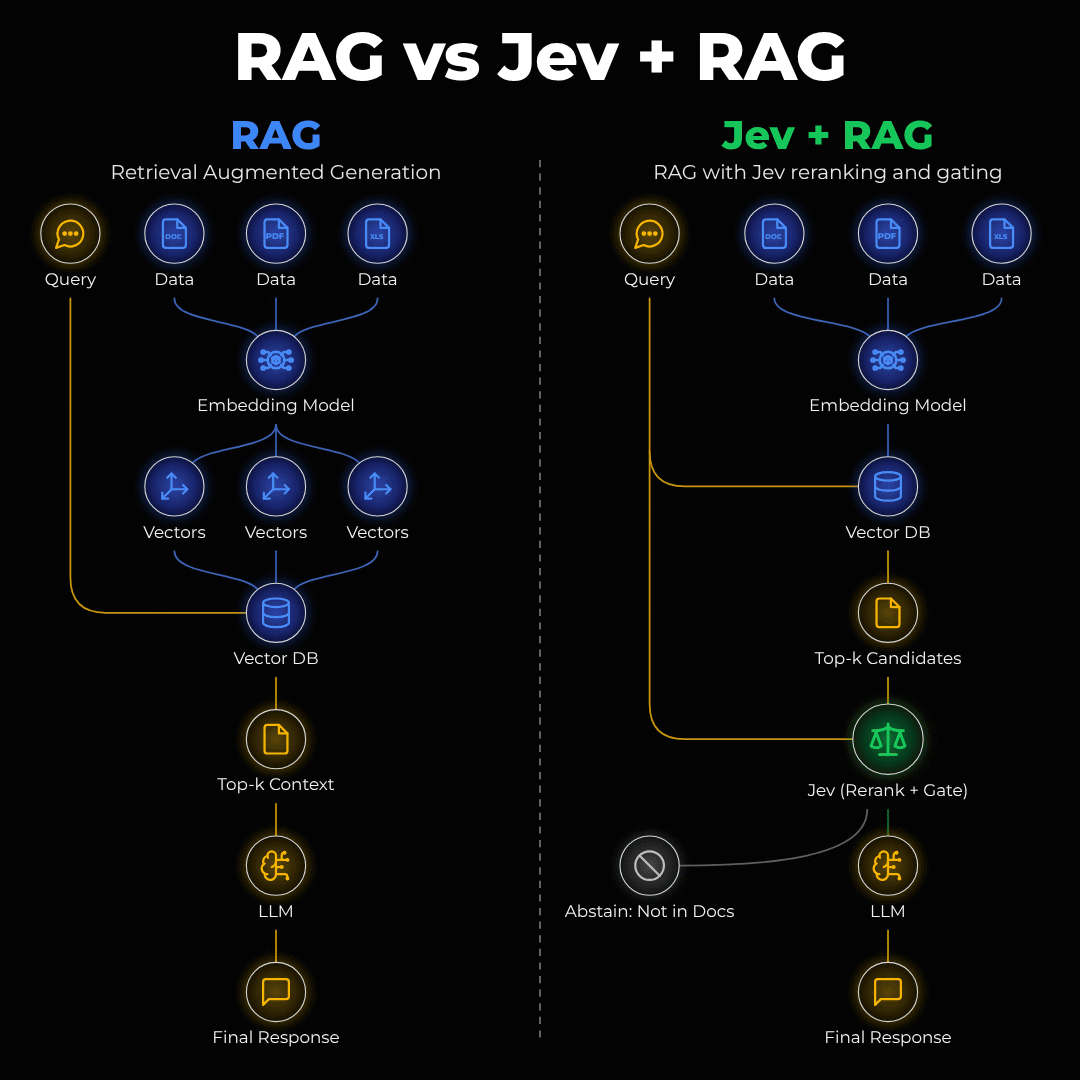
Liquid AIのd1-3B意思決定モデル、EmbeddingGemma 2、InsForgeでエージェント型RAGサポートデスクを構築する。d1-3Bは通過文を再ランクし回答可能性を判定する。
なぜ重要か
意思決定ゲートは4種類の質問すべてで最高精度となり、画像のみの質問でも性能を維持した唯一のパイプラインだった。意思決定モデルが視覚的に証拠を判断できる可能性を示す。
こういう要約が、毎朝あなたのメールに届きます。
このチュートリアルは、意思決定モデルをエージェント型RAGの2つの課題の解決策として位置づけている。取得した証拠が不十分な時点を把握することと、その判断に基づいて行動することだ。生成モデルと異なり、意思決定モデルは関連度スコアや確率といった構造化された判断を返し、アプリケーションはそれを使って応答を生成したり人間にエスカレーションしたりする。
構築では、バックエンド、データベース、認証、人によるレビューのワークフローにInsForgeを、マルチモーダル埋め込みにEmbeddingGemma 2を、通過文のスコアリングと回答可能性の評価にLiquid AIのd1-3Bを使う。Lightning AI StudioのFastAPIサーバーが埋め込みモデルと意思決定モデルをホストし、両モデルはNVIDIA L4 1基に収まり、GPUメモリを約7.2 GB使用する。
評価では4つのケースにまたがる75件のラベル付き質問で3つのRAGパイプラインを比較した。意思決定ゲートは最高精度で、画像のみの質問でも性能を維持した唯一のパイプラインだった。一方、BGEリランカーは誤答を避けたものの画像ベースの質問を苦手とし、その大半をエスカレーションした。これは意思決定モデルが通過文のランク付け以上のことができることを示唆する。視覚的な証拠が回答を支えるかどうかも判断できるのだ。ただし結果は単一のチュートリアル試験によるものだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Agentic AI Foundationが寄贈された4プロジェクト—OpenAIのOpen Responses、AnthropicのAgent Skills、Hugging FaceとAlibabaのOpenEnvとO…
Microsoftは、2021年から活動するStorm-0940が9月頃からオープンソースのARTEXフレームワークを使い、航空宇宙や金融、政府、半導体など数百組織への攻撃を自動化し始めたと述べた
SCSK顧問の室脇慶彦氏は寄稿で、Anthropicが2026年4月に公表した未公開のClaude Mythos PreviewがOSやブラウザの深刻な脆弱性を数千件発見し攻撃コードを人手なしで書いた件を挙げ、重要システ…
サイバーセキュリティ企業が米国の地元ニュースサイトを装うAI生成ウェブサイトを数千件発見した
Google FlowはGemini Omni、Veo、Nano Bananaを1つのWebアプリにまとめ、初心者でもチャットで絵コンテを作り、各短いクリップを生成してタイムライン上でつなげられる
Microsoftは2026年9月、CopilotがChat、Cowork、Code、Autopilotを1つのインターフェースに統合したと発表した