何が起きたか
Sentence Transformers v6.0が4つ目のモデルタイプ「MultiVectorEncoder」を追加し、ColBERT方式の後期相互作用検索に対応。このマルチベクトルモデルのファインチューニングが可能になり、新規のゼロからの学習にも対応する。
なぜ重要か
ドメイン固有のデータでマルチベクトルモデルをファインチューニングすると、検索精度が大幅に向上する。941トークンからなる医療評価データでは、多くの事前学習モデルの切り詰め処理により、NDCG@10で最大0.24の損失が発生する。また、「-unsupervised」チェックポイントは完成済みのモデルより適応性が高いため、事前教師あり学習済みのチェックポイントから始めるのが推奨される。日本国内の医療情報検索システムを開発する企業は、自社データでの調整により検索精度向上を図れる可能性がある。
注目点
単一のRTX 3090で14.5時間かけて学習したファインチューニング済みモデル(multi-vector-encoder/mLateOn-medical)は、医療評価で汎用検索モデルすべてを上回る性能を示した。訓練パイプラインは「pip install -U "sentence-transformers[train]"」で試せる。
こういう要約が、毎朝あなたのメールに届きます。
今回のアップデートは、検索分野でよくある問題に対処している。多くの公開モデルは長い文書を切り詰めて処理するため、平均941トークンの医療文書ではNDCG@10で最大0.24の損失が生じる。自前のマルチベクトルモデルを学習すれば、データに必要な文書長を設定でき、この静かな損失を回避できる。 著者の実験では、汎用検索でファインチューニングされていない「-unsupervised」チェックポイントが、完成済みモデルより新しいドメインへの適応に優れていることが示された。後期相互作用の構造を保持しつつ、ドメイン学習が打ち消す必要のある汎用チューニングを経ていないためだ。gte-modernbert-baseのような強力なバックボーンへの新規プロジェクションでも既存チェックポイントにほぼ匹敵し、有力な代替策となる。 実用的には、チームが単一GPUで数時間以内にドメイン特化型検索モデルを構築できるようになり、大規模なリソースは不要になる。提供されたトレーニングパイプラインで手順が簡素化され、控えめな学習でも特定ドメインで汎用検索モデルをすべて上回れることが評価で実証されている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
NVIDIAは2026年9月21日、「AIセキュリティは工学の問題――エージェントスタックの全層で解決する方法」と題したブログ記事を公開し、判断を誤ったエージェントでも行動を止められる理由を説明した

検証では、Haiku 5.5はmedium設定で定型文書ならSonnet 5.5に近いスコアを約1/17のコストで出したが、英語メール課題では6.3点まで落ちた

Black Forest Labsが2026年10月15日、FLUX 3 Image Kleinをオープンウェイトとして公開した

Metaは8160億パラメーターのオープンウェイトモデルMuse Spark Openを公開
PrismMLは2026年10月15日、Ternary Bonsai 2の2B・4B・9Bを公開した
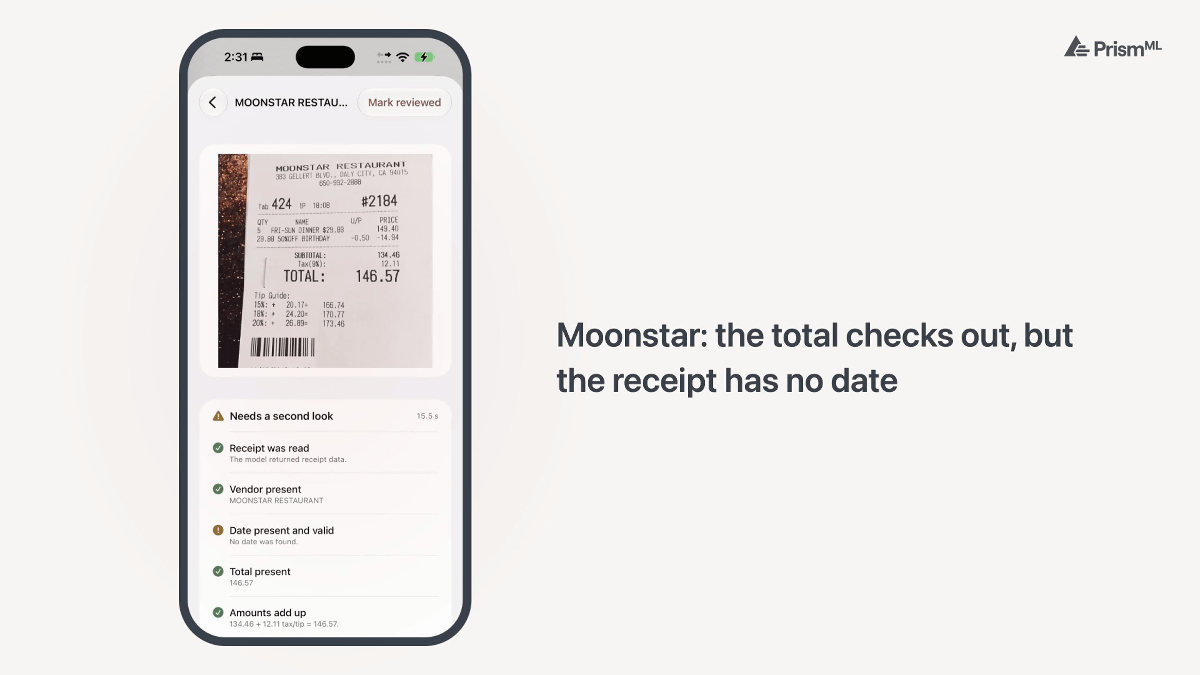
EC自動化工房がZenn記事で商品マスタ生成前クレンジング手順を示した


