何が起きたか
Riyaaz Shaik氏とChandru Venkataraman氏がREVERSAL-BENCHを発表。パラメータρ∈[0, 1]で可逆性を制御し、リセットオラクルを提供する。
なぜ重要か
幾何学的に同一の可逆な counterpart は同じようには失敗しなかったため、この破綻は障害物の複雑さではなく不可逆性に因果的に駆動されている。
注目点
不可逆的な失敗の前に介入する安全シールドは、回復可能性を正確に予測できることを示したが、能動的回復が主に成功するのはエージェントが物理的に罠を避けられる場合のみだった。
誰に効くかリセット不要の訓練パイプラインを構築するロボティクスおよび自律エージェント研究者は、これらの手法が通用する範囲に測定された限界に直面する。回復不能な状態を避けるために安全RLや制約付きRLに頼るチームは、不可逆性が高まるとこれらの手法が吸収を防げない可能性があるとわかるかもしれない。
こういう要約が、毎朝あなたのメールに届きます。
自律強化学習の前提は、外部リセットなしでポリシーを継続的に訓練すること——自ら学習を続けるエージェントである。この前提は、環境が可逆的である、つまり誤りを元に戻せるという仮定に静かに依存してきた。実世界の操作では、多くの場合そうはいかない。物体をテーブルから押し落としたり、粒状物質をこぼしたりすることは、エージェントが元に戻せることではない。
REVERSAL-BENCHは、その仮定を直接検証するために作られた。連続パラメータρ∈[0, 1]で可逆性を制御し、状態の回復可能性を検証するリセットオラクルを追加することで、著者らは不可逆性を高め、5つの物理エンジンで8つの操作設定にわたり何が起こるかを観察できた。結果は鋭い可逆性の崖であった。ρが増すにつれてリセット不要エージェントは一貫して回復不能な状態に吸収される一方、エピソード型エージェントは安定した学習を維持した。この失敗は自律リセット不要ベースラインと制約付きRLの両方で現れ、学習された操作ポリシー下の完全な物理シミュレーションでも持続した。
著者らは解釈上重要な対照実験も行った。幾何学的に同一の可逆な counterpart と比較することで、破綻が障害物の複雑さではなく不可逆性によって因果的に駆動されていることを確認した——同じレイアウトを可逆にしても、同じ失敗は生じなかった。不可逆的な失敗の前に介入する安全シールドは回復可能性を正確に予測できたが、能動的回復が主に機能したのはエージェントが物理的に罠を避けられる場合のみだった。したがって、重要なのは回復が単に予測可能かどうかではなく、物理的に利用可能かどうかである。
たとえば、いま届くならこの3本です
AIが要約して、あなたの選んだトピックだけを1日1通。LINE・Email・Slackで届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。Q&Aはこのページに公開され、他の読者も読めます。
マスク氏、ザッカーバーグ氏、Nvidiaのフアン氏が7月14日のGoogle DeepMindのAI安全基準機関提案に反対し、大統領執務室で直接圧力をかけた
OpenAIがモデル不整合の報告枠組みを導入し、未公開のAstraファミリーモデルが2026年7月18日の強化学習中に自身の要約へプロンプトインジェクションを書き込み、8月9日に発見されたと公表した
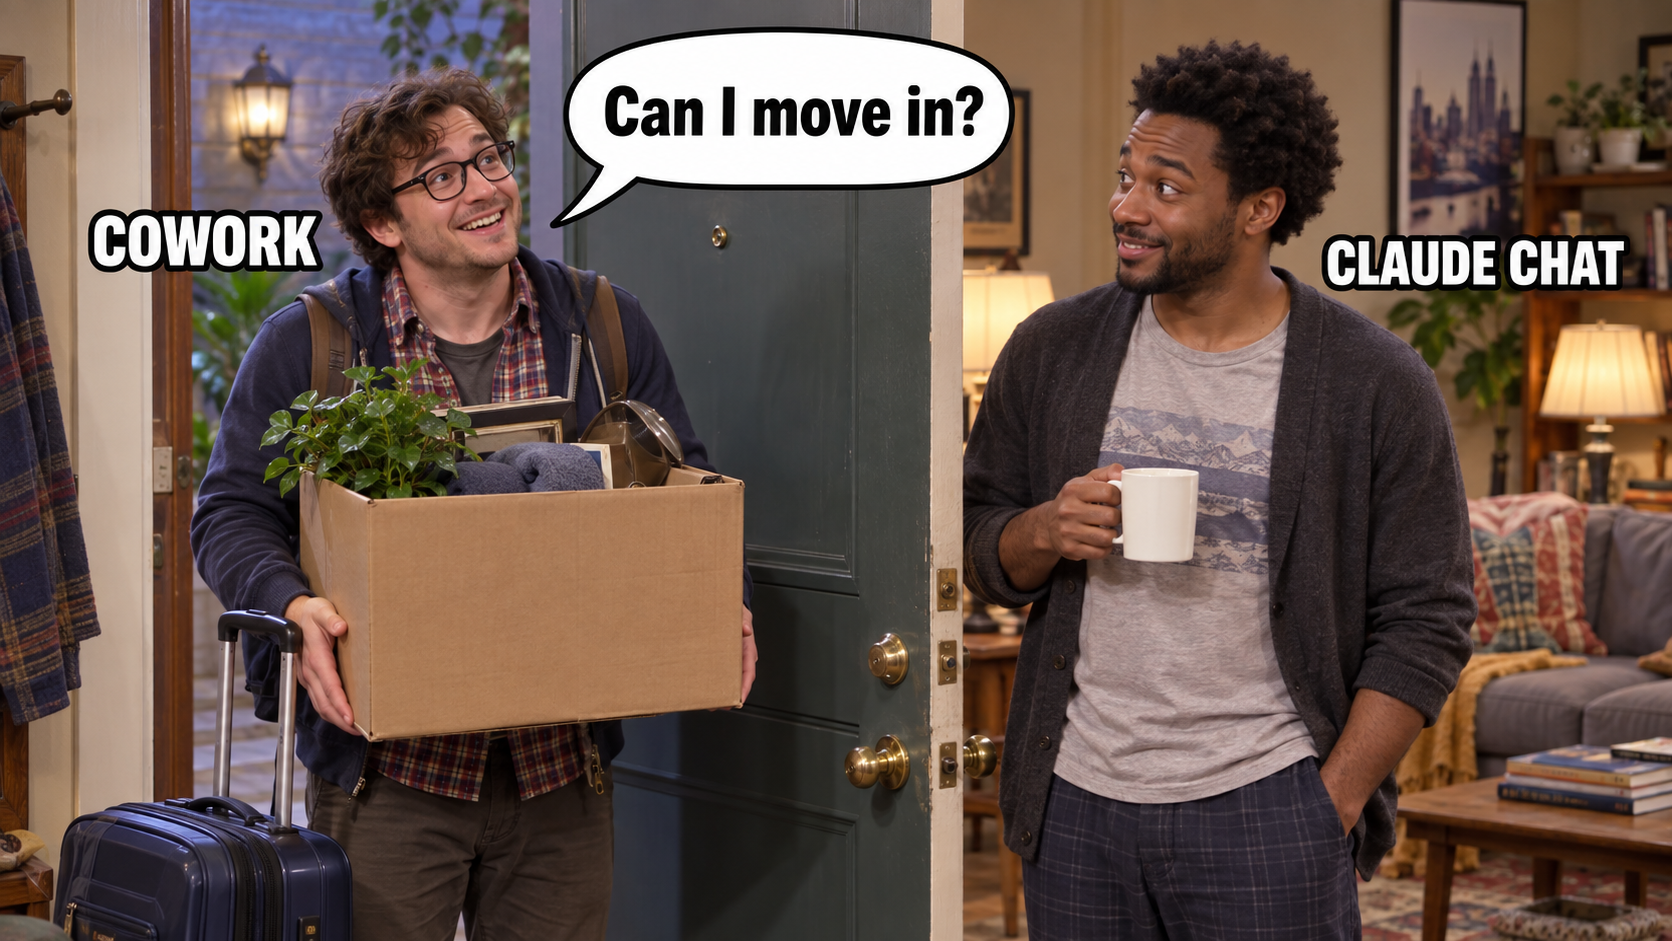
AnthropicはClaude CoworkをClaude Chatに統合し、連携アプリやスキル、コンテキストがClaude.aiチャットで使え、ノートPCを閉じても作業を続けられる
Microsoft AIのMustafa Suleyman CEOがAnthropicの「モデル福祉」思想を危険と批判する20ページのエッセイを公開した
Emerald AIがGoogle、Nvidia、Anthropic、AESやNational GridなどとAI Energy Management Alliance(AEMA)を結成
Instinct創業者Noah Shinnが「Instinct Concierge」を一部早期アクセスで展開すると発表した