何が起きたか
連載ガイドによると、TrialGPTは適格基準を87.3%の精度で判定し専門家の88.7〜90.0%に迫り、スクリーニング時間を42.6%短縮、LEADSは文献選定時間を20.8%削減した。
なぜ重要か
大規模言語モデルが専門家並みの精度に近づき治験チームの手作業削減につながる可能性があるが、厳格な検証、説明可能性、規制上の受け入れが必要だとガイドは指摘する。
こういう要約が、毎朝あなたのメールに届きます。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
匠技研工業は、取締役CBO原崇文氏が12月9〜10日に東京国際フォーラムで開催される「イプロスAI-産業World 2026」で「図面を渡すとAIが引合見積を作る」と題したセッションに登壇すると発表した
SOMPOホールディングスとNTTは11月11日、介護分野でのフィジカルAIの社会実装を目指すパートナーシップ協定を締結した
約8年のエンジニア経験(うちAI開発約3年)を持つ筆者は、競馬予測モデルは1つのツールに絞るよりCursor・Claude Code・OpenAI Codexで役割を分けるのが最適だと結論付けた
Meta HeroesがHERO AIVOを発表
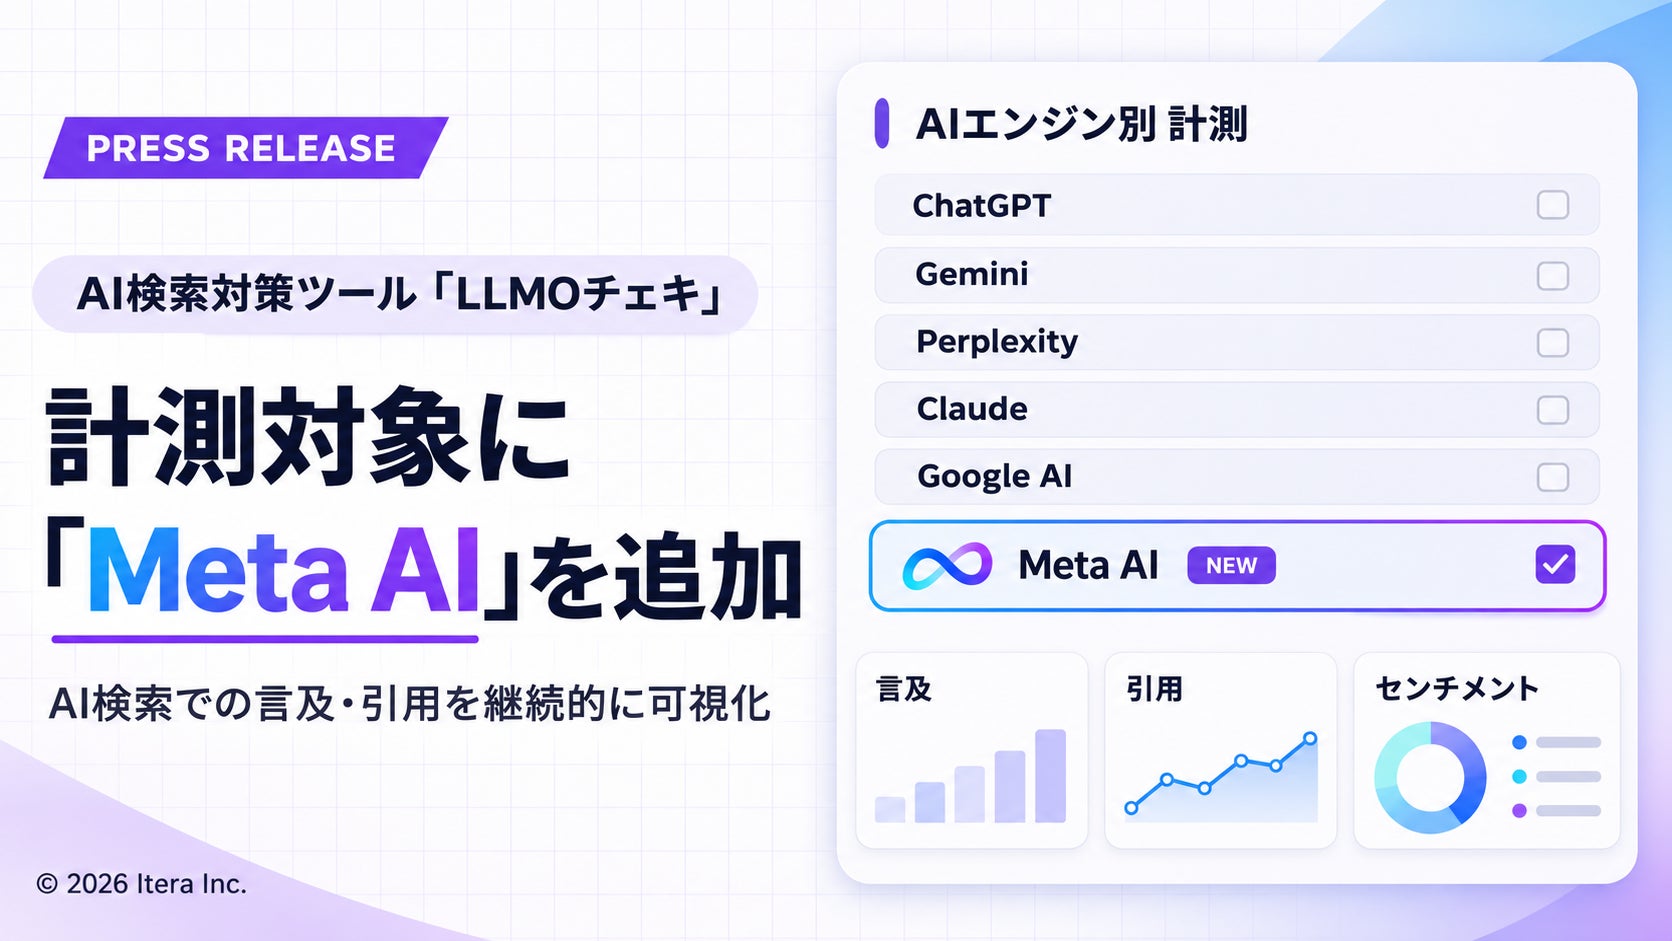
Iteraは2026年11月11日、AI回答でのブランド露出を追跡するツール「LLMOチェキ」にMeta AIを追加した
Notion Labsは11月9日、Fireworks.aiへの不正アクセスでNotion AIのInsights機能のチャット記録が漏えいの可能性があると発表