何が起きたか
50件の多言語推論テストでベースのGPT-OSS-20Bの指定言語推論は22%のみ。Amazon SageMaker HyperPodでのSFT後は100%、GRPOは62%から70%に向上。
なぜ重要か
SFTはモデルに欠けている行動を教え、GRPOは時々正しくできる行動を磨くだけ。回答言語は伸びしろがあったため改善し、既に最高精度だった領域ではGRPOに利得はなかった。
誰に効くか非英語ユーザー向けにオープンウェイトの推論モデルを導入するチーム—カスタマーサポート、現地語検索、多言語チャットなど—は、SFTで対象言語の推論を徹底させ、回答品質の改善余地があると評価が示した場合にのみGRPOを適用できる。
こういう要約が、毎朝あなたのメールに届きます。
ベースのGPT-OSS-20Bには強い英語の事前傾向がある。フランス語、ドイツ語、スペイン語、イタリア語で推論するよう求められても、それを認めた上で思考の連鎖を英語で生成してしまう。これはプロンプトの問題ではなく能力の欠如であり、SFTが任意ではなく必要だった理由でもある。50件のテストケース全体で推論言語の正しさを22%から100%へ引き上げた。
残った難点は最終回答だった。短く、英語の事前傾向が最も強い部分だ。SFTは回答言語の精度を62%にし、GRPOに明確な目標を残した。GRPOは推論を100%に保ったまま回答言語を70%に改善した。+8ポイントの利得は、モデルが既に時々出せていた行動を強化したことによる。
2つのタスクでのQwen2.5-7Bの対照実験がこのパターンを裏付けた。GRPOは伸びしろのあった多言語推論で+6ポイントを加えたが、既に90.5%だったGSM8Kでは利得がなかった。実務上の判断基準は、欠けている行動にはSFTを使い、望む行動が時々正しく、改善の余地があると評価が示した場合にのみGRPOを適用することだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
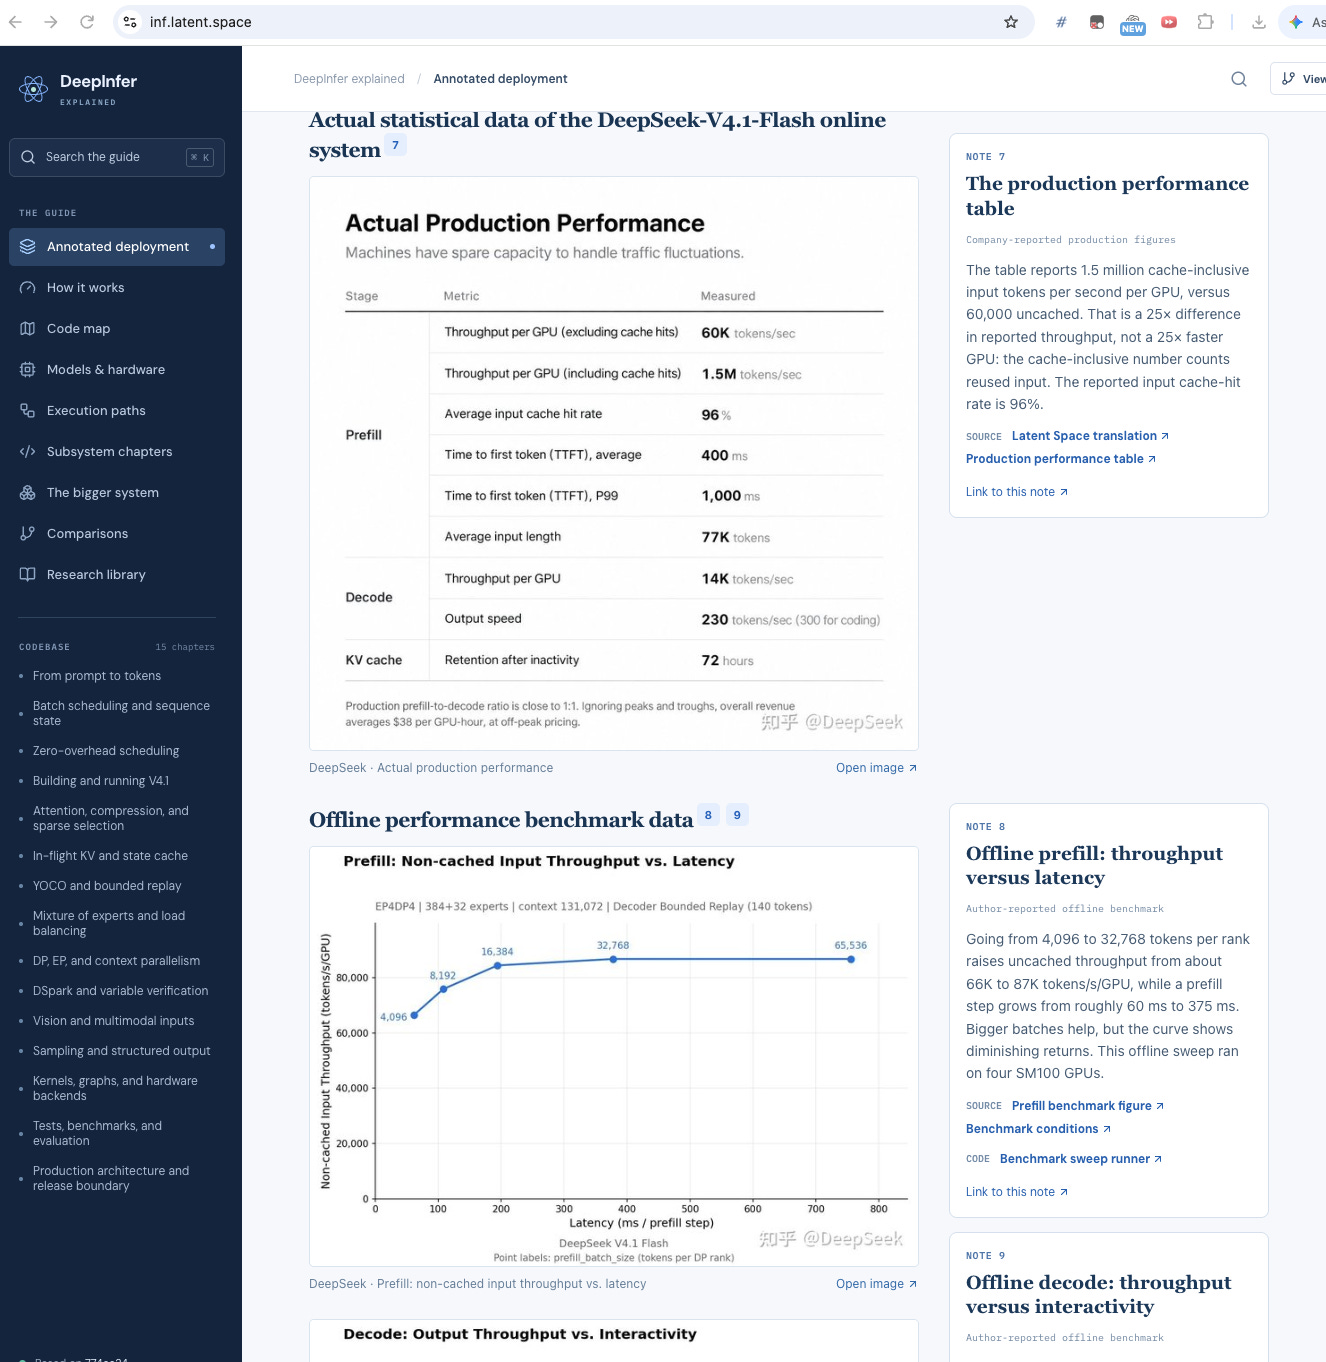
DeepSeekはV4.1-Flashを支える推論エンジンDeepInferを公開した
OpenAIは10月20日、Orchestra Bioを買収し、そのチームと創薬開発調整技術をRosalindに統合する
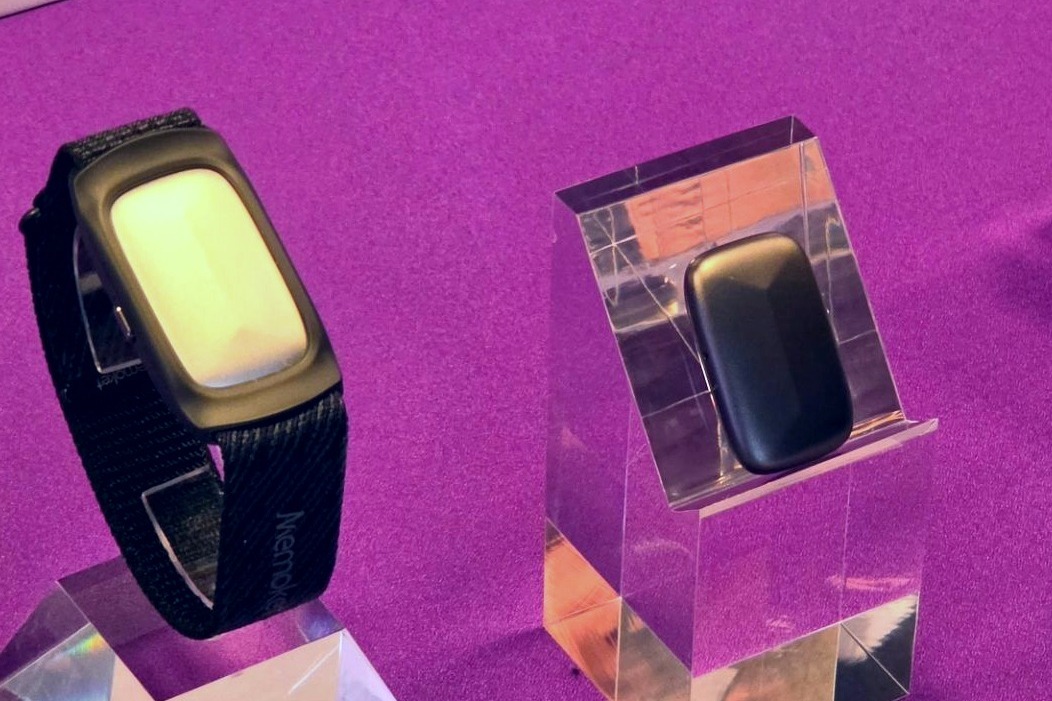
Memoketは21日、Apple Watchのバンドに装着する11gのAIレコーダー「Memoket Gem」を31,980円で発売した
Qwen/Qwen3-1.7Bのコピー100体にLoRAを付け、交叉と突然変異を10世代行う予備実験を実施

GoogleはPyTorchチームと共同開発したTorchTPUを発表
Clarocがcf.metaaiusercontent.comをパッシブDNSで検索し、会話タイトルがサブドメインにあるため6800件超のMuse共有リンクを発見