何が起きたか
GitHubのエンジニアリングブログが、LLMベースのシステムを本番投入する前に評価する方法を、シークレットスキャンの実例に基づいて公開。製品判断を起点にし、オフライン評価を統合テストと位置づけ、本番環境に近づけた形で行うことを重視している。
なぜ重要か
オフラインメトリクスは誤解を招く恐れがあると指摘。ベンチマークで優秀でも、実際の曖昧な入力には対応できないケースがある。精度を最優先に、再現率を安全制約とし、レイテンシーやコストといった運用上のガードレールで実験の継続可否を判断する。国内でLLM活用システムを本番投入する開発者らは、評価手法を再考する必要性が生じる可能性がある。
注目点
一度に変更する変数は1つに絞り、プロンプトや設定をバージョン管理し、モデル更新を定期的にテストすることを推奨。合成データでカバレッジの穴を埋める一方、本番に近いデータの代替にはならないとも述べている。
こういう要約が、毎朝あなたのメールに届きます。
この記事は、クリーンなベンチマークに頼って本番パフォーマンスを予測するというよくある落とし穴を扱っている。GitHubのシークレットスキャン事例は、実際の入力が曖昧であり、オフラインメトリクスが本番にそのまま反映されないことを示している。精度を優先して誤検知を減らしつつ、再現率を安全域に保ち、レイテンシーやコストといった運用上のガードレールを導入可否の判断に使う。
評価は統合テストに似た継続的プロセスと位置づけ、意味のある変更のたびに評価を再実行し、全設定を記録し、変数を1つずつ変えて改善要因を特定する。オフライン評価はコンテキストやフォーマットを含めて本番タスクを再現しないと、誤った確信につながるとも強調している。
さらに、本番ラベルを絶対的な真実とみなすことへの警告もある。ワークフローの結果が必ずしも真陽性とは限らないからだ。ギャップを埋めるため希少ケースで合成データを使うが、本番に近いデータの補完に留め、代替にはしない。全体として、LLM導入には製品起点の体系的思考が求められるとしている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Nvidiaが、Reflection AIの完全買収、出資比率引き上げ、または人材と技術ライセンスを取得するアクワイハイアのいずれかを視野に初期協議に入ったとFinancial Timesが報じた
Cerebras Systemsは、OpenAIのGPT-5.6 SolのUltrafastモードを支えていると発表した
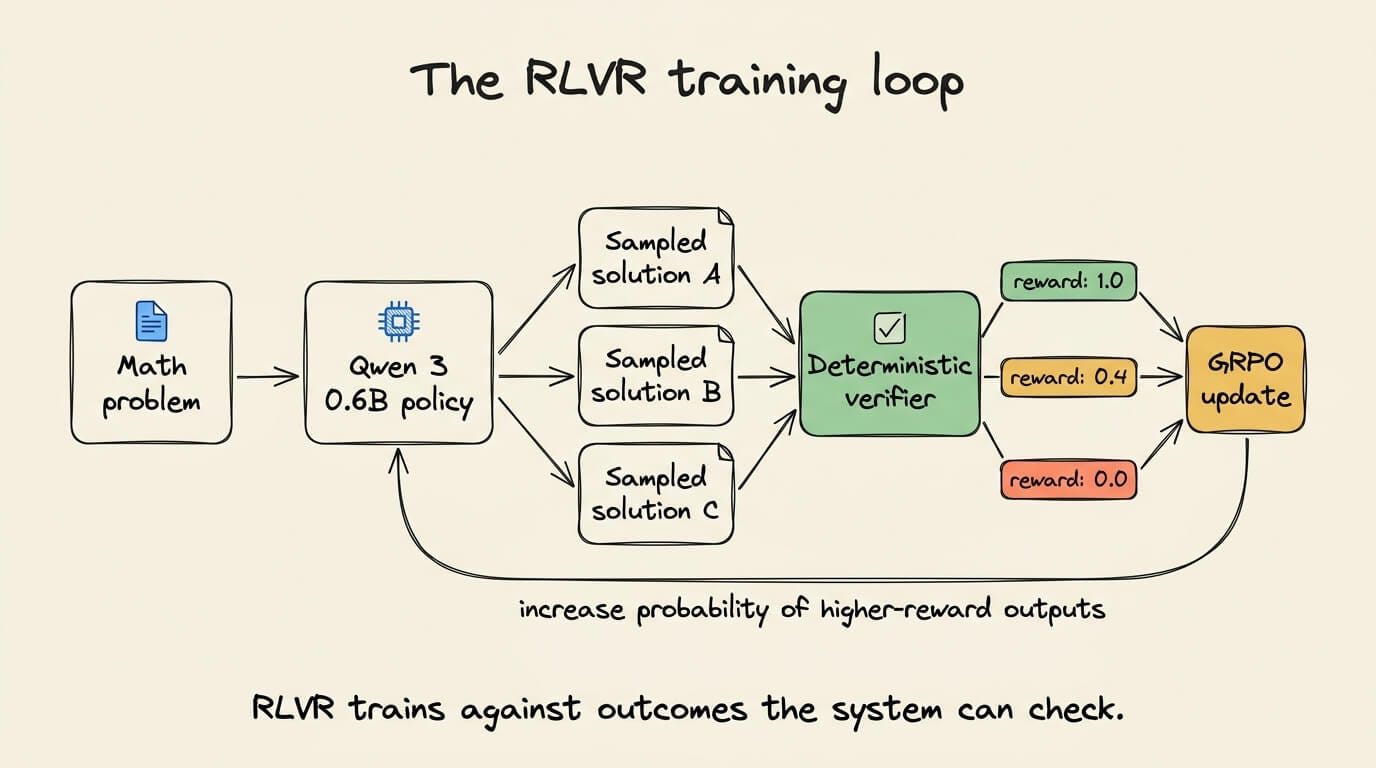
独自の4シグナル報酬(正確性0.6、解析可能性0.2、形式0.1、推論0.1)でQwen3 0.6BをSageMaker AI上のRLVRで訓練する
Claude Codeの2.1.294は、自然言語で書いたフックが拒否すべき操作を許可する反転を修正した

2026年10月7日〜9日、ChatGPT Pro(月額 200ドル)のdotsをGmail・Googleカレンダー・Googleドライブ・GitHub・Slack・Notion・Jira・Outlookにつなぎ、17項…
自称データアナリストがZennで、大規模言語モデルに過去の分析レポートや同種のデータ処理ワークフローを与えても、分析の最初の2段階であるデータ処理と集計しかカバーできないと論じた

