何が起きたか
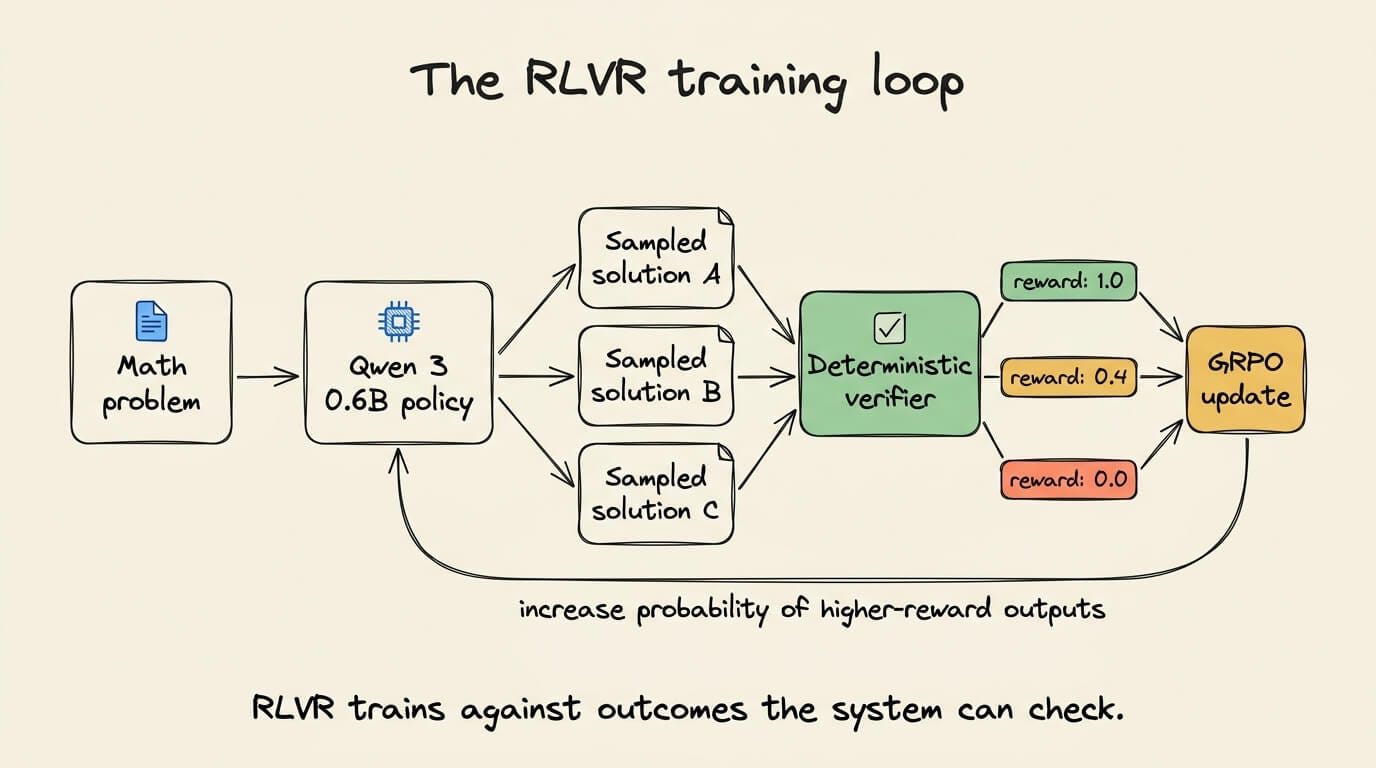
独自の4シグナル報酬(正確性0.6、解析可能性0.2、形式0.1、推論0.1)でQwen3 0.6BをSageMaker AI上のRLVRで訓練する。ベースMATH 0.406に対し後0.507。
なぜ重要か
報酬関数は実行可能なタスク仕様そのものだ。緩いパーサーや悪用可能な採点ルールは誤った行動を報酬を与えかねず、RLVRを導入するチームにはバージョン管理、テスト、指標ごとの監視が要るだろう。
こういう要約が、毎朝あなたのメールに届きます。
RLVRは、答えをコードで検証できる場合の実用的な選択肢だ。数学の問題なら検証器に必要なのは最終的な数値だけなので、推論の過程を整える必要はない。このウォークスルーが探るのはまさにその差だ。教師ありファインチューニング(SFT)は目標となる出力を必要とするが、RLVRは採点器さえあればよい。ここで使う手法であるGroup Relative Policy Optimization(GRPO)はDeepSeekMath論文で導入されたもので、サンプリングしたグループ内の相対報酬に基づいて更新することで、PPOで使う独立した価値モデルを不要にする。
具体的なトレードオフは、検証器がタスク仕様の一部になることだ。緩いパーサー、不完全なテストスイート、悪用可能な採点ルールは誤った行動に報酬を与えかねず、説明されているローカルテストが対象とするのは学習済みモデルではなく採点器だ。ウォークスルーの助言はここから導かれる。正確性とフォーマットを別々にグラフ化し、応答長が精度より速く伸びていないか注目し、報酬関数をテスト・バージョン管理・指標レベルの監視を備えたプロダクトロジックとして扱うことだ。
測定の話は訓練と同じくらい重要だ。ラボ自身のノートブックはベースモデルを評価していないため、1回の実行では前後比較の主張を支えられない。だからこそ参照比較(0.406から0.507)はAWSのペア成果物に帰属させ、正確な値は実行ごとに変わりうるという注意が添えられている。残りのSageMaker AIの操作は機械的だ。検証器をバージョン付きEvaluatorとして登録し、ml.g5.xlargeエンドポイントにデプロイし、ストリーミング経路が機能することを示す5プロンプトのスモークテストを実行する。ただしこのサンプルはスループットを特徴づけるには小さすぎる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Nvidiaが、Reflection AIの完全買収、出資比率引き上げ、または人材と技術ライセンスを取得するアクワイハイアのいずれかを視野に初期協議に入ったとFinancial Timesが報じた
Cerebras Systemsは、OpenAIのGPT-5.6 SolのUltrafastモードを支えていると発表した
Claude Codeの2.1.294は、自然言語で書いたフックが拒否すべき操作を許可する反転を修正した

2026年10月7日〜9日、ChatGPT Pro(月額 200ドル)のdotsをGmail・Googleカレンダー・Googleドライブ・GitHub・Slack・Notion・Jira・Outlookにつなぎ、17項…
CEOのBrian Chesky氏は、Airbnbが「AIネイティブ企業」になったと述べた
自称データアナリストがZennで、大規模言語モデルに過去の分析レポートや同種のデータ処理ワークフローを与えても、分析の最初の2段階であるデータ処理と集計しかカバーできないと論じた

