
何が起きたか
自称データアナリストがZennで、大規模言語モデルに過去の分析レポートや同種のデータ処理ワークフローを与えても、分析の最初の2段階であるデータ処理と集計しかカバーできないと論じた。
なぜ重要か
出来事を解釈し未知のデータから意味を再構成するという分析の核心はパターンマッチングに依存するため、模倣ベースのAIは新たな洞察ではなく過去事例の寄せ集めしか出力しがちだ。
こういう要約が、毎朝あなたのメールに届きます。
大規模言語モデルが普及するにつれ、AIにデータ分析を任せようとする試みが増えている。筆者によれば、最も一般的なアプローチは、過去の分析レポートや同種のデータワークフローを大量にモデルに与えて模倣させることだ。自らを現役のデータアナリストと称する筆者は、この方法では成功しないと考えている。
その論拠として筆者は、データ分析を3段階に分ける。データの処理と集計、データの解釈と可視化、データ点間の関係を見出して意味を再構成する段階だ。最初の2つは模倣が比較的うまく機能する領域だと筆者は言う。SQLの記述や定型のデータ変換はパターンが密接に一致するからだ。分析の核心である第3段階では過去事例が役に立たなくなり、出力は過去の例をつなぎ合わせたもっともらしい解釈になりがちだ。
筆者の説明によれば、大規模言語モデルは与えられた文脈から尤もらしい続きを生成する確率的な機械であるため、過去の成功は擬似的な帰納としてしか新しいデータセットに適用できない。本当の分析に必要なのは、なぜ起きたかについて仮説を立て、その仮説から意思決定へ至る論理の連鎖を組み立てることだと筆者は主張する。提案される解決策は、形式的・意味的・推移的の3つの妥当性基準を、分析全体の設計というマクロレベルと各推論ステップというミクロレベルの両方に適用することだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Nvidiaが、Reflection AIの完全買収、出資比率引き上げ、または人材と技術ライセンスを取得するアクワイハイアのいずれかを視野に初期協議に入ったとFinancial Timesが報じた
Cerebras Systemsは、OpenAIのGPT-5.6 SolのUltrafastモードを支えていると発表した
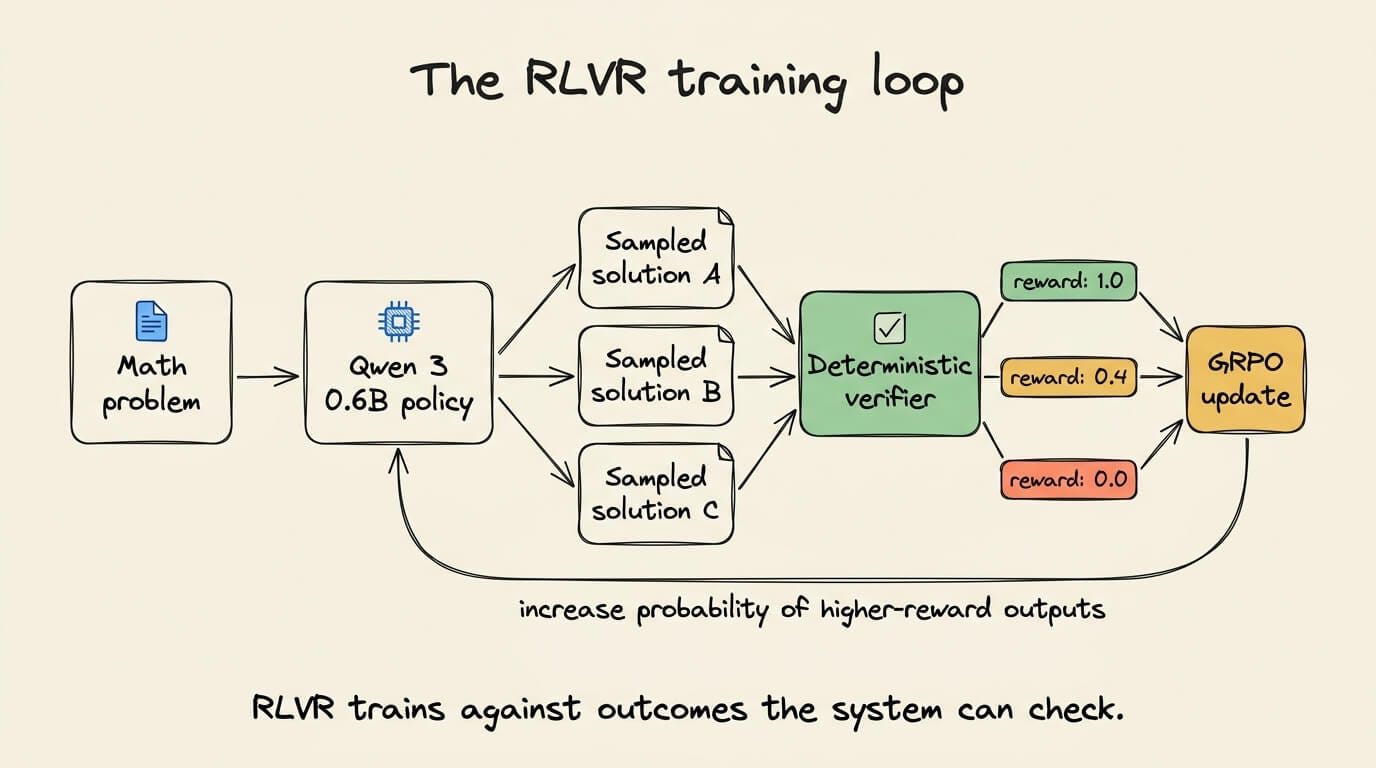
独自の4シグナル報酬(正確性0.6、解析可能性0.2、形式0.1、推論0.1)でQwen3 0.6BをSageMaker AI上のRLVRで訓練する
Claude Codeの2.1.294は、自然言語で書いたフックが拒否すべき操作を許可する反転を修正した
2026年10月7日〜9日、ChatGPT Pro(月額 200ドル)のdotsをGmail・Googleカレンダー・Googleドライブ・GitHub・Slack・Notion・Jira・Outlookにつなぎ、17項…
CEOのBrian Chesky氏は、Airbnbが「AIネイティブ企業」になったと述べた

